Muse Wonder は Opus 5.5 超えか?総合56対58、使えるプラン一覧
Meta の Muse Wonder Full は総合指数で Opus 5.5 に2点及ばず、コーディングの一部でのみ上回ります。API・Muse Code・アプリ別の使える場所と、日本からの利用条件を整理しました。

先に結論です。Meta の新しい上位モデル Muse Wonder Full は、総合の知能指数では Opus 5.5 に届いていません。56点対58点で、2点の差です。コーディングに限ると、どの物差しを使うかで上にも下にもなります。しかも Full が使えるのは Muse Code の上位2プランだけで、API から呼べるのは上位版ではない Muse Wonder のほうです。API の単価は Opus 5.5 と同額でした。
Meta が2026年10月12日に Muse Wonder と Muse Wonder Full を発表してから、「Opus 5.5 超え」という見出しが先に広がっています。ただ、見出しだけでは、総合でも上なのか一部だけなのか、Wonder と Full のどちらをどこから使えるのかが分かりません。そこが気になって、Meta の公式情報と Artificial AnalysisArtificial Analysis主要な AI モデルを同じ問題で採点し、賢さ・速さ・値段を比べて公開しているサイト。詳しく →(AI モデルを同じ条件で測って公開している第三者の分析サイト)の公開データを読み比べました。Muse Wonder を手元で動かした結果ではないことは、先にお断りしておきます。
Muse Code は Meta のターミナル型コーディングエージェントコーディングエージェントAI がファイルを読み書きし、コマンドを実行しながらプログラムを作る道具。詳しく →(ターミナル上で AI がコードを読み書きする道具)で、Muse Wonder は API のほかにここからも使えます。迷いどころは「総合では2点負けているモデルを、コーディング用に選ぶかどうか」の一点だと思います。Opus 5.5 側の設定ごとの違いは Opus 5.5をeffort別に比較:mediumは10.4秒で全673モデル中8位 にまとめてあるので、比べる相手の物差しとしてあわせてどうぞ。
「Opus 5.5 超え」は、総合とコーディングを分けないと読めない
「Opus 5.5 超え」という言葉は、総合の話なのか、コーディングの話なのか、特定の課題の話なのかを示していません。一つの数字で確かめようとすると、どこかで話がずれます。そこで、Artificial Analysis の Intelligence IndexIntelligence IndexArtificial Analysis が複数のテストの結果をまとめて出す、AI モデルの総合点。詳しく →(10の評価をまとめた総合指数)、同じサイトの Coding Agents IndexCoding Agents IndexArtificial Analysis が出している、AI にコーディング作業をさせた成績の指数。詳しく →(コーディング作業の成績)、Meta が自社の発表に載せた個別評価の表、の3つを分けて読みました。
分けたのは、測っている条件が違うからです。総合指数はモデルの素の力に近いものを見ようとします。Coding Agents Index のほうは、Muse Code や Claude CodeClaude CodeAnthropic が出している、AI にコードを書かせて実行まで任せる開発ツール。詳しく → という道具の上で動かした結果です。同じ「強さ」でも、道具が変われば数字の意味も変わります。
総合指数では Full は56点、首位の Opus 5.5 に2点届かない
Artificial Analysis の Intelligence Index v4.3(出典)では、Muse Wonder Full(max 設定)が56点、Muse Wonder が52点でした。前作の Muse Spark 1.3 は48点なので、Full は前作から8点伸びています。6週間で8点というのは、正直なところ勢いを感じる数字です。それでも首位は Opus 5.5(max 設定)の58点で、Full はそこから2点下にいます。
モデル単位で並べると、Full は Sonnet 5.5(max 設定)と同じ56点で、Opus 5.5 に次ぐ2位タイです。API で使える Muse Wonder の52点は、GPT-6 Astra や Fable 5.1 の53点より下になります。
中身を見ると、得意と不得意がはっきりしています。Terminal-Bench 4.0 は57%、GDPval-AA v2.1 は1857 Elo(対戦形式の相対評価点)で、Opus 5.5 の1866 と信頼区間の内側に収まります。ところが知識を問う AA-Omniscience は30で、Opus 5.5 の46を大きく下回ります。良い知らせもあって、幻覚率(事実と違う答えを返す割合)は33%から23%に下がり、指数45以上のモデルの中では2番目に低い水準です。
コーディングは物差ししだいで、上回る項目と下回る項目が混ざる
Coding Agents Index では、Muse Code に Muse Wonder Full を載せた組み合わせが68、Claude Code に Opus 5.5 を載せた組み合わせが66です。数字だけなら Full が2点上ですが、Claude Code に Sonnet 5.5 を載せた組み合わせも68で、同点です。道具そのものが違うので、「モデルとして Opus 5.5 より強い」と言い切れる数字ではありません。
Meta が発表に載せた表では、長く続くコーディング作業の指標で Full が上です。DeepSWE 1.1 は79.0対74.2、SWE-Marathon は57.5対46.3。DeepSWE の比較には、第三者(Datacurve)の計測とされる数字が使われています。一方で ProgramBench は59.0対70.5、Terminal-Bench 4.0 は57.1対59.6で、こちらは Opus 5.5 が上です。勝ち負けが混ざっていること自体が、この比較のいちばん大事な読みどころだと私は思います。
物差しごとに並べると、こうなります。
| 物差し | Muse Wonder Full | Opus 5.5 | 読み取り |
|---|---|---|---|
| Intelligence Index(総合) | 56 | 58 | Opus 5.5 が上 |
| Coding Agents Index(道具が違う) | 68(Muse Code) | 66(Claude Code) | Full が上。ただし Claude Code の Sonnet 5.5 も68 |
| DeepSWE 1.1(Meta の表) | 79.0 | 74.2 | Full が上 |
| SWE-Marathon(Meta の表) | 57.5(xhigh 設定) | 46.3 | Full が上。設定と道具が揃っていない |
| ProgramBench(Meta の表) | 59.0 | 70.5 | Opus 5.5 が上 |
| Terminal-Bench 4.0(AA) | 57.1 | 59.6 | Opus 5.5 が上 |
| AA-Omniscience(知識) | 30 | 46 | Opus 5.5 が上 |
表の数字は、同じ手順で測り直したものではない
この表は、すべてを同じ手順で揃えて測り直した比較ではありません。Meta の model card(モデルの評価条件をまとめた公開資料)を読むと、競合の数字の集め方が書いてあります。競合は max 設定で比べられていて、第三者や提供元の公表値があればそれを、なければ社内計測・自己申告・公式リーダーボードのうち最も高い値を使っています。社内で回した競合の数字には「最適化されていない可能性」がある、とも明記されています。SWE-Marathon については、Full だけ xhigh 設定で、道具もそろっていないと model card 自身が書いています。
つまり Full も Opus 5.5 も、項目ごとに数字の出所(第三者・提供元・Meta の社内計測)が違います。この前提を外したときに差がどう動くかは、公開情報からは確かめられません。なので、そこは断定しないでおきます。
Wonder は API・OpenRouter・Muse Code と米国の Muse アプリ(順次)、Full は Muse Code の上位2プランだけ
使える場所はこう広がっています。Muse Wonder は Meta Model API、OpenRouterOpenRouter多くの会社の AI モデルを、1つの窓口と1つの請求でまとめて使えるサービス。詳しく →、Muse Code の全プラン、それに Muse アプリの有料購読者から順次。Full は API にも OpenRouter にもなく、Muse Code の Power Usage と Maximum Usage の2プランだけです。ややこしいのは、Muse アプリの有料プランと Muse Code の上位プランの名前が似ていることで、両者は別の購読です。混同しないように見てください。
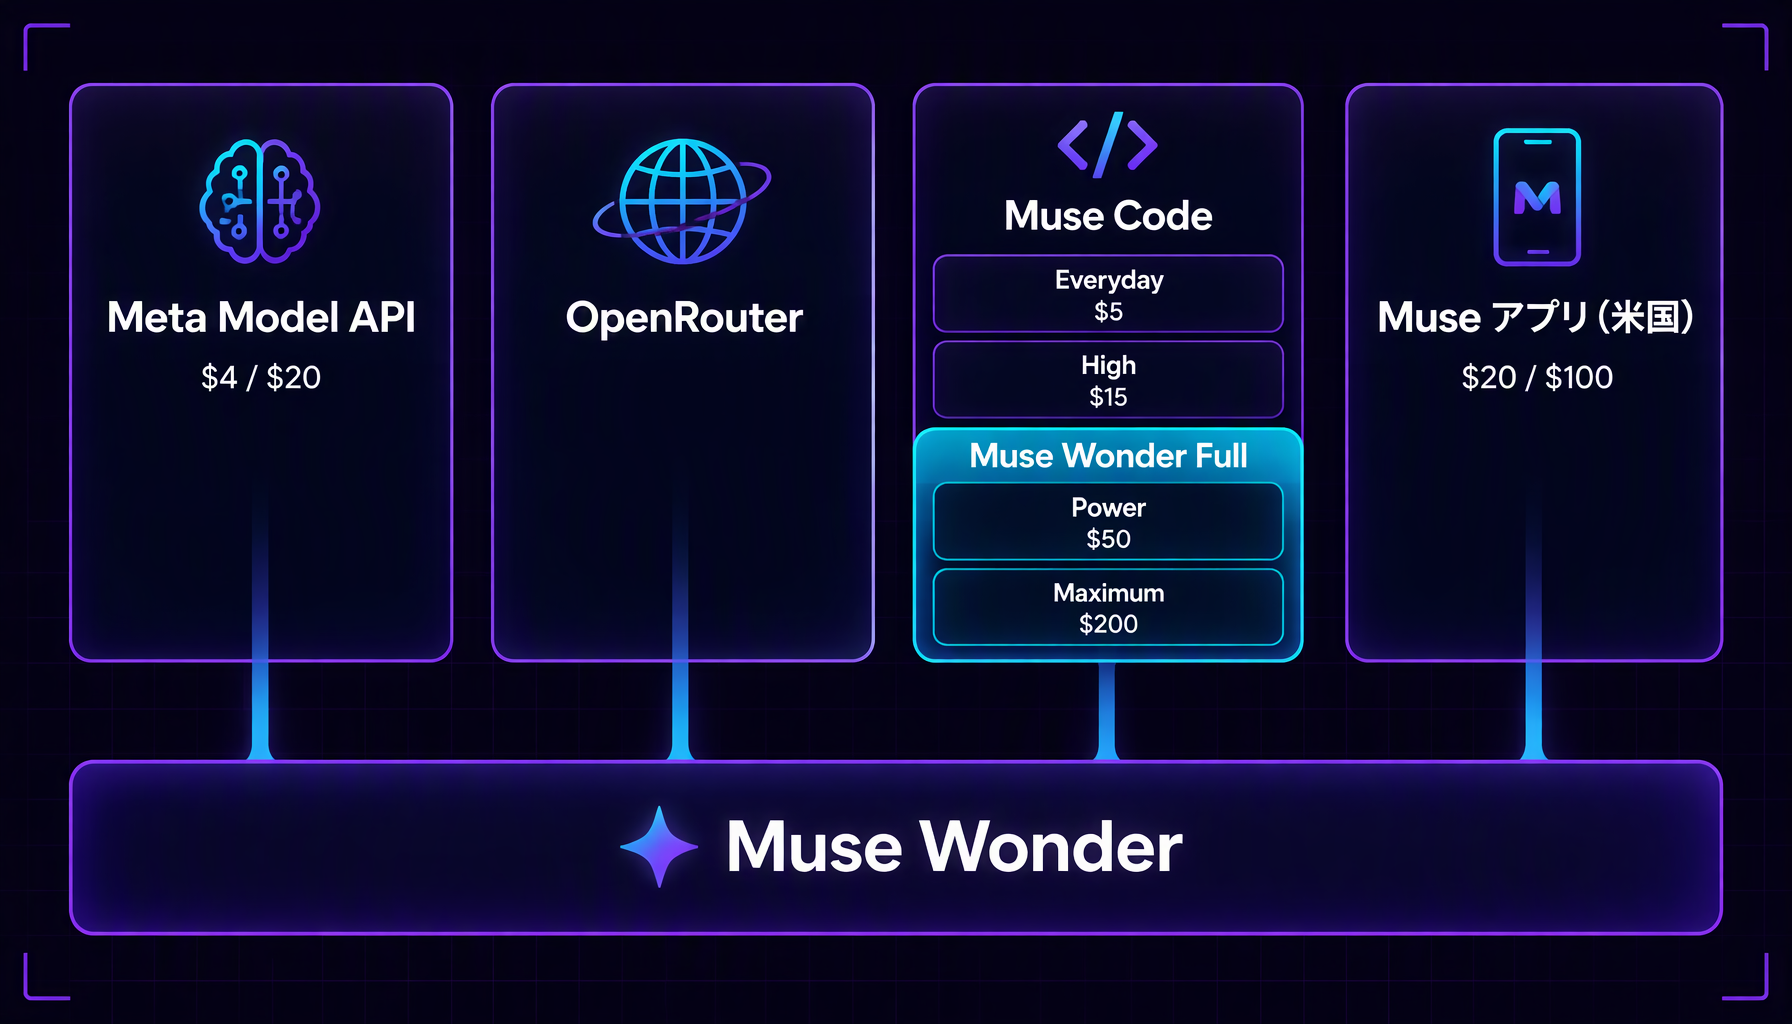 Wonder は API・OpenRouter・Muse Code と米国の Muse アプリ(順次)から、Full は Muse Code の上位2プランだけ
| 使える場所 | Muse Wonder | Muse Wonder Full | 料金(公表・報道ベース) | 学習への扱い |
|---|---|---|---|---|
| Meta Model API | 使える | 使えない | 入力100万トークントークンAI が文章を読み書きする時の、文字を細かく区切った単位。料金もこの数で決まる。詳しく → $4、出力 $20(キャッシュ入力 $0.20) | Standard mode のみで、学習には使われない |
| OpenRouter(meta/muse-wonder) | 使える | 使えない | 入力 $4、出力 $20 | 記載を確認していない |
| Muse Code | 全プランで使える | Power Usage($50)と Maximum Usage($200)で使える | Everyday $5、High $15、Power $50、Maximum $200 | サブスクサブスク(AI の定額プラン)月額料金で、決められた上限まで AI を使える契約。詳しく →は既定で Contributor mode |
| Muse アプリ | 有料購読者から順次 | 記載を確認していない | 無料+Power $20、Maximum $100(二次報道) | 記載を確認していない |
API の単価は Opus 5.5 と同額なので、乗り換えを考えるときは、性能の差と単価の差を分けて見られます。呼び出しは OpenAI 互換の形式で(base_url は api.meta.ai/v1)、Anthropic SDK の形式でも呼べると案内されています。長文に対する追加料金はなく、チーム単位の上限は3,000 RPM と4M TPM です。
Muse アプリは無料のまま使えますが、Wonder は有料プランの購読者から順次展開されている段階です。二次報道によると、有料プランは月20ドルの Power と月100ドルの Maximum で、対象は米国の18歳以上とされています。Meta の公式料金ページは、この記事を書いた時点では確認できていません。
Meta の他のサービスとのつながりは、今のところ発表がありません。WhatsApp・Instagram・Meta AI・Ray-Ban のメガネに Muse Wonder を載せるという案内は、公式発表にも開発者向けの資料にも見当たりませんでした。AWS Bedrock・Azure・Google Vertex といった大手クラウド経由の提供も記載なしです。重みを公開するオープンモデルでもありません(Meta のオープンモデルは別系統の Muse Glimmer です)。今のところ、入口は Meta 自身の API・Muse Code・Muse アプリと、OpenRouter に限られます。
1タスクの費用は Opus 5.5 より安いが、最初の1文字まで19.27秒待つ
Artificial Analysis の測定では、Muse Wonder の1タスク費用は4.52ドルで、Opus 5.5 の5.98ドル、Sonnet 5.5 の5.46ドルより低い結果でした。内訳は入力が3.43ドル(76%)、出力が1.08ドルで、費用のほとんどは入力です。1タスクあたりの入力トークンは約769万、出力は約5万4千。Full は従量課金ではないので、同じ方法での費用は出ていません。
速さのほうは、出力が毎秒87.9トークンでした。気になったのは、最初の1文字が出るまでの時間で、19.27秒(中央値は5.52秒)です。流れ出してからの速さより、最初の反応までの待ち時間のほうが目立ちます。
日本からは API と OpenRouter なら使える見込み、Muse アプリは今のところ米国向け(二次報道)
利用禁止国の一覧に、日本は入っていません。Geographic Use Policy は2026年10月12日に更新されていて、その時点の制限地域に日本は含まれていません。ただし Meta は、提供を有効にした地域でだけサービスを開く仕組みで、国別の対応表は公開されていません。サブスクリプションの特典も地域によって違い、加入前の画面で表示されます。
なので API や OpenRouter は、制限国ではないという意味で日本から使えると読めます。実際の申し込み画面での表示までは、まだ確認していません。Muse アプリは二次報道の範囲では米国限定なので、今は対象外と読んでおくのが安全です。
Muse Code は申し込む前に、既定の Contributor mode を確かめる
⚠️ Muse Code のサブスクリプションでは、既定で Contributor mode が有効になっています。このままだと、入力・コード・出力が Meta の学習に使われます。オフにはできますが、効くのはオフにした後の送信分だけで、それ以前に送った分には及びません。仕事のコードを扱うなら、申し込みの前にこの設定を見ておいてください。
申し込む前に、次の4点を見ておくと安心です。
- 申し込み画面で、日本から表示されるプランと特典を確認する
- Muse Code のサブスクは既定で Contributor mode なので、扱うコードの内容に合わせて切り替えを決める
- API を選ぶ場合は、Standard mode で学習に使われないことを確認する
- Full を選ぶなら、Power Usage と Maximum Usage のどちらが必要かを作業量から決める
Full を試すかどうか(ここからは私見)
ここからは私見です。公開データからの推測を含むので、事実としては読まないでください。
知識系の作業を中心に選ぶなら、今の数字では Opus 5.5 を選ぶ理由が残ると思います。AA-Omniscience の差(30 対 46)は、知識を問われる場面で出やすい差ではないかと見ています。ここは確認していません。
Muse Code でコーディング作業を回す人にとっては、Full の DeepSWE と SWE-Marathon の数字は試す価値のある材料です。ただ、それは Meta が公表した条件での数字で、自分のリポジトリで同じ差が出るかは別の話です。迷うとしたら、「Muse Code の上位プランを払って Full を試すか、API で Wonder を先に見るか」の二択になると思います。
使い方でも効き方が変わりそうです。入力が費用の大半を占めるので、長い資料やコードベースを何度も読ませる使い方では、単価の差より入力量の多さが効いてくるかもしれません。対話しながら指示を出す作業なら、最初の1文字まで19.27秒という待ち時間のほうが、費用より体感に響きそうです。
前作から8点伸びた勢いには、次の版への期待も持ちます。ただ、この伸びが次も続くかどうかは、今の情報では分かりません。
数字を自分で確かめるなら、Artificial Analysis のリーダーボードで、ご自身が使う予定の設定(max か xhigh か)の行を見てください。そのうえで、実際に扱う作業に近い指示を2つのモデルに同じ条件で出してみると、総合指数とは違う差が見えてくるはずです。
参考リンク
- Muse Wonder and Muse Wonder Full: a material jump in intelligence(Artificial Analysis)
- Introducing Muse Wonder and Muse Wonder Full(Meta 公式発表)
- Muse Code の購読プラン(Meta 開発者サイト)
- Geographic Use Policy(Meta 開発者サイト)
- Muse Wonder Model Card(Meta、PDF)
- Full が API で使えないことの報道(VentureBeat)
- 数値の出典: Artificial Analysis(2026年10月13日取得)
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事

Muse Spark 1.3とGLM-5.3-Flash、知能4点差で単価6倍
Muse Spark 1.3のStandardとContributorを、GLM・Qwen・Geminiと知能、単価、速度、データ条件で比較します。
単価は同じでもxhighの評価費用は約7倍:Sonnet 5.5とGPT-6.1 Sol
同じ入力$2・出力$10でも、xhighのAA評価費用は約7倍。速度・賢さの天井・出力トークンから使い分けを判断します。
高性能でも負けるArgon——Terminal-Bench 57.1%、Claude Sonnet 5.5は63.6%
Gemini 4 ArgonをArtificial Analysisの数値で検証。Claude Code・Codex利用者が乗り換える必要があるか、提供範囲と費用も含めて判断します。

Claude Haiku 5.5 vs GPT-6 Luna、同額で替える価値はあるか
Claude Haiku 5.5 は GPT-6 Luna と同じ単価で、同じ設定どうしの総合点は上回りました。速さの内訳と、定額プランのまま自作の仕組みに組み込んだときのつまずきを実測で書きます。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:開発環境・キャリアまわりのサービス
 シンVPSを見る
 XServer VPSを見る
 strategy career の転職支援を見る