Claude Haiku 5.5 vs GPT-6 Luna、同額で替える価値はあるか
Claude Haiku 5.5 は GPT-6 Luna と同じ単価で、同じ設定どうしの総合点は上回りました。速さの内訳と、定額プランのまま自作の仕組みに組み込んだときのつまずきを実測で書きます。

私は自作のハーネスハーネスAI モデルに道具や手順を与えて、仕事として動かすための外側の仕組み。詳しく →(AI に決まった手順で仕事をさせるための自前の仕組み)に、約3万4千字ある長い実験メモを、読める日本語の解説文にまとめさせる仕事を組み込んでいます。そのまとめ役を、10月7日に出た Anthropic の小型モデル Claude Haiku 5.5 に替えました。これまでの Haiku は値段が高く、安い仕事は GPT-6 Luna(OpenAI の安い小型モデル。以下 Luna)か中国の格安モデルに回していたので、正直「やっと来たか」という気持ちです。
先に答えを書くと、待ち時間を許せる長文のまとめ役なら、Haiku 5.5 は替える候補に入ります。値段は Luna とまったく同じ単価で、賢さの総合点は同じ設定どうしならどの段でも Luna より上でした。ただ、格安帯のいちばん上ではありません。少し高い MiMo-V2.6-Pro(46.3)には、Haiku 5.5 の最高設定(43.4)でも届きません。それに、1件を仕上げるのに約3分かかります。大量に並列で回す仕事や、すぐ返事が欲しい仕事には、今の格安モデルのほうが合います。
数字はモデル比較サイト Artificial AnalysisArtificial Analysis主要な AI モデルを同じ問題で採点し、賢さ・速さ・値段を比べて公開しているサイト。詳しく →(以下 AA)の表から取り、efforteffortAI にどれだけ考えさせるかの段階設定。上げるほど賢く、遅く、高くなる。詳しく →(どれだけ考えさせるかの設定)が同じものどうしで比べます。ただ、AA の点数は日本語のまとめ力を測ったものではないので、手元でも同じ指示文を Haiku 5.5 と、それまで使っていた GPT-5.6 Luna に渡して読み比べました。
同じ値段・同じ設定なら、Haiku 5.5 はどの段でも Luna より賢い
AA は、同じ effort 設定の Haiku 5.5 と GPT-6 Luna を並べて公開しています。以下は2026年10月8日に取得した数字です。
| 設定(effort) | Haiku 5.5 の総合点 | GPT-6 Luna の総合点 | Haiku 5.5 の出力速度 | GPT-6 Luna の出力速度 |
|---|---|---|---|---|
| Max | 43.4 | 38.1 | 239 | 127 |
| Xhigh | 41.2 | 34.6 | 190 | 126 |
| High | 37.8 | 32.9 | 139 | 118 |
| Medium | 34.5 | 29.9 | 137 | 未計測 |
出典: Artificial Analysis(https://artificialanalysis.ai/)。出力速度の単位(tok/s)は次の節で説明します。
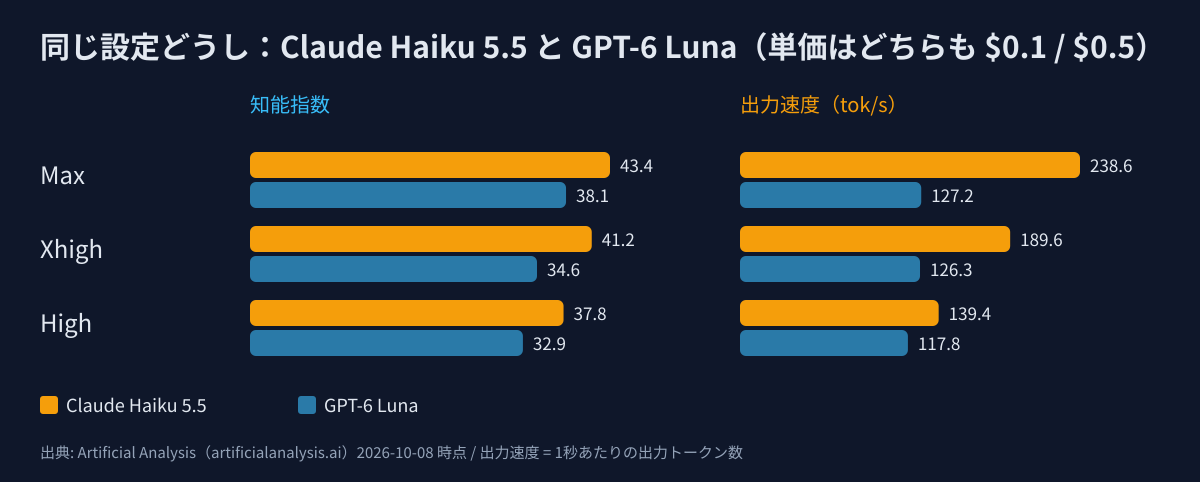
総合点は、AA が Intelligence IndexIntelligence IndexArtificial Analysis が複数のテストの結果をまとめて出す、AI モデルの総合点。詳しく → と呼んでいる、知能の総合的な採点です。Max 同士で 43.4 対 38.1、Xhigh 同士で 41.2 対 34.6、High 同士で 37.8 対 32.9。どの段でも Haiku 5.5 が上でした。
値段のほうも見ておきます。単価は、文章を細かく区切った単位(トークン)を100万個使ったときの料金(ドル)です。一つ前の Haiku 4.5 は入力 $1・出力 $5 でしたが、Haiku 5.5 は入力 $0.1・出力 $0.5 で、10分の1になりました。Luna も $0.1 と $0.5 なので、一円の差もない同じ価格帯です。関連記事として GPT-6 Solは買い替えか?GPT-5.6と同じ賢さでAPI半額 もあわせてどうぞ。
ただし、この「上」は段をそろえて読んだ場合の話です。Haiku 5.5 の High(37.8)は、中国の格安モデル GLMGLM中国 Z.ai(旧 Zhipu AI)の AI モデルの系統。詳しく →-5.3-Flash(Z AI のモデル。後の節で並べます)の 41.8 を下回ります。設定を外して「Haiku 5.5 が上」とは言えません。
もう一つ、単価が同じでも、考える量を増やせば使うトークンはそれだけ増えます。AA の公開データには評価で使った量や費用が載っていないので、単価だけで「安く上がる」とは言い切れません。
文字が出るのは速い。でも書き始めるまでが長い
AA の出力速度(tok/s)は、1秒あたりに出てくるトークンの数です。Haiku 5.5 の Max は 239、Luna の Max は 127 で、約1.9倍の速さです。High 同士でも 139 対 118 で、Haiku 5.5 が上です。
ところが AA が載せているもう一つの数字、最初の文字が出るまでの秒数では、答えがひっくり返ります。Haiku 5.5 の Max は 277.6 秒、Luna の Max は 87.6 秒。Max は、じっくり考えてから書き始める設定だと読めます。High でも Haiku 5.5 が 16.6 秒、Luna が 12.0 秒でした。中国の格安モデルは 0.9〜4.3 秒と短く、書き出しの早さだけなら中国勢に分があります。
手元で測っても、同じ傾向になりました。条件は次のとおりです。
計測条件(手元の実測)
- Haiku 5.5: claude -p、--model claude-haiku-5-5、--effort high
- GPT-5.6 Luna: API 経由
- 指示文: system 1,823字、user 34,191字(本文の実験メモは約3万4千字)
Haiku 5.5 は High で 164 秒かかり、出力は考える分を含めて 39,206 トークンでした。それまで使っていた GPT-5.6 Luna は、API(プログラムからモデルを呼ぶ窓口)経由で 39 秒です。claude -p が表示した API 換算額は $0.022 ですが、定額プランの枠で動いているので実際の請求ではありません。枠がどれだけ減ったかは、まだ計っていません。
AA の「最初の文字まで」と手元の「1件の時間」は測り方が違うので、足し引きはできません。それでも、考える時間が1件の所要時間を大きく左右する点はどちらにも出ています。本番と同じ自作のパイプラインで回したときも、本文を書く呼び出しと言い回しを整える呼び出しの2回を合わせて、1本あたり185〜194秒でした。
文字が流れ出す速さだけなら、Haiku 5.5 は Luna より速い。けれど1件を仕上げるまでは、High でも約3分待つことになります。待ちながら次の仕事を回す使い方なら、この差は無視できません。
格安の中国モデルより上。ただし「格安帯でいちばん賢い」とは言えない
比べた相手を先に紹介しておきます。GLM-5.3-Flash は Z AI、Qwen3.8-Flash-Next は Alibaba の QwenQwen中国 Alibaba の AI モデルの系統。多くがオープンウェイトで配られている。詳しく → 系、DeepSeekDeepSeek中国 DeepSeek 社の AI モデル。安い API とオープンウェイトの公開で知られる。詳しく → V4.1 Flash は中国の同名の AI 企業、MiMo-V2.6-Flash は Xiaomi が出している格安モデルです。
| モデル(設定) | 総合点 | 出力速度(tok/s) | 最初の文字まで(秒) | 単価 入力/出力($) |
|---|---|---|---|---|
| Claude Haiku 5.5(Max) | 43.4 | 239 | 277.6 | 0.1 / 0.5 |
| GLM-5.3-Flash(Z AI) | 41.8 | 50 | 2.9 | 0.15 / 0.5 |
| Qwen3.8-Flash-Next(Alibaba) | 39.8 | 55 | 1.5 | 0.15 / 0.47 |
| DeepSeek V4.1 Flash(Max) | 39.5 | 219 | 0.9 | 0.3 / 1.2 |
| MiMo-V2.6-Flash(Xiaomi) | 37.9 | 56 | 4.3 | 0.14 / 0.28 |
出典: Artificial Analysis(https://artificialanalysis.ai/)。Haiku 5.5 は Max の段で並べています。
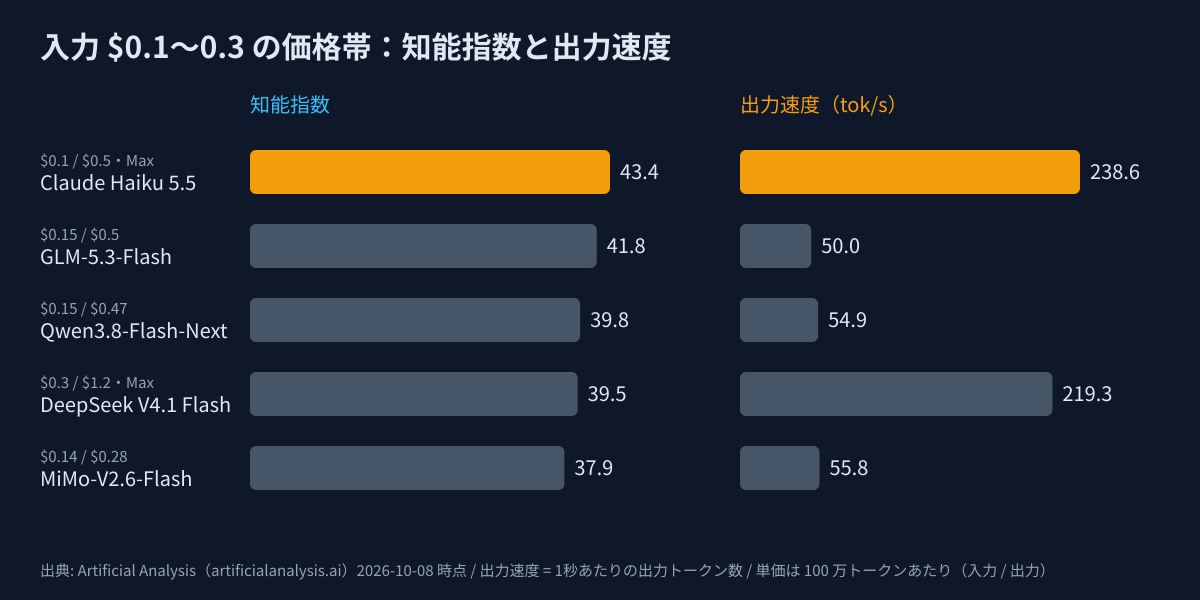
入力単価が 0.1〜0.3 ドルあたりの格安帯では、Haiku 5.5 の Max が総合点で四つすべてを上回りました。出力速度も GLM-5.3-Flash・Qwen・MiMo-Flash の約4〜5倍です。DeepSeek V4.1 Flash の Max(219)は速い部類なので、ここだけは差が小さくなります。
一方で、言えないこともはっきりさせておきます。単価の帯を少し広げると、MiMo-V2.6-Pro(MiMo 系列の別モデル。総合点 46.3、単価 0.435 / 0.87、出力速度 39)と Step 5 Preview(別の格安モデル。43.7、単価 1 / 2.7)が入ってきて、どちらも Haiku 5.5 の Max を総合点で上回ります。なので「格安帯でいちばん賢い」とは書けません。
日本語の書き味を中国勢と比べた実測も、今回はありません。日本語で勝ったとも負けたとも言えない状態です。言えるのは、同じ価格帯で総合点と出力速度の両方が上に出た、というところまでで、中国勢を否定する材料にはなりません。
定額プランのまま組み込めた。ただし4回つまずいた
呼び出しには claude -p(Claude Code を、画面を開かずにコマンド一つで動かす使い方)を選びました。Claude の定額プランの枠で動くので API の鍵が要らず、請求を気にせず何度でも試せる。これが決め手です。
組み込み自体は、定額プランの枠のまま組めました。自作のパイプラインから本文を標準入力(プログラムに文字を渡す入り口)で流し、結果は --output-format json で受けています。結果の中のエラーの有無を示す項目(is_error)が立っていたときと、結果が空だったときは、例外として扱うようにしました。API の鍵は環境変数から外しています。
基本の形は次の一行で、実際の呼び出しはこの後ろに出力形式などを足しています。
claude -p --model claude-haiku-5-5 --effort high
ここから4回つまずきました。
最初は、Haiku 5.5 が返事を ```json の囲み(コードブロック)で包んで返してきたことです。中身は正しい JSON(データを決まった書式で書いたもの)なのに、括弧の対応を数えて切り出す処理が失敗しました。囲みを外して直接読む経路を先に試すように直して、解決しています。
二つめは、書き直しを頼むときに system(モデルへの前置きの指示文)を空にしたことです。返ってきたのは成果物ではなく、310字の対話の返事でした。「成果物だけを返す編集者」という既定の system を付けたら、収まりました。
三つめは、出力の量の数え方です。claude -p が報告する出力の量は、考える分を含みます。本文9,610字の書き直しで、報告値は17,151トークン。私は「出力が短い=途中で切れた」と判定する仕組みを入れていたので、正常な書き直しを捨てていたことになります。今は、出力の量だけで切断を判定しないようにしています。
四つめは --bare です。軽く起動するためのオプションですが API キー専用で、定額プランでは使えませんでした。代わりに、空のフォルダから起動し、--setting-sources に空の値を渡して設定を読ませず、--tools に空の値を渡して道具を使わせず、--system-prompt で指示文を差し替えて、素の状態を作りました。
おまけにもう一つ。claude -p は sandbox(外部への影響を隔てた実行環境)の内側では動きませんでした。sandbox の外で回すか、内側では API のモデルに切り替える必要がありました。
冒頭の読みやすさを AI に数えさせたら、件数が毎回揺れた
まとめた文章の冒頭は、機械で検査したいと考えていました。見たいのは「固有名が説明されているか」と「なぜやるのかが書いてあるか」の二点です。最初は、モデルに数えさせる方法を試しました。
判定役にしたのは、Google の Gemini 系(gemini-3.1-pro)、Claude の Sonnet 系(claude-sonnet-4-6 と Claude Sonnet 5.5)、DeepSeek 系(deepseek-v4-pro)、GPT-6 Luna です。表に出てくる Jev は、題材にした実験メモに登場する判定モデルの名前です。
| 試した方法 | 結果 |
|---|---|
| gemini-3.1-pro、claude-sonnet-4-6、deepseek-v4-pro に、未説明の固有名を列挙させる | gemini-3.1-pro は考える分で上限を使い切り、JSON が途中で切れた(1回 $0.05)。deepseek-v4-pro は考える分だけで13,000を使い、181秒後に空の返事。棄権が多発した |
| GPT-6 Luna に1回列挙させる | 同じ冒頭でも件数が 5、3、7 と揺れた。別の冒頭では 1、4、6。良い文章と悪い文章の件数が重なった |
| GPT-6 Luna に3回数えさせ、2回一致したものだけ数える | 悪い文章が一致2件で、合格してしまった |
| 名前ごとに「説明あり/なし/不明」の3択で、GPT-6 Luna と Claude Sonnet 5.5 がそれぞれ3回判定 | 修正前の文章では、Jev の説明を両モデルとも「説明あり」と判定した |
| 「なぜやるかが書いてあるか」を GPT-6 Luna に聞く | 全件 true。見分けに使えなかった |
同じ文章を見せているのに、件数が 5 になったり 3 になったり 7 になったりする。これでは合格の線を引きようがありません。
結局採用したのは、「最初の見出しに『なぜ』『目的』『理由』『ため』のどれかが入っているか」を機械で見る方式です。悪い2本は不合格、良い2本と Haiku 5.5 の3本は合格しました。毎回同じ結果になり、費用もかかりません。ただ、これが見ているのは「なぜ」があるかどうかだけで、固有名が説明されているかは、まだ機械で見分けられていません。ここは未解決のままです。
学んだのは、LLMLLM(大規模言語モデル)大量の文章で学習し、人のように文章を読み書きできる大きな AI のモデル。詳しく →(文章を読み書きする AI モデル)に数えさせた件数は揺れる、ということでした。揺れに合わせて合格の線を動かすと、判定が都合のいいものになってしまいます。自動化に組み込むなら、数えさせるより、見出しの有無のように機械で測れる形に置き換えるほうが扱いやすいと思います。
替えた決め手は、数字より読み比べだった
2026年10月8日、私は長文をまとめる役を GPT-5.6 Luna から Haiku 5.5 に切り替えました。採点役は GPT-6 Luna のままにして、まとめる側と採点する側を別のモデルにしています。本番と同じ流れで3回回したときは、採点役が84〜87点を付けました。
決め手は AA の数字だけではありません。同じ指示文で両方に書かせて、読み比べたことです。Haiku 5.5 の文章は、商品が同じものかを判定する具体例から入り、道具の説明が話の流れの中に自然に入っていました。GPT-5.6 Luna のほうは、道具の定義文が「〜です。」の形で5つ続く、用語集のような並びでした。
どちらも、指示した「冒頭の型」は守っていました。差が出たのは、説明の並べ方です。Haiku 5.5 が書いた事実6点(日付や型番、画像の枚数など)は、すべて実験メモに実在していることも照合しました。
使ってみての感想は、「ようやく Anthropic が、Luna の位置(安くて小さいモデル)を埋めに来た」です。出力は速く、気持ちよく使えています。ただ、High で1件に約3分かかるので、待ち時間が気になる仕事には向きません。1件39秒だった GPT-5.6 Luna より遅いことは、隠さずに書いておきます。
全部を替えたわけでもありません。並列で20本まとめて回す仕事の既定は、今も DeepSeek V3.2(中国の同名の AI 企業のモデル。複数のモデルを一つの窓口から呼べる中継ツール経由で使っています)です。Haiku 5.5 にしたのは、1本ずつ読み味を確かめたい長文のまとめ役だけです。
替えるか迷ったら、自分の仕事でこの3つを測る
迷うとしたら、たぶん「待ち時間を取るか、Luna のまま速く返してもらうか」のところだと思います。判断は、次の3つを自分の仕事で測ると早くなります。
- 同じ指示文を Haiku 5.5 と今使っている側に投げ、出てきた文章を読み比べる。
- 1件が終わるまでの時間を測る。文字が出始めるまでの時間だけで判断しない。
- 一回の仕事の前後で、定額プランの枠の残りがどう動くかを記録する。私は今回ここを計っていないので、確かめたい方は最初に決めておくと後が楽です。
ここから先は事実ではなく私の見方ですが、Luna と同じ価格帯に Anthropic が入ってきたことで、格安帯の取り合いは強まると思います。中国勢が値下げや改良でどう応じるかは、今の数字からは分かりません。定額枠の消費が重い仕事では Haiku 5.5 を多用しにくくなるかもしれない、とも見ていますが、枠の消費は計っていないので想像の域を出ません。
数字の上では、Haiku 5.5 は Luna と同じ単価の価格帯に入り、同じ設定どうしで総合点を上回りました。ただし High の段では表の格安中国モデル4つすべてを下回るので、段を外して「上」とは言えませんし、日本語の書き味を中国勢と比べるまでは、私も「Haiku 5.5 が一番」とは言わないつもりです。速さは、書き出しと1件の完了で答えが違います。私の環境では、長文をまとめる一役だけを替えて、ほかの役は今のまま動かしています。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事
単価は同じでもxhighの評価費用は約7倍:Sonnet 5.5とGPT-6.1 Sol
同じ入力$2・出力$10でも、xhighのAA評価費用は約7倍。速度・賢さの天井・出力トークンから使い分けを判断します。
GPT-6.1 Solをeffort別実測:medium 47.8、Astraとの差はどこまで縮むか
GPT-6.1 SolをDevDay 2026の発表とArtificial Analysisのeffort別実測で検証。旧Sol・Astraとの性能、費用、待ち時間から使い分けを判断します。

Muse Wonder は Opus 5.5 超えか?総合56対58、使えるプラン一覧
Meta の Muse Wonder Full は総合指数で Opus 5.5 に2点及ばず、コーディングの一部でのみ上回ります。API・Muse Code・アプリ別の使える場所と、日本からの利用条件を整理しました。
高性能でも負けるArgon——Terminal-Bench 57.1%、Claude Sonnet 5.5は63.6%
Gemini 4 ArgonをArtificial Analysisの数値で検証。Claude Code・Codex利用者が乗り換える必要があるか、提供範囲と費用も含めて判断します。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:開発環境・キャリアまわりのサービス
 シンVPSを見る
 XServer VPSを見る
 strategy career の転職支援を見る