DeepSeek V4.1 Flash、1017へ替える?賢さ同じ・費用−58%
DeepSeek V4.1 Flash-1017を9月版と同じ日・同じ配信事業者で比較。楽天の型番判定572回と29問に加え、Gemini 3.8 Flash・GPT-6 Luna・Claude Haiku 5.5とも同じ89行で並べました。
私は、楽天の検索結果に並ぶ商品名が「同じ商品」なのか「型番違いの別物」なのかを、AIにどこまで任せられるかを確かめ続けています。そこへ2026年10月17日、DeepSeekDeepSeek中国 DeepSeek 社の AI モデル。安い API とオープンウェイトの公開で知られる。詳しく →が会話型AI(チャット形式で答えるタイプ)の新版「DeepSeek V4.1 Flash-1017」(以下1017)を出しました。うたい文句は「性能と費用のパレート改善」、つまり性能を落とさずに費用も下げた、出力が短くて作業も速い、というものです。ひとつ前の9月10日公開版(以下9月版)と、本当にそうなのかを自分のデータで並べました。
先に答えを書くと、1017は9月版と賢さがほぼ同じまま、答えが短く・速く・安くなっていました。型番判定の正解率は94%(9月版)と90%(1017)で、この4ポイントの差は偶然の範囲です。判定572回の実費は$0.0555から$0.0232に下がりました。ただしこの−58%には配信事業者の単価差が混ざっていて、単価をそろえると約−28%です。同じ会話型の Gemini 3.8 Flash・GPT-6 Luna・Claude Haiku 5.5 にも同じ89行を解かせると、1017は上位と同じ水準のまま、いちばん速く、いちばん安い結果でした。ここでいう「賢さ」は、楽天の型番判定と29問のテストで測った範囲の話です。
替えて得をするのは、型番判定のような処理を大量に流し、費用と速さを優先し、確信度(どれくらい確からしいかの数字)を使わない人です。件数が少ないなら、急ぐ理由はあまりありません。572回流しても実費の差は約3セント($0.03)でした。確信度で「人が見る行」を振り分けたい人にも、1017は向きません。それと、正解率の差は偶然の範囲とはいえ、事前に決めた基準には形式上かかっています。そこも含めて書いていきます。
公式APIでは旧版を呼べないので、配信事業者を固定して比べた
最初につまずいたのは、比べる相手を呼び出す方法でした。DeepSeekの公式APIでは、9月版の名前を指定しても、いまは1017が応答します。そのまま流すと、1017同士を比べることになってしまうんですよね。それに、AIモデルを第三者として採点しているArtificial AnalysisArtificial Analysis主要な AI モデルを同じ問題で採点し、賢さ・速さ・値段を比べて公開しているサイト。詳しく →(以下AA)には、まだ1017の点数がありません。公式の説明文でも第三者の点数でもなく、自分の判定データで差を見るしかない状況でした。
公式APIで新旧を呼び分ける方法はこの理由で取りやめて、OpenRouterOpenRouter多くの会社の AI モデルを、1つの窓口と1つの請求でまとめて使えるサービス。詳しく →(AIモデルを複数の事業者経由で呼び出せる窓口)を使いました。9月版と1017の配信先を、どちらもDeepInfraDeepInfra公開されている AI モデルを自社のサーバーで動かし、API として貸し出す配信事業者。詳しく →(AIモデルを配信する事業者のひとつ)のfp8fp8AI モデルの数値を 8 ビットで扱って、軽く速く動かす方式。詳しく →(数値を8ビットで扱う計算方式)に固定しています。9月版は、OpenRouter上ではDeepSeek以外の30社を超える事業者が配信を続けていて、DeepSeek自身の配信はありません(2026年10月18日に確認)。両版とも同じ日に、同じ事業者経由で流しました。
結果を見る前に、判定の基準も書き留めておきました。型番判定は±3ポイント以内なら同等、出力の短さと速さは15%以上の差があれば差あり、実費の上限は$2です。予想も書いています。9月版の型番判定は68〜80%くらいだろうと見ていたのですが、実際は94%でした。ここは見事に外れました。外れた予想も残しておくと、自分の思い込みがどちらに寄っていたかが後で分かります。
後から見返せるように、条件は表にまとめておきます。どれかを変えると数字の意味が変わるので、ここは省けない部分です。
| 項目 | 内容 |
|---|---|
| 窓口 | OpenRouterのchat completions |
| モデルID | 9月版は deepseek/deepseek-v4.1-flash、1017は deepseek/deepseek-v4.1-flash-1017 |
| 配信事業者 | DeepInfraのfp8に固定(他の事業者への振り分けなし) |
| 思考の深さ | reasoning efforteffortAI にどれだけ考えさせるかの段階設定。上げるほど賢く、遅く、高くなる。詳しく →を high(DeepSeekの既定) |
| 出力上限 | 判定 8,000トークン、29問 32,000トークン |
| 送らなかった設定 | temperaturetemperatureAI の答えのばらつき具合を決める設定値。詳しく →(思考モード思考モードAI が答える前に、見えないところで考える手順を挟む動き方。詳しく →では無視されるため) |
| 実施日 | 2026年10月18日。2版を同じ日に並行して流した |
| 追加で比べた会話型 | anthropic/claude-haiku-5.5(Anthropic)、openai/gpt-6-luna(OpenAI)、google/gemini-3.8-flash(Google AI Studio)。89行だけ・同じ日・同じ問い文・思考の深さ high・配信元を各社に固定 |
| 件数 | 判定は各版572回、29問は各版29問。合計1,202回の応答すべてで配信元がDeepInfraだったことを確認 |
| 集計の定義 | 正解率は正解数÷件数。中央値は小さい順に並べた真ん中の値。平均は合計÷件数 |
| 解析失敗 | 0件 |
判定データは3種類で、合わせて572行です。人手で正解を付けた6択の89行、本体と付属品などを見分ける粗いふるいの383行、Claude 2者がラベルを付けた100行。問い文の本体は前作と1字も同じで、会話型なので末尾に「choice」というキーの答えだけをJSONで返すよう、1文だけ足しました。2版合計で払った実費は約$0.17です。
型番判定は94%と90%。差は偶然の範囲だが、1017は「判断できない」を選びやすい
6択の89行で、9月版は84/89(94%)、1017は80/89(90%)でした。1017のほうが4ポイント低く、事前の基準「3ポイント以上落ちたら落ちた」には形式上かかっています。
ただ、2版の答えが割れたのは89行中6行だけでした。9月版だけが正解した行が5、1017だけが正解した行が1です。この割れ方を、食い違った行だけを見る正確検定(McNemar)にかけると、p=0.22。差がないと仮定しても、これくらい片寄る確率が約22%あるということなので、「1017は精度が落ちた」とは言い切れません。
気になったのは、外し方の中身です。9月版が正解して1017が外した5行のうち、4行で1017は「判断できない」を選んでいました。TD500 MeshとTD500 Mesh V2、FireCuda 530とヒートシンク付き版、Pulsar Xlite V3とXlite V3 eS、SilverStone FARA R1と別型番、の4組です。間違えたというより、決めきらずに引いた形ですね。残る1行は、別型番のX870E AORUS MasterとX870E A MASTER X ICEを同じ商品と返していました。逆に9月版だけが外したのは、ASUS PRIME Z890-P WIFI-CSMを別型番とした1行です。当サイトのいまのルール判定が誤っていた3行(Freezer A35、Zoria、SL-INF)は、両版とも3行中2行を当てました。
いちばん怖い「別の型番を同じ商品と取り違える」見落としは、型番違いの35行のうち9月版が1行、1017が3行でした。前作の判定専用AIで最少だったd1-ultraが6行なので、どちらの版も見落としは少ない側です。日本語の商品名でも、型番違いはおおむね見分けられていました。
残りの2つのデータも同じ傾向です。Claude 2者がラベルを付けた100行では、9月版が95、1017が92でした。前作のd1-ultraは93、Decider 90、OpenAI 89、JevJevTypeSafe が出している、文章を書かずに判定の答えだけを返す AI モデル。詳しく → 86です。383行の粗いふるいでは、SoC(スマホなどのチップ)のページに混じった端末の価格4行を、両版とも4行すべて拾いました。誤検知(本当は本体なのに外した行)は1017が0、9月版が1です。9月版はRadeon RX 9070のページのRX 9070 XTのカードを「無関係」としていて、細かい型番を区別しないこの問いでは誤りになります。1017の「4行すべて拾って誤検知0」は、前作のd1-ultra・Deciderと同じ満点です。
まとめると、1017は2つの測定とも9月版より数ポイント低い方向に出ました。6択の差は偶然の範囲で、100行での差(3ポイント)も小さい。それでも「わずかに低い可能性は残る」と書いておくのが、この数字に対して正直な言い方だと思います。
同じ会話型のGemini・Luna・Haikuと並べると、1017は最速・最安
DeepSeek Flashは文章で答える会話型AIなので、比べるなら同じ種類の安いモデルが筋です。Gemini 3.8 Flash・GPT-6 Luna・Claude Haiku 5.5にも、同じ89行・同じ問い文・同じ思考の深さ(high)で答えてもらいました。配信は各社の自社窓口(Anthropic・OpenAI・Google AI Studio)に固定し、同じ日に流しています。
| モデル(会話型) | 正解率(89行) | 型番違いの見落とし(35行中) | 「判断できない」の回数 | 応答の中央値 | 89行の実費 |
|---|---|---|---|---|---|
| DeepSeek V4.1 Flash 9月版 | 94%(84/89) | 1 | 5 | 1,445 ms | $0.019 |
| Gemini 3.8 Flash | 94%(84/89) | 2 | 4 | 3,186 ms | $0.209 |
| GPT-6 Luna | 93%(83/89) | 4 | 3 | 2,231 ms | $0.008 |
| DeepSeek V4.1 Flash-1017 | 90%(80/89) | 3 | 8 | 995 ms | $0.006 |
| Claude Haiku 5.5 | 76%(68/89) | 5 | 17 | 2,521 ms | $0.015 |
上位4つ(DeepSeekの2版・Gemini・Luna)の正解率の差は、どの組み合わせでも偶然の範囲でした(同じ検定でp=0.34〜1)。その中で1017は、応答がいちばん速く、実費がいちばん安い。Geminiは同じ水準の正解率に、1017の約36倍の費用がかかっています。
意外だったのはHaiku 5.5です。1017だけが正解した行が12、Haikuだけが正解した行が0で、p<0.001。こちらははっきり下でした。89行中17行で「判断できない」を選んでいて、慎重すぎる答え方が正解率を削っています。AAの知能指数ではこの中で最上位(43.4)なので、指数の順位と日本語の型番判定の順位がひっくり返った例になりました。
判定専用AIと比べると、見落としは少ないが、確信度は返ってこない
前作で比べた判定専用AIとも、同じ89行で並べてみます。判定専用AIは、選択肢から選ぶことに特化したAPIです。OpenAI Decisions(GPT-6 Luna)、Perplexity Decider、Jevがそうで、Liquid d1-ultraと同じく前作の相手です。DeepSeekにはその専用機能がないので、普通の会話型AIに「決まった形式で答えて」と頼んで判定役をさせています。
DeepSeek以外は別の日の結果で、今回は再実行していません。前作までの確認では日をまたいでも同じ答えが返っていたので、並べて読める前提にしています。各モデルの細かい結果は、前作のd1-ultraの比較とDeciderの比較にまとめています。
| モデル | 正解率(89行) | 型番違いの見落とし(35行中) | 応答の中央値 |
|---|---|---|---|
| DeepSeek V4.1 Flash 9月版 | 94%(84/89) | 1 | 1,445 ms |
| DeepSeek V4.1 Flash-1017 | 90%(80/89) | 3 | 995 ms |
| Liquid d1-ultra(10月17日) | 91%(81/89) | 6 | 346 ms |
| OpenAI Decisions(10月9日) | 85%(76/89) | 11 | 434 ms |
| Perplexity Decider(10月17日) | 80%(71/89) | 10 | 547 ms |
| Jev(10月9日) | 67%(60/89) | 26 | 392 ms |
| ClefClefCloudflare が出している、文章を書かずに判定の答えだけを返す AI モデル。画像も読める。詳しく →(10月9日) | 62%(55/89) | 32 | 509 ms |
応答の中央値は89行だけの集計です。
見落としは2版とも1〜3行で、d1-ultraの6行より少なく、ほかの判定専用AIは10行以上でした。判定専用AIのために用意した問題で、会話型が前作首位と並ぶかそれ以上というのは、正直ちょっと驚きました。
ただ、判定専用AIは答えと一緒に確信度を返します。会話型のDeepSeekはそれを返さないので、「自信の低い行だけ人が見る」振り分けはこの方法ではできません。正解率で並んでも、人手確認へ回す仕組みをそのまま置き換えにくいのは、ここです。
速さにも差があります。1017の応答の中央値は、89行で995ms、572回の集計では721msでした。d1-ultraの346msと比べると2〜3倍です。ただしこれは日をまたいだ数字なので、目安として読んでください。
出力は2割、応答は4割減。費用の−58%は、単価をそろえると約28%
DeepSeekの「出力が短く、作業が速い」という説明は、判定と29問の両方ではっきり数字に出ていました。事前に決めた15%の線も、出力・速さとも超えています。
| 指標 | 9月版 | 1017 | 差 |
|---|---|---|---|
| 判定572回の出力トークン(中央値) | 66 | 53 | −20% |
| 判定89行の出力トークン(平均) | 470 | 181 | −61% |
| 判定572回の応答時間(中央値) | 1,263 ms | 721 ms | −43% |
| 29問の出力トークン(中央値) | 2,149 | 1,351 | −37% |
| 判定572回の実費 | $0.0555 | $0.0232 | −58% |
| 29問の実費 | $0.0575 | $0.0304 | −47% |
中央値で見ると、判定の出力は66から53トークン、応答時間は1,263msから721msに下がりました。平均の出力は470から181トークン(−61%)と、もっと大きく減っています。9月版はときどき長く考え込む行を出していて、1017ではそれが減ったためです。1件あたりのふだんの長さを見るなら、中央値のほうが素直だと思います。
費用は少し注意が要ります。判定572回の実費は$0.0555から$0.0232で58%減ですが、この差には配信事業者の単価差が含まれています。DeepInfraのfp8では、1017の単価が9月版より約3割安いからです。DeepSeek公式の料金は据え置きで、ピーク時は100万トークンあたり入力$0.30、出力$1.20(オフピークは半額)。料金は変わることがあるので、DeepSeekの公式料金表で、確認した日付と合わせて見てください。
そこで、1017が使ったトークン数を9月版の単価で計算し直すと、差は約−28%でした。出力トークンの合計は101,946から49,137と半分以下ですが、入力(問い文)の量は2版で同じなので、費用全体では3割弱の差に落ち着きます。−58%の残りは配信事業者の単価差です。「DeepSeekが値下げした」と受け取ると、ずれてしまいます。
正解1件あたりの費用は、89行で9月版が約$0.00023、1017が約$0.00007でした。速さは同じ事業者・同じ日の比較ですが、混み具合の差までは消せていません。費用の差は比較的はっきりしている一方で、速さは目安として読んでください。
29問は27点と26.5点。差の0.5点は、考える途中で出力上限に達した1問
29問は、引っかけ・論理・コード・日本語・難問コードの問題をまとめた当サイトのテストです。どちらの版か伏せた記号で採点を確定してから対応表を開きました。正解は1点、部分点は0.5点で、9月版は27点、1017は26.5点です。
両版とも外したのは、「りんごを取った」の問題(多義語の引っかけで、どちらも「花子が持っている」と答えた)と、「やばい」の4番の問題(どちらも「文脈次第」)でした。差の0.5点は、難問コード(async generatorの実行順序)の1問で生まれています。
1017は、考える工程だけで出力上限の32,000トークンに達し、答えが空のまま終わりました。9月版は同じ問題を28,174トークンで解いて正解しています。賢さで負けたというより、長く考えた末に答えを書く余白がなくなった失敗です。出力上限を低めにしていると、賢いモデルでも同じことが起きえます。
1問の差なので、ここだけで「1017は落ちた」と読むのは早すぎます。ただ、長い推論を伴う処理に1017を使うなら、出力上限の余裕は多めに見ておいたほうがよさそうです。
最高性能のOpus 5.5と比べると、賢さは約7割・料金は約15分の1
AIモデル選びでいちばん知りたいのは、たぶん「料金に対して賢さはどうか」と「最高性能とどれくらい違うか」の2つだと思います。総合的な賢さはAAの知能指数で見ます。表の「最上位との比」は、2026年10月18日時点で指数が全体1位のClaude Opus 5.5(Max)を100%としたときの割合です。混合単価は、入力と出力を3対1で混ぜた100万トークンあたりの料金です。
| モデル | 知能指数 | 最上位との比 | 混合単価($/100万トークン) | 料金はOpus 5.5の何分の1か |
|---|---|---|---|---|
| Claude Opus 5.5(Max) | 57.6 | 100% | 8 | — |
| Claude Sonnet 5.5(Max) | 56.0 | 97% | 4 | 1/2 |
| Gemini 4 Argon(High) | 52.6 | 91% | 4 | 1/2 |
| GPT-6.1 Sol(Max) | 51.8 | 90% | 4 | 1/2 |
| Claude Haiku 5.5(Max) | 43.4 | 75% | 0.2 | 1/40 |
| GLM-5.3-Flash | 41.8 | 73% | 0.237 | 約1/34 |
| Gemini 3.8 Flash(High) | 40.9 | 71% | 1.5 | 約1/5 |
| DeepSeek V4.1 Flash 旧版(9月版・Max) | 39.5 | 69% | 0.525 | 約1/15 |
| GPT-6 Luna(Max) | 38.1 | 66% | 0.2 | 1/40 |
| DeepSeek V4.1 Flash 新版(1017) | 未掲載 | — | — | — |
出典: Artificial Analysis、2026年10月18日取得
総合的な賢さでは、Opus 5.5との差ははっきりしています。DeepSeek Flashの旧版は、いちばん深く考える設定でも最上位の約7割。Opus 5.5は、いちばん浅く考える設定(Low)でも42.3で、DeepSeekを上回ります。難しい推論や長いプログラミング、AIに自分で作業を進めさせる用途なら、上位モデルを選ぶ理由は十分にあります。
料金を重ねると、見え方が変わります。上位の3モデル(Sonnet 5.5・Gemini 4 Argon・GPT-6.1 Sol)は、Opus 5.5の半額で9割以上の賢さがあります。安い側は、5〜40分の1の料金で最上位の66〜75%です。指数と料金表だけで見ると、DeepSeek Flashは安い側の中ではむしろ割高な位置で、Haiku 5.5やGPT-6 Lunaのほうが安くて指数も近いか上です。安いモデル同士の指数と単価の開きは、Muse Spark 1.3とGLM-5.3-Flash、知能4点差で単価6倍でも詳しく見ています。
ところが、料金表の単価は実際の支払額と同じではありません。考える量(出力トークン)がモデルによって大きく違うからです。今回の89行の実費は、DeepSeek 1017が$0.006、GPT-6 Lunaが$0.008、Haiku 5.5が$0.015、Gemini 3.8 Flashが$0.209でした。1017は答えが短く、配信事業者の単価も安かったので、単価表とは逆に、実費ではいちばん安くなっています。
もうひとつ、型番判定のような決まった形の判定では、指数の差がそのまま結果に出ませんでした。指数がこの中で最も高いHaiku 5.5は76%で最下位、指数が低めのDeepSeekとGPT-6 Lunaは90〜94%です。89行は上位が9割を超える「やさしめの実務」なので、Opus 5.5のような最上位モデルを使っても、伸びる余地は小さいと考えられます(Opus 5.5では今回測っていません)。
なので私の読み方はこうです。難しい推論・設計・長いコードなど、賢さが結果を左右する仕事には、上位モデル(Opus 5.5、または半額で9割のSonnet 5.5など)を選ぶ価値があります。型番判定や分類のような定型の判定を大量に流すなら、最上位の約7割の賢さで十分なことが多く、料金の差(15〜40倍)のほうが効いてきます。その用途では、DeepSeek Flash 1017は実費でいちばん安い選択肢でした。
なお、AAの数字はDeepSeekをMax(最も深い設定)で測った値で、今回の検証は既定のhighです。1017の行は、2026年10月18日時点でAAにはありません。一部で予想の数字が出ていますが、確認できた値ではないので、この記事では扱いません。
替えるかどうかは、確信度が要るかと、空振りをどう扱うかで決まる
賢さの面では、9月版から1017へ替えても型番判定が大きく落ちるという根拠は、今回の数字にはありません。費用と答えの短さは、はっきり確認できました。残る不満は、確信度がないこと、AAに点数がないこと、出力上限に達すると答えが空で終わりうることの3つです。替える前に、次の点だけ押さえておいてください。
- ⚠️ 公式APIで9月版の名前を指定しても、今は1017が応答します。比べるときは、モデルIDと配信事業者を毎回記録してください。戻すときは、9月版の旧IDを配信事業者を指定して呼ぶ形に戻します。9月版はDeepSeek以外の30社を超える事業者が配信を続けているので、戻し先の経路として確認できます。
- ⚠️ 出力上限が足りないと、答えが空のまま終わることがあります(29問で実際に起きました)。上限は32,000トークン以上を確保し、空の行は「判断できない」とは分けて記録してください。戻し方は、空になった行だけ9月版で再実行することです。
- ⚠️ 実費の−58%は配信事業者の単価差を含みます。同じ単価で計算し直すと、差は約−28%でした。ご自身の窓口の単価で見積もり直してください。
- ⚠️ 確信度がないので、自信の低い行だけを人が見る運用には使えません。その運用が必要なら、判定専用AI(d1-ultraなど)に戻してください。
迷うとしたら、たぶん「安さと速さを取るか、確信度で人が見る行を選べるほうを取るか」の場面だと思います。型番違いの行を、自信の低いものから人が確認する仕組みなら、判定専用AIのほうが合います。確信度が要らず、正解率と費用を重視するなら、DeepSeek Flashの1017は候補に入ります。同じ会話型の中では、正解率が同じ水準のGemini 3.8 FlashやGPT-6 Lunaより速く安いので、まず試す1本として選びやすい位置です。
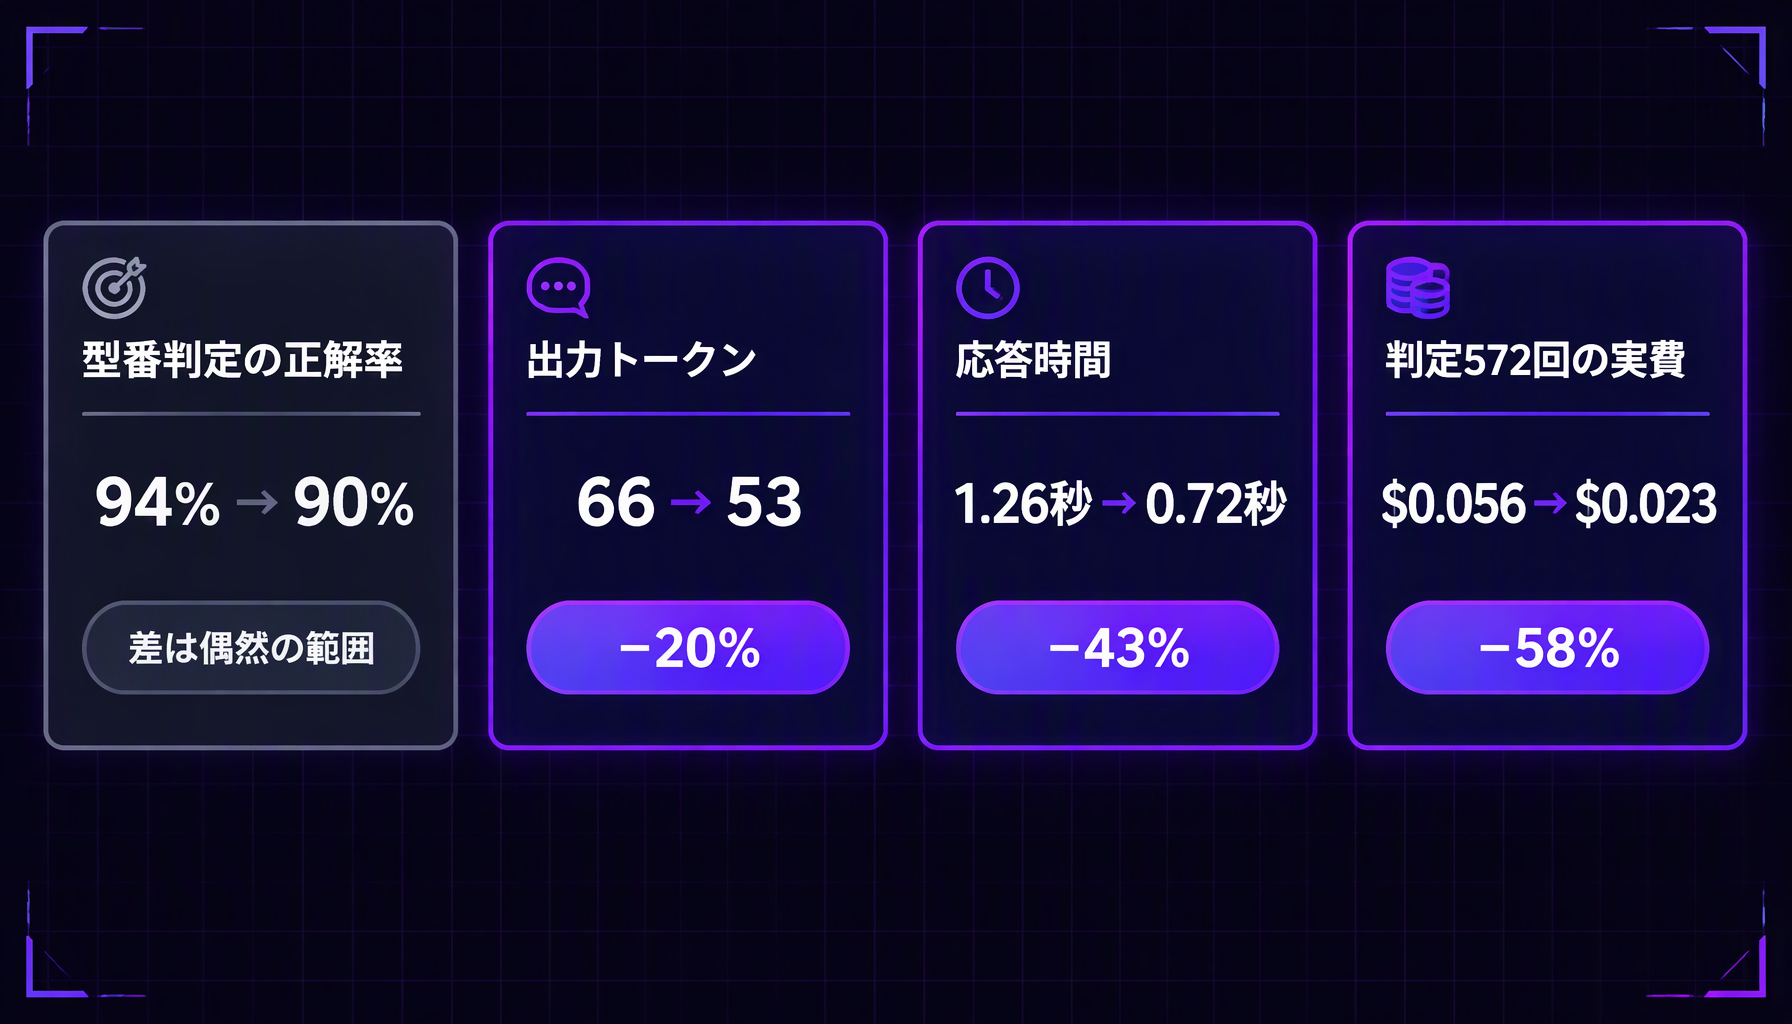 9月版→1017:賢さはほぼ同じまま、短く・速く・安くなった(DeepInfra fp8・2026-10-18。実費の−58%は配信事業者の単価差を含み、単価をそろえると約−28%)
私なら9月版には戻さず、「判断できない」の行を捨てない
ここからは、数字の外にある推測と私見です。
1017が「判断できない」を選んで外した行は4つありました。答えを急がず、迷う行を避ける方向に寄ったのかもしれません。ただ、これは外れた行の中身を見て感じた推測で、理由を確かめたわけではありません。短く答える傾向と、判断を控えやすい傾向が同じ原因から来ているのかも、今回のデータでは切り分けられていません。
私なら、9月版を残す理由は今回の数字からは見当たりません。ただ、切り替える前に配信事業者と料金を確かめておくと、後で数字がずれたときに原因を追いやすくなると思います。
そして、1017で「判断できない」と返った行は捨てずに、人が見る列へ残します。私の運用では、型番の照合はルール(版数語の一覧)でも持っていて、AIの判定は補助です。だからこそ、正解率の数字より、どんな取りこぼし方をするかを見ておくほうが、後で効いてくると考えています。
自分の商品データで確かめる手順
今回の数字は、楽天の商品名と、この記事のデータに限った結果です。ご自身の商品データで確かめるなら、次の順で進めると、条件をそろえて比べやすくなります。
- 型番違いを含む行を数十行集め、人手で正解を付けておきます。
- OpenRouterで配信事業者を1社に固定し、9月版と1017を同じ日に、同じ問い文で流します。
- 正解率、「判断できない」の数、応答時間、費用を、版ごとに別々に数えます。
- 出力上限を決めたうえで(今回は判定8,000トークン、29問32,000トークン)、答えが空で終わった行がないかを確かめます。
次に見るべきは、AAに1017の点数が載るかどうかと、今回答えが割れた6行に近い行が、ご自身のデータでも同じように割れるかどうかです。どちらかが分かれば、この比較は読み直す価値があります。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事

中国LLMコーディングプラン vs Claude Code——月600タスクでなぜ86倍差か?
Claude Codeの定額・週次上限と、中国LLMの定額/従量課金を月600タスクで比較。乗り換えの手間と現実的な併用策を整理します。

AIに発言だけ見せて「この2体は誰だ」と聞いたらGeminiを当てた。でも根拠はこちらのバグだった
AI同士に正体を伏せたまま20回会話させ、その発言ログだけを第三のAIに渡して「同じモデルか、どちらが上か」を推理させました。正体は当てましたが、根拠にはこちらの設定ミスが混ざっていました。同じ勝負を2回撮って分かったことの全記録です。
【速報・完全版】Gemini 3.1 Pro徹底解説 — 推論2倍超・思考シグネチャ・エージェント時代の幕開け
Session 632026年2月19日リリースのGemini 3.1 Proを完全解説。ARC-AGI-2で77.1%(前世代比2倍超)、SWE-bench 80.6%を達成。Thinking Levels・思考シグネチャ・Context Caching最大90%削減・Batch API・Google Antigravityなど、開発者が知るべき全機能をベンチマーク比較表・料金表・プロンプト例付きで徹底解説。
Kimi K3.1 Pro、中国勢で断トツの賢さ。ただし値段は Sonnet 5.5 と同じ
10月23日に出たKimi K3.1 Proを、Artificial Analysisの知能指数と単価で中国勢・米国勢と比較。中国勢では2位に8.8点差の断トツ、値段は入力$2・出力$10でSonnet 5.5と同じ。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:開発環境・キャリアまわりのサービス
 シンVPSを見る
 XServer VPSを見る
 strategy career の転職支援を見る