d1-ultraはOpenAI Decisionsから替える?日本語型番で正解率91%
Liquid AIのd1-ultraを前作と同じ楽天89行で実測。日本語の型番違いの見落としは8モデル中最少で、無印d1はJev並み。費用・速さ・限界も。

楽天の検索結果に並ぶ商品名が、当サイトの価格台帳にある製品と同じものかどうか。私はこの判定を、文章を書かずに「はい・いいえ」や選択肢ごとの確率だけを返す判定専用AIに答えさせ、JevJevTypeSafe が出している、文章を書かずに判定の答えだけを返す AI モデル。詳しく →・OpenAI Decisions・Perplexity Decider・ClefClefCloudflare が出している、文章を書かずに判定の答えだけを返す AI モデル。画像も読める。詳しく → と順に比べてきました。今回の相手は、Liquid AI が2026年10月15日に公開した d1-ultra です。
型番の取り違えで困っているなら、d1-ultra は替える候補になります。人手で正解を付けた89行の6択で正解率は91%、型番違いの見落としは35行中6行でした。前作で上位だった OpenAI(85%・11行)と Decider(79.8%・10行)を上回り、比べた8モデルの中で一番です。
一方、同じ会社の小さい版で、単価が半分の「無印」の d1 は Jev とほぼ同じ水準で、替える理由は見つかりませんでした。それから、d1-ultra が強いのはあくまで版数違いの判定で、何でも任せられるという話ではありません。
指数の首位が日本語でも首位なのかを、前作と同じ89行で確かめた
d1-ultra は、Artificial AnalysisArtificial Analysis主要な AI モデルを同じ問題で採点し、賢さ・速さ・値段を比べて公開しているサイト。詳しく → の Decision Index(英語中心の4つの試験の加重平均)で首位になったモデルです。ただ、この4試験は日本語の商品照合とは別の能力を見ています。指数の順位が、そのまま日本語の型番判定に当てはまるとは限りません。私が知りたかったのは二つで、OpenAI から替える価値があるか、無印の d1 で費用を抑えられるか、です。
気づいたのは2026年10月17日、前作の Decider 記事を公開したその日でした。Artificial Analysis のグラフを見ていたら、まだ試していない d1-ultra が首位に立っていたんですよね。そこで、前作と同じデータ、同じ問い文、同じ集計で比べることにしました。条件をそろえておけば、出た差をそのままモデルの差として読めます。前作までの流れは Jev・OpenAI Decisions・Clef、型番判定で最強はどれ? にまとめています。
流す前に、合格線と予想を書いて固定しました。合格線は6択の正解率80%以上、型番違いの見落とし13行以下。予想は正解率72〜84%、見落とし10〜20行です。実費の上限も$0.30と決めてから流しています。
結果は、予想より上に外れました。
Liquid AI のコンソールでは、自分でアカウントを作って APIキー(サービスを呼び出すための鍵)を発行しています。新規登録の無料クレジット($2)の範囲に収まり、2モデル合計で約$0.029、約2,500回の呼び出しで失敗は0でした。
d1-ultraは型番違いの見落としが8モデル中で最も少なかった
前作で一番多かった失敗は、台帳の製品と、検索結果に出てきた別の型番を同じ製品として扱ってしまうことでした。「B760」と「B760M」、「TD500 Mesh」と「TD500 Mesh V2」のような、一文字や一語の差です。その見落としがどこまで減ったかを、表にまとめました。
| モデル | 6択の正解率 | 型番違いの見落とし(35行中) | はい・いいえの1問版 | 応答の中央値 |
|---|---|---|---|---|
| d1-ultra | 91%(81/89) | 6 | 87% | 346ms |
| OpenAI | 85%(76/89) | 11 | 75% | 434ms |
| Decider | 79.8%(71/89) | 10 | 87% | 547ms |
| Jev | 67%(60/89) | 26 | 66% | 392ms |
| d1 | 64%(57/89) | 29 | 61% | 382ms |
| Clef-flashClef-flashCloudflare の判定専用モデル Clef の軽量版。詳しく → | 64% | 30 | 64% | 321ms |
| Decider Flash | 63% | 26 | 65% | 455ms |
| Clef | 62% | 32 | 64% | 509ms |
表を読むときに一つだけ覚えておいてほしいのは、全モデルを同じ日に流したわけではないことです。d1-ultra と d1、Decider と Decider Flash は10月17日、OpenAI・Jev・Clef は10月9日(問い文パート2は10月10日)の結果を使っています。とはいえ、Jev と Clef は10月8日と9日の2回で89行の答えがすべて同じで、OpenAI も10月9日と10日の2回で472行の答えが変わりませんでした。過去の結果を使ったのは、この安定を確かめてあるからです。
差がはっきり出たのは、行ごとに突き合わせたときです。Jev が外して d1-ultra が正答した行は21行。逆に、Jev が正しくて d1-ultra だけが外した行はゼロでした。OpenAI とでも、OpenAI が外して d1-ultra が正答した行が6、逆は1行です。Jev が外して d1-ultra が正したのは、Hyper 212 Black Edition と Hyper 212 RGB Black Edition、MasterBox TD500 Mesh と TD500 Mesh V2、Kingston FURY Renegade 2TB と Renegade G5 のように、末尾の一語で別製品になる組み合わせでした。まさに前作で手を焼いていた形です。
もう一つ、d1-ultra は「判断できない(ambiguous)」を一度も使いませんでした。Decider は6行で判断を保留しています。91%は、迷ったところを逃げて稼いだ数字ではありません。
パート2で追加した100行(人手ではなく Claude 2者で付けたラベル)でも、d1-ultra は93%で最も高く、Decider 90%、OpenAI 89%、Jev 86%と続きました。型番違いの9行での見落としは、d1-ultra と OpenAI が4行、Decider が6行、Jev が9行です。
d1-ultraが外した8行は、OpenAIもほとんど同じ行で外していた
d1-ultra が外したのは89行中8行です。そのうち7行は OpenAI も「同じ製品」と答えて外し、6行は Decider も同じ答えでした。残る1行、Pulsar Xlite V3 と Xlite V3 eS だけは、OpenAI が正しく答えています。
8行を並べると、同じ型番に派生版がある場面がほとんどでした。FireCuda 530 1TB と、ヒートシンク付きの版。ROG Gladius III Wireless と、AimPoint 版。X870E AORUS Master と X870E A MASTER X ICE。HyperX Alloy 65 と Alloy Origins 65。GALAHAD II Trinity 360 と SL-INF。ほかに、年式の違いが要る行が2つあります(Apex Pro TKL 2023、NZXT H5 Flow 2024)。この2つは、人手の正解も判断保留扱いです。
Jev が正しくて d1-ultra だけが外した行は0だったので、この8行は Jev もすべて外しています。OpenAI も7行、Decider も6行で同じように外しており、今回の8モデルでは誰も安定して解けていない行です。機械に任せられる範囲の境目は、この「同じ型番のまま派生版がある」場面にありそうです。
確信度の高い順に確認しても、d1-ultraが一番だった
確信度は、モデルが自分の答えにどれだけ自信があるかを0から1で返す値です。実際の運用では、確信度の高いものから順に何件かを機械に任せ、残りを人が見る、という使い方になると思います。そこで、確信度の高い順に上から件数を決めて採用したときの正解率を比べました。
d1-ultra は上位18件で100%、30件で97%、54件で96%でした。同じ件数で OpenAI は98%・93%・94%、Decider は100%・97%・91%、Jev は98%・87%・78%です。どの件数でも、d1-ultra は一番か同率一番でした。
自信満々で外した行の数だけを見ると、d1 が24行(誤り32行中)で最も多く見えます。ただ、件数をそろえて比べると d1 は Clef とほぼ同じで、8モデルで最も過信しているとまでは言えません。d1-ultra は誤り8行のうち、確信度0.8以上で外したのが1行だけでした。
前作の振り分けを、d1-ultra 1本で置き換える材料は揃った
前作では、粗いふるいは Decider、細かい型番は OpenAI、と判定の種類ごとにモデルを分けていました。今回の結果をこの振り分けに当てはめてみます。
粗いふるいは、本体そのものか、付属品・セット・無関係かを分ける判定です。383行で流すと、d1-ultra が疑った4行は、どれもSoCSoCCPU・GPU などを1つのチップにまとめた部品。スマホやタブレットの頭脳。詳しく →のページに端末の価格が載っていたもので、本物の問題でした。誤検知は0で、Decider と並ぶ満点です。Dell Inspiron 15 3530(Office 付きの本体)を「セット」と判定してしまったのは、d1 の方でした。ただし、疑わなかった379行は目視していないので、見逃しの総数は分かりません。
はい・いいえで答える1問版は、d1-ultra が87%で Decider と並んで最も高く、OpenAI は75%、Jev は66%でした。
画像は公開サムネイル9枚で試し、動物の絵・Llama の文字・マークの判定を d1-ultra は9/9で当てました。9枚だけなので、精度の主張はしません。画像の渡し方は images に data URL の文字列を配列で入れる形で、Jev・Clef とも OpenAI・Decider とも違う、3つ目の形でした。
1本で置き換える材料は揃ったと思います。粗いふるいの見逃し総数と画像の精度だけは、今回の規模では確かめ切れていません。
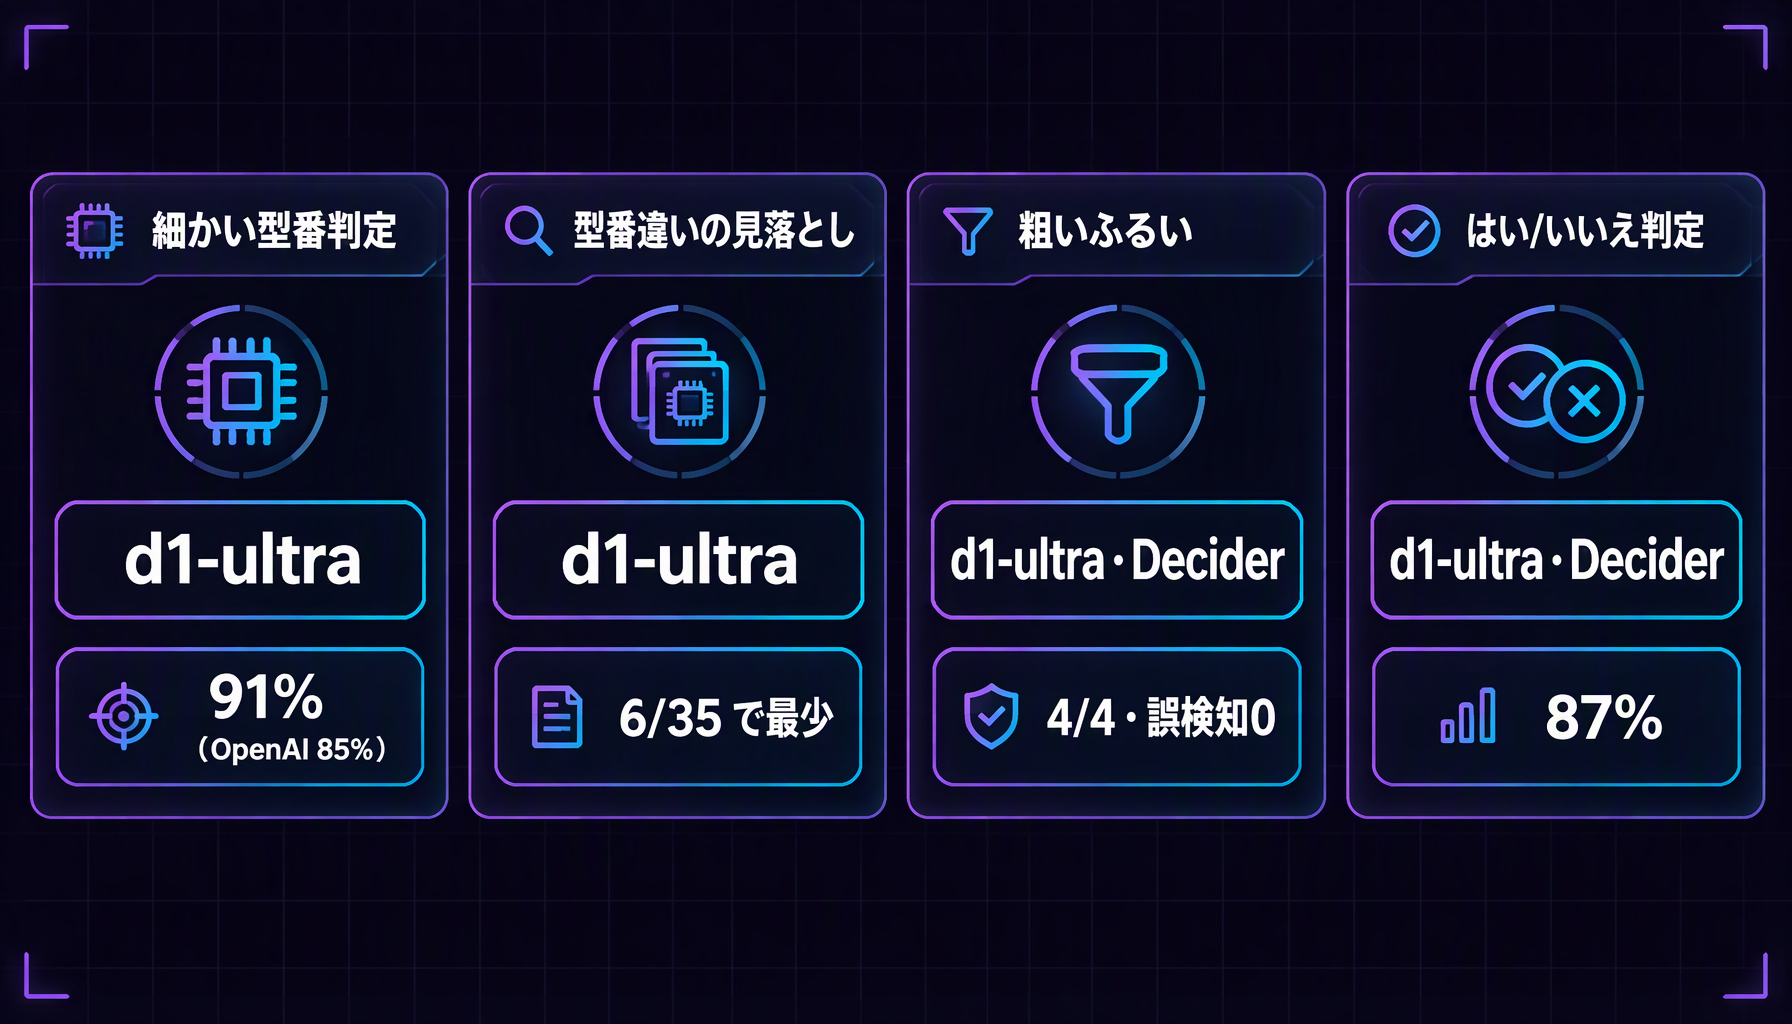
前作で分けていた4つの判定は、どれも d1-ultra が1番(2つは Decider と同率)
無印のd1はJevの代わりにならない。d1-ultraの費用はJevの半分ほど
費用を抑える候補だった無印の d1 は、正解率64%、型番違いの見落とし29行で、Jev の67%・26行とほぼ同じ水準でした。同じ会社でも大小で差が大きく、Jev から替える理由は見つかりません。
では d1-ultra の料金はどうか。入力100万トークントークンAI が文章を読み書きする時の、文字を細かく区切った単位。料金もこの数で決まる。詳しく →(AI が文章を数える単位)あたり$0.042で、出力の課金はありません。6択の1行は入力385トークンなので、計算上は1呼びあたり約$0.000016です。同じ1行を Jev は863トークン、Decider は414トークンと数えるため、トークン数と単価から計算すると、1呼びあたりは Jev の約半分、Decider の約2倍になります。今回の判定で一番だったモデルが、Jev より安く済むわけです。
速さは、応答の中央値が346msで、8モデルの中では速い側でした。最も速いのは Clef-flash の321msです。ただしこれは1回の実行の中央値で、混んだ時間帯の値は確かめていません。混雑による拒否(429)は0件でした。
指数の順位と日本語の順位がずれる理由(私見)
ここから先は推測と私見です。事実の数字とは分けて読んでください。
指数では d1-ultra が65で首位、Jev が57、OpenAI は48で、掲載された11モデル中10位でした。ところが日本語の型番判定では、OpenAI が85%で2位、Jev は67%で4位です。今回の集計だけでは、この順位のずれを説明しきれません。
私は、指数の4試験が英語中心で、日本語の商品名の版数を見分ける力とは別の能力を見ていることが、ずれの一因ではないかと考えています。確かめたわけではありません。OpenAI の日本語の強さがどこから来るのかも、ここでは確認していません。
私なら、いまの照合ルール(版数語の一覧)は残したまま、判定の補助を d1-ultra に替えて、自分の台帳の型番違いの行だけ先に比べます。指数の首位だけを見て替えることはしません。
替える前に、自分のデータで確かめたいこと
迷うとしたら、「この記事の数字を自分の商品にもそのまま当てはめてよいか」だと思います。替えるかどうかは、自分の商品データで同じ行を比べてからでも遅くありません。進め方は次の順が安全です。
- 自分の商品データから、版数違いが混ざる行を100行前後、人の目で正解を付ける。
- 比べる前に、正解率と見落とし行数の合格線を決める。
- 確信度の高い順に人が確認する件数を決め、その範囲で外れた行を数える。
- 費用は usage.cost の合計で確かめ、上限を先に決める。
この記事の結果にも限界があります。89行と100行の2つの集計で、実行は1回です。応答には日付の入った版名が返らず、Liquid の利用規約にも「更新で結果・確信度・性能が変わりうる」とあるため、後日に同じ結果が出る保証はありません。他の6モデルは別の日の結果です。
公式は112の評価で d1 と Jev 1.14を上回ると説明していますが、数値は図だけで本文にはありませんでした。日本語の数値も公式ブログには見当たらず、紹介記事の「44言語」に日本語が入るかは未確認です。
数字を追い直すための条件
本文の数字を追い直したい方向けに、条件を表にまとめます。
| 腕 | 経路 | 応答のモデル名 | 流した日 |
|---|---|---|---|
| d1-ultra | Liquid 直結(System One 形式) | d1-ultra(日付の版名は返らず) | 10月17日 |
| d1 | Liquid 直結 | d1 | 10月17日 |
| Decider / Decider Flash | OpenRouterOpenRouter多くの会社の AI モデルを、1つの窓口と1つの請求でまとめて使えるサービス。詳しく → | pplx-decider-v1.2-20261016 系 | 10月17日 |
| OpenAI(gpt-6-luna) | OpenRouter | 20261006 | 10月9日(パート2は10月10日) |
| Jev | OpenRouter | 20260917 | 10月9日(パート2は10月10日) |
| Clef / Clef-flash | Cloudflare Workers AI REST | clef / clef-flash | 10月9日(パート2は10月10日) |
問い文と集計定義は前作と一字一句同じです。Liquid 直結の窓口は、送り先の名前どおり Jev と同じ System One 形式で、本文の形(state / questions / criteria)はそのまま通りました。並列は4、実行は1回で、再試行は転送失敗のときだけです。新しい2モデルを足す前後で、既存6モデルの集計表が一字も変わらないことも差分で確かめています。
公開してよいかも確認しました。Liquid の利用規約(2026年9月30日版)には、性能比較やベンチマーク結果の公開を制限する条項は見当たりませんでした。禁止されているのは、出力で他のAIモデルを学習・改良することと、書面の許可なく脆弱性を探ることです。今回の比較は、どちらにも当たらないと判断しています。
指数で首位になったモデルを、そのまま日本語の商品照合に持ち込むのではなく、同じ行で比べてから決めてもらえたらと思います。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事

Perplexity DeciderはJevから替える?11対0の判定差
Perplexity Decider V1.2を楽天の同一商品判定でJev・OpenAI・Clefと同じ89行で実測。正解率は合格線に1行届かず、版数語の取り違えは6モデル中最少でした。

OpenAI DecisionsはJevから乗り換え?単価2.4倍の答え
OpenAIのDecisions API(gpt-6-luna)をJev・Clefと同じ日に楽天89行で実測。型番違いの見落とし、確信度で任せられる件数、実費の差を整理しました。
Clefへの乗り換えは待ち——Jevを選ぶ日本語判定、画像だけは別
楽天商品89行とサムネ9枚を同日比較。日本語ECの版数判定はJev、画像判定はClefが候補になる理由を実測で整理します。
Jevが効く人、不要な人——選択肢を先に並べられるか
元OpenAI研究者が作った「文章を返さないAIモデル」Jev を、公式ブログ・プライバシーポリシー・上流報道の一次情報だけで読み解きます。193.6倍速の正体、『ハルシネーションしない』が何を保証していて何を保証していないか、そして公開当日に出た独立検証の数字まで。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:開発環境・キャリアまわりのサービス
 シンVPSを見る
 XServer VPSを見る
 strategy career の転職支援を見る