Jevが効く人、不要な人——選択肢を先に並べられるか
元OpenAI研究者が作った「文章を返さないAIモデル」Jev を、公式ブログ・プライバシーポリシー・上流報道の一次情報だけで読み解きます。193.6倍速の正体、『ハルシネーションしない』が何を保証していて何を保証していないか、そして公開当日に出た独立検証の数字まで。
こんにちは。店先に秋の果物が並び始めましたね。今回は、しゃべらないことを売りにした、ちょっと変わった AI モデルの話です。
2026年9月15日に発表された「Jev」は、文章を書かないAIモデルです。書けないのではなく、書かないように作られています。答えの選択肢をこちらが先に全部並べられる仕事、つまり「小さな判断を、大量に、速く」こなしたい人には効きます。逆に、文章を作りたい人や、何を聞くかを事前に決めきれない人には要りません。もう一つ大事なのは、公式がうたう「ハルシネーションしない」が保証しているのは答えの型であって、判断の正しさではないという点です。公開当日に出た独立テストでも、速さと安さの方向性は再現された一方、精度は上位の推論モデルに1件負けていました。なお、私自身はまだ Jev を動かしていません。この記事は公式情報と報道、第三者のテストを読み比べた整理です。
作ったのは TypeSafe AI というサンフランシスコの会社で、CEO は元OpenAIの研究者です。正直に申し上げると、私はこの手の「新カテゴリを名乗る発表」を、普段はあまり真に受けません。ただ今回は主張の構造が面白かったので、一次情報を当たってみました。読んでみると、筋が通っている部分と、注意深く読まないと誤解する部分がきれいに分かれていたので、その線引きを共有します。正体のよく分からないモデルを証拠から読み解く話としては、Ox Alpha、GLM説は優勢でも正体不明——トークナイザ証拠が矛盾 もあわせて読むと、今回の論点とのつながりがつかみやすいと思います。
作文ではなくマークシートを塗るAI
公式ブログの定義が、いちばん正確です。
a frontier-intelligence function call: unstructured state in, typed probabilistic decisions out
訳すと「最先端の知能を関数呼び出しにしたもの。構造化されていない状況を入れると、型付きの確率的な判断が出てくる」。同社はこれを System One モデルと呼んでいます。カーネマンの『ファスト&スロー』でいう、速い直感的な思考(システム1)からの命名で、じっくり考える推論モデル(システム2)とは別の生き物だ、という主張ですね。
たとえるなら、作文とマークシートの違いです。従来のLLMLLM(大規模言語モデル)大量の文章で学習し、人のように文章を読み書きできる大きな AI のモデル。詳しく →(ChatGPT のような文章を生成するAI)は作文をします。文字を一つずつ順番に書いていって、書き終わるまで答えが確定しない。JSON(プログラムが読み取りやすいデータの書き方)で返させても、それは「JSON に見える文章を書いている」だけなので、型が崩れることもあれば、存在しない項目をでっち上げることもあります。ここで苦労した方は多いと思います。
Jev のほうはマークシートです。答えの選択肢をこちら側が先に全部渡して、Jev はそこに確率を塗るだけ。文章は一切書きません。
| 従来のLLM | Jev | |
|---|---|---|
| 出力 | 文字列 | 型の決まった値+確率 |
| 生成の仕方 | 1トークンずつ順番に | まとめて1回で |
| 学習の狙い | 人間が好む応答(RLHF) | 確信度の正確さ(RLCD) |
| 応答時間 | 3〜329秒 | 70〜500ミリ秒 |
| 出力の課金 | 入力の約5倍高い | 無料("too cheap to meter") |
速さと安さは「頑張って最適化した」結果ではありません。書く仕事をやめたからです。出力トークン(AI が数える文字の単位)がほぼ存在しないので、課金しようがない。ここは構造の話なので、素直に納得できます。
実は表の3行目が一番おもしろいところです。従来のLLMに「自信は何%ですか」と聞いても、返ってくる数字はあまり当てになりません。較正(言った確率と実際の的中率をそろえること)がされていないからです。Jev は逆に、そこだけを学習の目標にしている。「70%と言ったら本当に7割当たる」を目指したモデルだ、と説明されています。
193.6倍速は自己申告で、公式自身が予防線を張っている
公式トップには、こんな比較ウィジェットが置かれています。
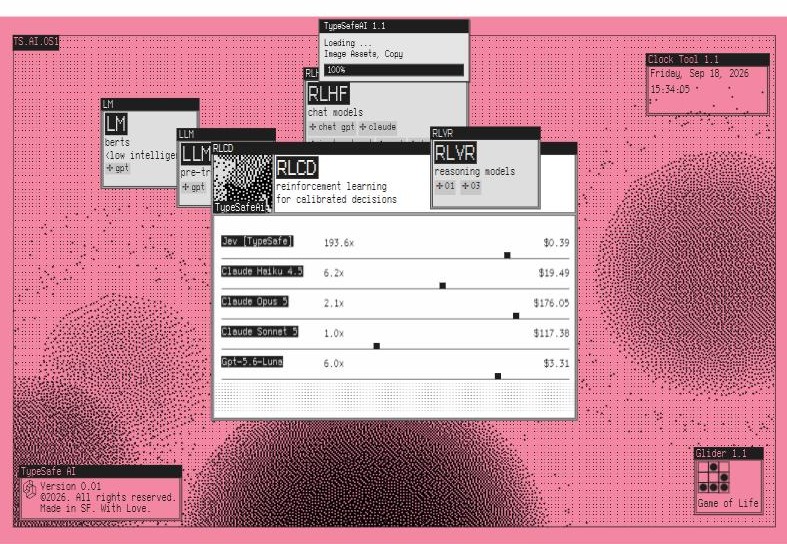
公式トップに掲げられた自社比較。数値はすべて TypeSafe 側の自己申告(2026年9月18日時点)
Jev が 193.6倍・$0.39。Claude Opus 5 が 2.1倍・$176.05、Claude Sonnet 5 が 1.0倍・$117.38、GPT-5.6 Luna が 6.0倍・$3.31。入力価格は100万トークンあたり $0.042 で、出力は "too cheap to meter"(計測する価値もないほど安い)として無料です。
数字だけ見ると景気のいい話ですが、この数値はすべて TypeSafe 側の自己申告です。しかも公式ブログ自身が、測定に使ったワークフローについて「自社のモデル能力チームの人間が作ったものなので、バイアスがあるかもしれない」(they were made by individuals on our model capabilities team, so some bias could exist)と書き、さらに「これらは実世界での伸びとしては高めの部類だと予想している」(we expect that these are on the higher end of real world gains)と続けています。自分で予防線を張っているわけですね。この正直さには好感が持てますが、読者としては割り引いて読むところです。
「ハルシネーションしない」は型の保証で、中身の正しさではない
ここが、この記事でいちばんお伝えしたい点です。
公式は Jev について "can't hallucinate"(幻覚を起こせない)と書いています。ハルシネーションとは、AI がもっともらしい嘘をつくことです。強い言葉ですが、同じページの注記で「これは実測ではない」と自ら認めています。
Our number is not empirical. Schema matching is guaranteed, thus we can confidently add 0% into the plots.
グラフに並んでいる「幻覚率 0%」は、測って 0 だったのではなく、スキーマ(あらかじめ決めた答えの型)の一致が保証されているから 0 と置いた、と書いてあるわけです。
つまり保証されているのは「出力が必ず事前に決めたスキーマに収まる」ことであって、「判断の中身が正しい」ことではありません。型は絶対に守るけれど、間違った選択肢を確信をもって選ぶことは普通にありえます。
マークシートで言えば、塗る場所は必ず選択肢の枠内におさまる(これは数学的に保証される)けれど、塗る場所を間違えないとは言っていない。ここを混同すると「幻覚ゼロのAIが出た」という、まったく違う話になってしまいます。
渡すのは「状況」と「質問」の2つだけ
使い方は拍子抜けするほど単純です。渡すのは state(状況を書いた文章)と questions(質問の集まり) の2つだけ。質問には3つの型があります。
- noul — はい/いいえの判定。0〜1の確率が返る
- choice — 選択肢から1つ選ぶ。選ばれたキー+確信度+全選択肢の確率分布が返る
- score — 段階評価。数値+確信度+各段階の確率が返る
公式のサンプルは、カスタマーサポートに届いた1文に対して3つを同時に聞くものです。
const response = await env.AI.run('typesafe/jev', {
  state: 'Help! My payouts have been failing for 3 days.',
  questions: {
    is_urgent: {
      type: 'noul',
      instructions: 'Does this convey urgency?',
      criteria: { true: 'Explicitly time-sensitive', false: 'No urgency expressed' },
    },
    department: {
      type: 'choice',
      instructions: 'Which team should handle this?',
      criteria: {
        billing: 'Payments, invoicing, refunds',
        technical: 'Bugs, outages, integrations',
        sales: 'Pricing, upgrades, new accounts',
      },
    },
    frustration: {
      type: 'score',
      instructions: 'How frustrated is the customer?',
      criteria: ['Calm', 'Frustrated', 'Very angry'],
    },
  },
})
「支払いが3日間失敗している」という問い合わせに対して、急ぎかどうか、どの部署が担当すべきか、どれくらい怒っているかを一度に聞いています。返ってくるのは、質問ごとの答えと probabilities(全選択肢の確率)、confidence(確信度)、そして使用トークン数です。マークシートのたとえが、そのまま形になった構造ですね。
価格について一つ補足します。入力 $0.042/100万トークン・出力は最大トークン数が0のため課金なし、という数字はゲートウェイ(複数のAIモデルをまとめて提供する窓口サービス)側の掲載値です。つまり価格に関してだけは、TypeSafe の自己申告ではない裏が取れています。一度に読める長さ(文脈長)は、Cloudflare の記載で32,000トークンです。
効くのは「小さな判断を、大量に、速く」
判断基準は一つです。小さな判断を、大量に、速くなら効く。文章を作るなら効かない。
効く場面:
- ループの中の判断。エージェント(AI が自分で手順を進める仕組み)が毎ステップ「次はどうするか」を決めるところ。いま一番遅くて高い部分です。公式デモでは Doom を毎秒10回の判断で動かしており、その費用は1時間あたり約7ドルと書かれています
- 大量の仕分け。問い合わせの振り分け、優先度付け、通報の一次トリアージ。1日に何万回も走るもの
- リアルタイム制約があるもの。数百ミリ秒で決めないと間に合わない処理。従来のLLMは秒単位なので、そもそも土俵に乗りません
- 閾値で自動と手動を分けたいもの。これが較正の実利です。「確信度85%以上は自動処理、それ未満は人間に回す」という設計が、初めてまともに成立します
効かない場面:
- 文章を書く・要約する・コードを書く(構造上できません)
- 選択肢を事前に列挙できない問題。ここが最大の適用条件で、「何を聞くか」を人間が先に設計しきれないと使えません
- 呼び出しが1日数回しかないもの。速度も価格も効きません
- 画像入力。Doom のデモも画像ではなくテキストの構造化データに対するもので、公式は "not on images (yet…)" と書いています
迷うとしたら、たぶん「選択肢を先に並べきれるか」の一点だと思います。なお選択肢は255個まで(cardinality up to 255)という制限があり、それを超える場合は「まず点数を付けて、次に選ぶ」の2段構えにする必要があるそうです。
素性は報道で裏が取れ、データの扱いは「学習しない」以外がまだ粗い
新興のAI企業となると、素性が気になる方もいると思います。調べた範囲を置いておきます。
TypeSafe AI は米国サンフランシスコの会社です。CEO の Diogo Almeida 氏は OpenAI で4年間 ChatGPT の応答改善に取り組み、2024年に退職して同社を創業しました(The Register は同氏を「RLHF と ChatGPT の共同発明者」とも紹介しています)。共同創業者は同氏を含む3名。DCVC 主導で4,000万ドルのシードを調達し、評価額はおよそ2億ドルと Forbes が関係者情報として報じています。
プライバシーポリシーには、良い点と粗い点が両方ありました。良い点ははっきりしています。
We will not train or fine tune any artificial intelligence or machine learning models on your prompts or other Input.
入力を学習には使わない、と言い切っていて、しかも文書内で2回繰り返されています。
粗い点には、若い会社らしさがそのまま出ています。SOC 2(企業向けのセキュリティ認証)の記載がない。GDPR(EU の個人データ保護の規則)への言及もない。再委託先の一覧が公開されていない。保存期間が「事業目的の支援のため」と、実質期限なしに等しい書き方。ついでに言うと、この文書の発効日は2025年11月19日のまま、つまりステルス(非公開の開発期間)を出る10か月前の版が置かれています。
気にすべきは国籍ではなく、企業向けの体裁がまだ整っていない段階だということです。試すなら、漏れても困らないデータから。社内の機微情報を流すのは、認証や再委託先の開示が出てからで十分だと思います。
試すならゲートウェイ経由が早い。ウェイトリストの入力欄には罠がある
ゲートウェイ経由なら、待たずに使えます。 発表直後は公式のドキュメントサイトが404で使い方すら分かりませんでしたが、現在は Cloudflare Workers AI と Vercel AI Gateway で提供されており、Cloudflare 側に完全なAPI(プログラムから呼び出す窓口)の仕様が載っています。TypeSafe から直接APIを借りたい場合だけ、ウェイトリストに並ぶことになります。
ウェイトリストの手順自体は3動作で終わります。
- 公式サイト右上の「Join Waitlist」を押す
- 右上に開くパネルにメールアドレスを入れる
- submit を押す。「Waitlist Joined」と出たら完了
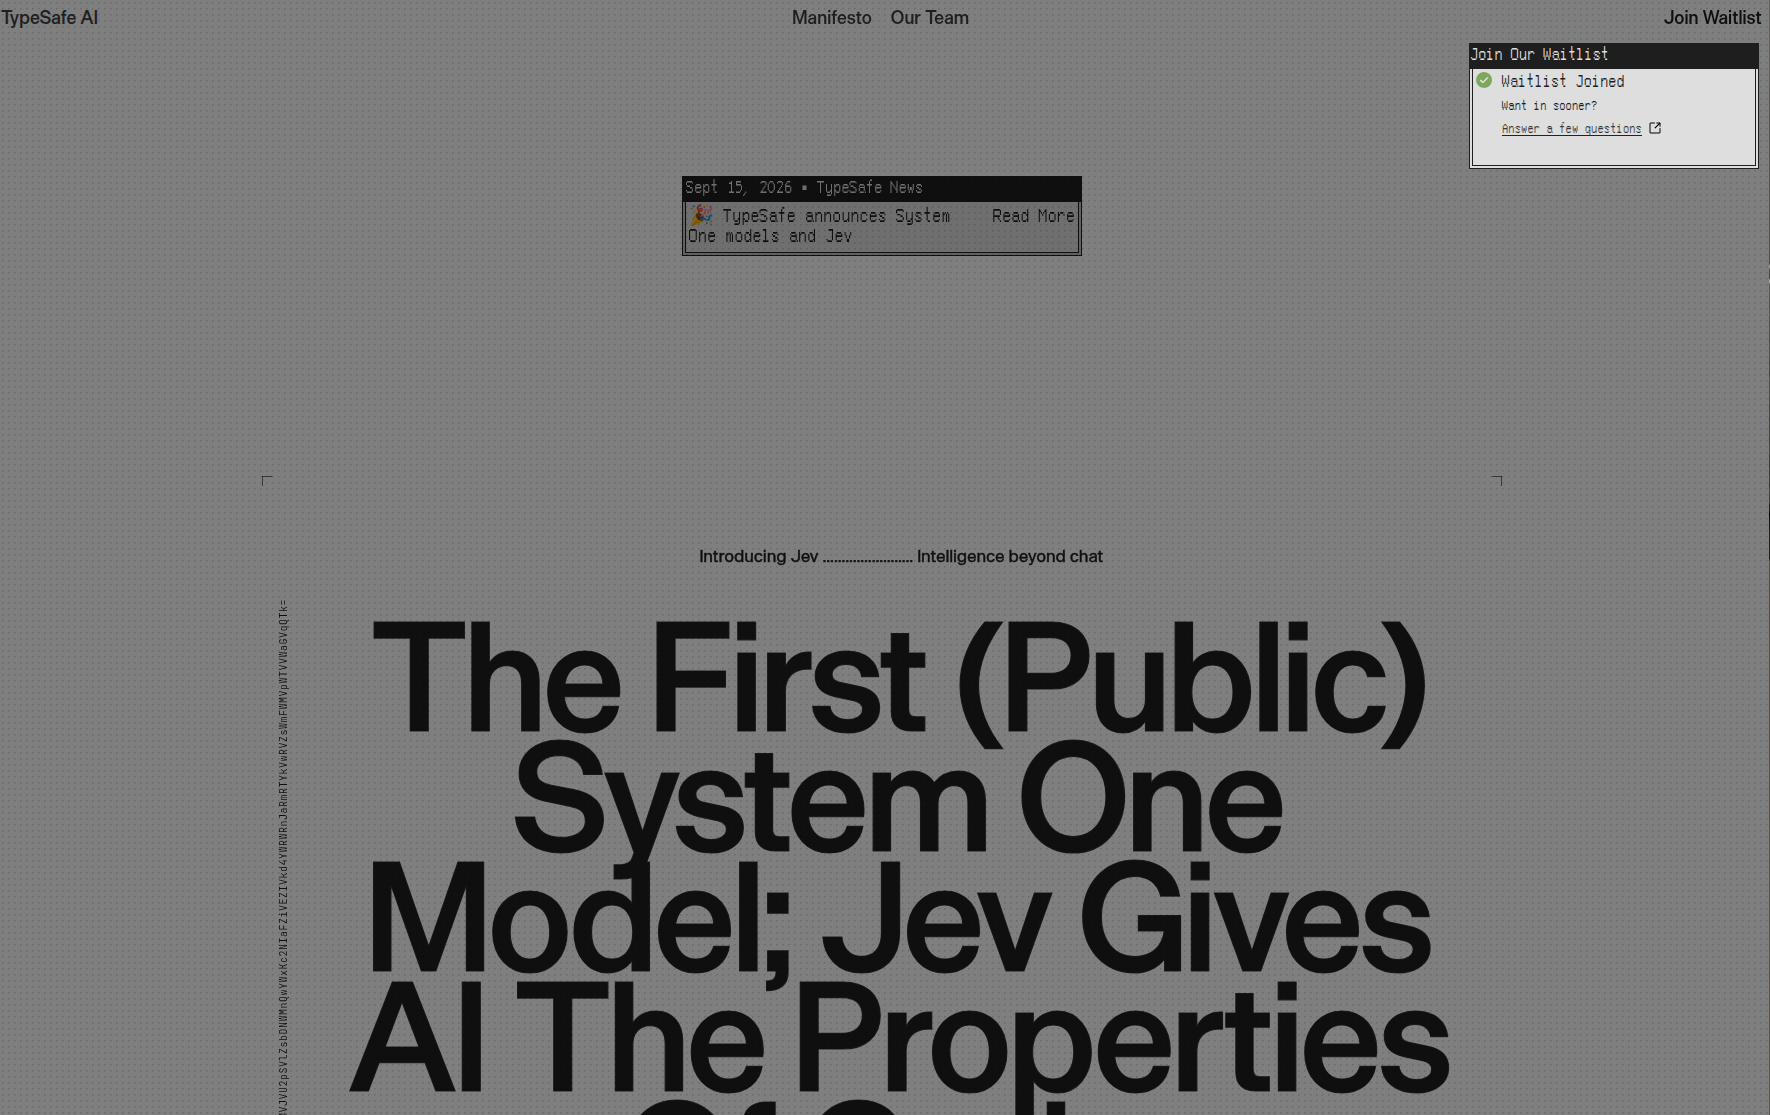
登録完了の表示。この後に任意アンケートへの導線が出る
完了後に「Want in sooner?(もっと早く入りたい?)」というアンケートへの導線が出ます。用途・職域・会社規模などを聞かれ、「誰を先に案内するか決める材料にする」と明記されているので、早く触りたい方は答えておくとよいでしょう。設問の中では「最初に何に試したいか」の自由記入が、実質的な勝負どころです。
一つ実用的な注意があります。 このフォーム、入力欄が全部で12個あるのですが、人間に見えているのはメールアドレスの1つだけです。残る11個(website、company、message、subject など)はラベルも枠も無く、画面に現れません。
これはボット判定用の罠、いわゆるハニーポットです。自動入力ツールやブラウザの一括補完で全部埋めてしまうと、それだけで機械と判定されて弾かれる可能性があります。手で入れるぶんには何も問題ありませんが、自動化で登録しようとしている方はご注意ください。
独立検証は1本だけ。速さと安さは再現、精度は1件負け
ここは調べていて認識が変わったところです。
発表直後は「誰も確かめていない」状態だと思っていたのですが、公開当日に独立したテストが1本出ていました。Every の Mike Taylor 氏によるもので、自分で用意した文章を Jev に判定させたという内容です。
- 37文書(本人の実記事27本+AIらしく書き直した10本)に21問を同時に投げ、777判定が0.7秒未満・費用は約0.25セント
- 別の比較テストでは、意図的に欠陥を入れた文章を Jev と Claude Fable 5.1 の両方に判定させています。速度は Jev が中央値0.35秒/文、Fable が8.83秒/文で約25倍速。費用は 約580分の1
速い・安いという方向性は再現されました。ただし倍率は、公式の 193.6倍・444.6倍よりだいぶ小さい。「タスクが違えば倍率も違う」という当たり前のことが、数字で確認できたかたちです。
そして精度のほうが示唆的でした。仕込んだ欠陥7件のうち、Fable は7件すべてを見つけ、Jev は6件。落としたのは「共有カレンダーを親と職員が一緒に teach する」という、意味の通らない動作を指摘する問題で、3回試して3回とも見逃したそうです。テストした本人も「本番に入れる前にもっと入念な精度チェックをしたい」と締めくくっています。
速さと安さは本物に近い。精度は、少なくともこのテストでは上位の推論モデルに1件負けた。これが今わかっている一番確度の高い情報です。
肝心の較正は、外からの検証がまだ見当たらない
一方で、次の点はまだ誰も外から検証していません。
- 較正の検証。「85%と言った判定が本当に85%当たるか」を外部から測った例は、私の調べた範囲では見つかりませんでした。Jev の売りの中心はここなので、本来いちばん検証されるべき部分です
- 公式ベンチマークの物差し。同社の評価は他のモデル(GPT-6 Astra や Claude Fable 5.1)との一致率で測られており、独立した正解データに対する採点ではありません。上位モデルが間違えている問題では、一致していること自体が正しさの証拠になりません
- 再現性。重み・学習データ・パラメータ数・アーキテクチャの論文はいずれも未公開です。第三者が同じ条件で検証する手段がありません
- 文章が必要な場面で従来のLLMとどう組み合わせるのか、公式は具体的な方法を説明していません
ただ、提供が始まった今は、較正の検証は誰でもできる状態になりました。正解データが手元にある方なら、やることは「85%と言った判定の的中率を数える」だけです。順番が回ってきたら、私も試して数字を出すつもりです。そのときはまた書きます。
出典
- Introducing System One Models & Jev(TypeSafe AI 公式ブログ)
- TypeSafe AI 公式サイト
- TypeSafe AI プライバシーポリシー
- This $200 Million Startup Wants To Fix AI's Overconfidence Problem(Forbes)
- TypeSafe AI debuts model for machines that plays Doom(The Register)
- Jev モデル仕様(Cloudflare Workers AI 公式ドキュメント)
- Jev(Vercel AI Gateway のモデルページ)
- Mini-Vibe Check: TypeSafe's Jev Judged Everything I've Written in 0.7 Seconds(Every / Mike Taylor)
検証日・環境
- 調査日: 2026年9月18日
- 方法: 公式ブログ・公式サイト・プライバシーポリシーの直接確認、ゲートウェイ2社のモデルページでの提供状況と価格の確認、および上流報道と独立検証記事の突き合わせ。ウェイトリスト登録フォームは実際に登録して画面と入力欄の構成を確認
- 重要な注記: 本記事の時点で Jev は未実測です(提供は始まっていますが、筆者はまだ実際にモデルを動かしていません)。速度・価格・較正に関する数値はすべて TypeSafe 社の公表値か、Every による第三者テストの値であり、筆者による実測ではありません
関連記事
- 商品台帳657組を判定モデル TypeSafe Jev で再判定——文字列照合の盲点13件と判定不能147組——本記事の実測編。自サイトの商品台帳657組に Jev を当てて、効く場所と効かない場所を線引きしました
- Ox Alpha、GLM説は優勢でも正体不明——トークナイザ証拠が矛盾
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
ほかの関連記事
Kimi K3.1 Pro、中国勢で断トツの賢さ。ただし値段は Sonnet 5.5 と同じ
10月23日に出たKimi K3.1 Proを、Artificial Analysisの知能指数と単価で中国勢・米国勢と比較。中国勢では2位に8.8点差の断トツ、値段は入力$2・出力$10でSonnet 5.5と同じ。
Claude Opus 5、全effort段でSol凌駕——秘めた実力とコスト最適化の結論
Claude Opus 5とGPT-5.6 Solを同じeffort段で並べると、low/medium/high/xhigh/maxの5段すべてでOpus 5が上回りました。mediumがSolのhighを超え、lowですらSolのmaxより嘘をつかない。独立実測データから、常用すべき段とコスト最適化の答えを出します。
DeepSeek V4.1 Flash、1017へ替える?賢さ同じ・費用−58%
DeepSeek V4.1 Flash-1017を9月版と同じ日・同じ配信事業者で比較。楽天の型番判定572回と29問に加え、Gemini 3.8 Flash・GPT-6 Luna・Claude Haiku 5.5とも同じ89行で並べました。

Muse Spark 1.3とGLM-5.3-Flash、知能4点差で単価6倍
Muse Spark 1.3のStandardとContributorを、GLM・Qwen・Geminiと知能、単価、速度、データ条件で比較します。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:開発環境・キャリアまわりのサービス
 シンVPSを見る
 XServer VPSを見る
 strategy career の転職支援を見る