商品台帳657組を判定モデル TypeSafe Jev で再判定——文字列照合の盲点13件と判定不能147組
自サイトの商品台帳657組を判定モデル(TypeSafe Jev)で再判定した一次検証。文字列照合が構造的に見逃す「登録名が部分集合になる」誤りを13件見つけ、判定不能147件の66%に決着をつけた記録。指示文を厳しくしても総得点が4/6のまま動かなかった実測まで。
こんにちは。秋の長雨で外に出にくい日が続くと、溜めていた点検仕事に手をつけたくなりますね。
先に結論です。文字列照合(名前の単語が一致するかを機械的に見る、昔ながらのやり方)が「判定不能」と投げ出した147件のうち97件に、AIが決着をつけました。人間が目で見るはずだった山は約50件、つまり3分の1まで減っています。かかったのは11秒と0.4円です。ただ、この記事でいちばん驚いたのはそこではありませんでした。測るために当てたAIが、測る側の物差しの狂いを先に暴いてしまったのです。
使ったのは、文章を返さず「判定だけ」を返す新しいタイプのAIモデル(TypeSafe の Jev)です。何者かは解説編の Jevが効く人、不要な人——選択肢を先に並べられるか に書いたので、気になる方は先にそちらをどうぞ。ここでは、うちのデータで試したら何が起きたかを順番に書きます。
発端:CPU のページにノートパソコンが紐づいていた
自分のサイトの商品台帳が、まったく別の商品を指していました。CPU 単体の製品ページに、その CPU を積んだノートパソコン本体が紐づいていたのです。しかも、それを見つけたのは人間ではありませんでした。
きっかけは軽い思いつきです。判定専用のAIが出たので、うちのデータで試してみようと。ところが試した結果、測ろうとしていたモノサシのほうが狂っていたことが分かってしまいました。まずは、その物差しの話から始めます。
文字列で商品を照合していた
うちのデータベースには PC パーツの製品情報が入っていて、それぞれに Amazon の商品ページが紐づいています。読者はそのリンクをたどって買えるようになっています。
問題は、その紐づけが本当に正しいかをどう確かめるかです。手作業では追いつかないので、短いプログラムを書いて機械的に判定させていました。中身は単純です。
登録名を単語に割る。その単語が全部、Amazon のタイトルに出てくるか調べる。全部あれば「一致」、ひとつでも無ければ「不一致」。
657組を判定させた結果がこちらです。
| 判定 | 件数 |
|---|---|
| 一致 | 229 |
| 不一致 | 121 |
| 判定不能 | 147 |
| 取得失敗 | 160 |
白黒つけられたのは350組。147組は「判定不能」として人間送りになります。この147組を目で確かめるのが、地味に重い作業でした。
盲点:登録名が「部分集合」になると見逃す
この方式には穴があります。タイトル側に余計な単語があっても気にしないのです。具体例を出します。
登録名   : MSI  B760M  Mortar  WiFi
タイトル : MSI  MAG  B760M  Mortar  WiFi  II
登録名の4語は、すべてタイトルに出てきます。だからプログラムは「一致」と答えます。でも実際は別製品です。II は後継世代なので。
「足りない語」は見つけられるのに、「余計な語」は見つけられない。片側にだけ目が開いている状態でした。書いていた時は気づきませんでした。
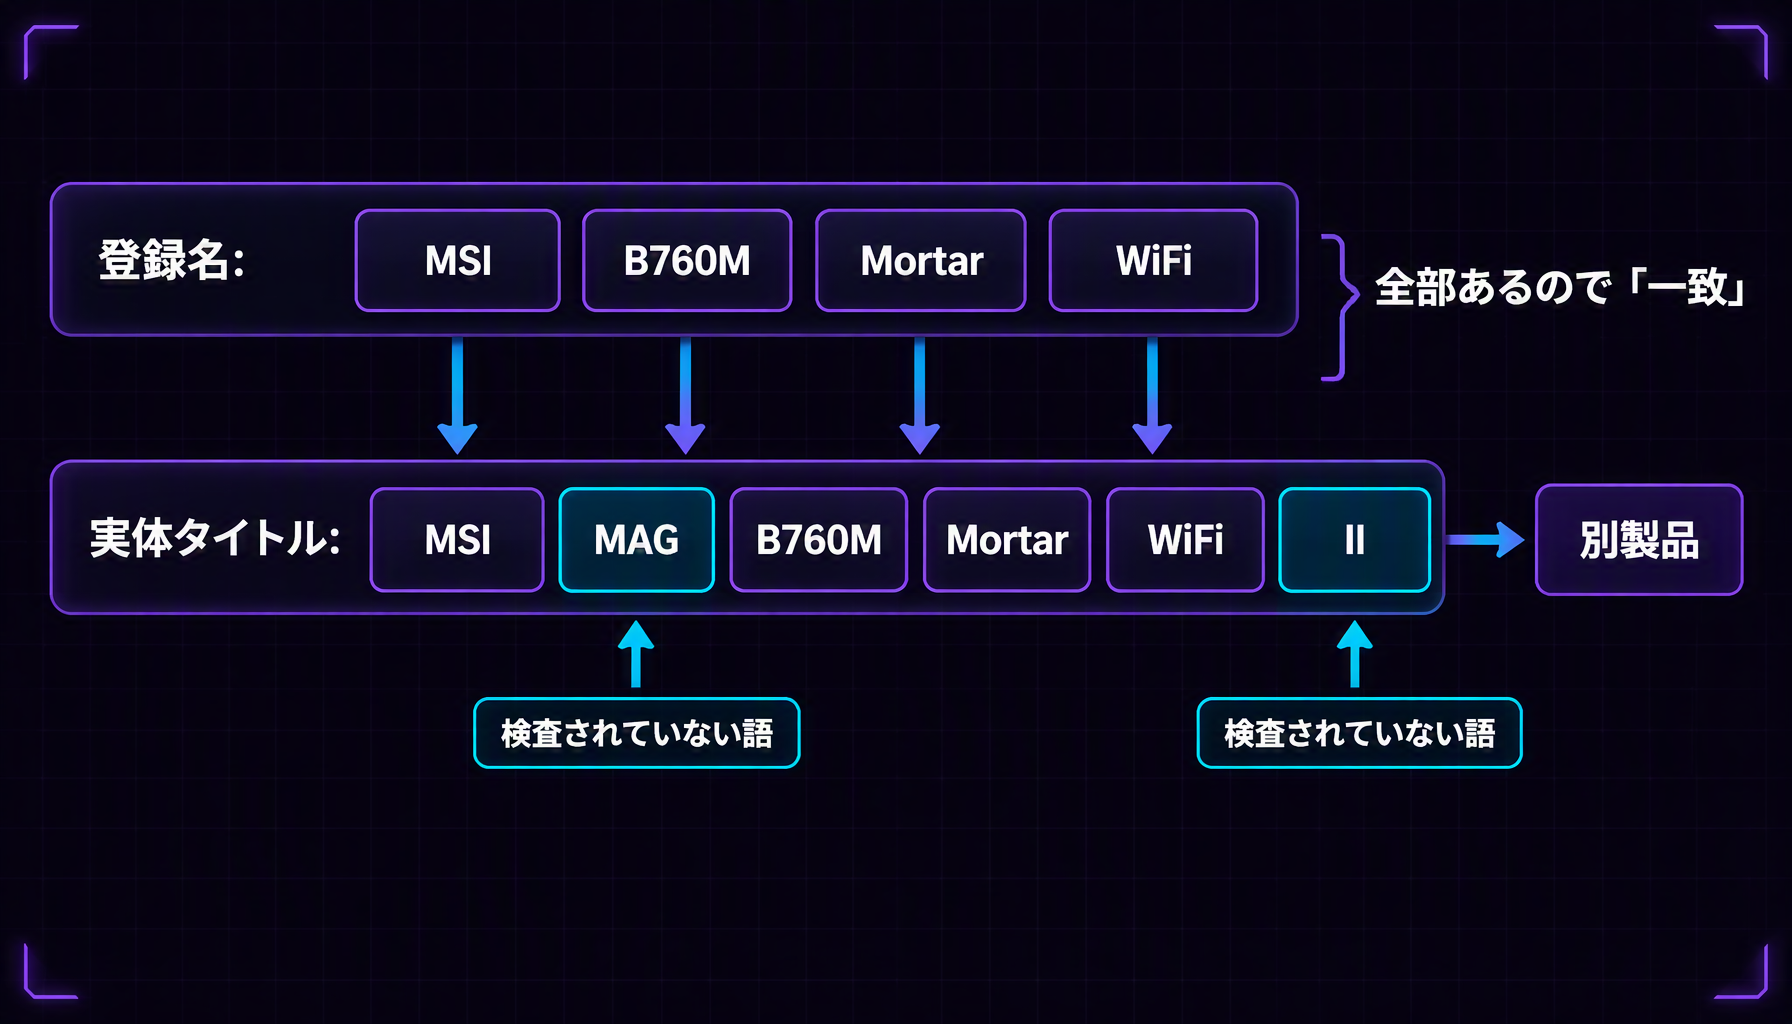
登録名の語は全部ある。足りないのは「余計な語を見る目」のほう
実験1:決着済みの350組をAIに見せたら、間違っていたのはプログラムだった
そこで、文字列ではなく意味で判定するモデル(Jev)に、同じ350組を投げました。渡すのは2行だけです。
登録されている製品: Samsung 990 EVO 2TB
通販サイトのタイトル: Samsung 990 EVO Plus SSD 2TB、PCIe Gen 4x4…

質問: この2つは同一の製品を指していますか
返ってくるのは文章ではなく、数字がひとつです。
0.04
「同一である確率は4%」、つまりほぼ別物だという判定です。
プログラムの判定と突き合わせると、一致率は77.1%。残る80組で意見が割れました。普通なら「AIの正答率は77%か」と読むところです。でも一件ずつ見ていって、血の気が引きました。間違っていたのは、AIではなくプログラムのほうでした。
| 登録されている製品 | 実際のAmazonタイトル | プログラム | AI |
|---|---|---|---|
| AMD Ryzen AI 9 HX 375(CPU単体) | HP EliteBook X G1a ノートブック… | 一致 | 0.28 |
| Samsung 990 EVO 2TB | Samsung 990 EVO Plus SSD 2TB | 一致 | 0.04 |
| MSI B760M Mortar WiFi | MSI MAG B760M Mortar WiFi II | 一致 | 0.04 |
| ARCTIC Liquid Freezer III 280 | Liquid Freezer III Pro 280 | 一致 | 0.06 |
| Cooler Master NR200P | MasterBox NR200P V2 | 一致 | 0.10 |
冒頭の一件がこの1行目です。CPU の製品ページに、その CPU を搭載したノートPC本体が紐づいていました。 こういう誤った紐づけが、目で見て確定できたものだけで最低13件見つかりました。
誤りは読者の画面までは届いていなかった
血の気が引いたまま直しに走りかけて、踏みとどまりました。台帳が間違っていることと、読者がその間違いを踏むことは、別の事実だからです。公開中のページを実際に開いて、購入ボタンのリンク先を確かめました。
https://www.amazon.co.jp/s?k=AMD+Ryzen+AI+9+HX+375&tag=metamark-22
製品名での検索結果でした。 ノートパソコンの商品ページではありません。
理由を追うと、購入ボタンは台帳の商品コードを読んでいませんでした。別の欄を見ていて、そこが空なら製品名で検索する作りだったのです。誤った商品コードは画面まで届いていませんでした。
実際に歪んでいたのは、内部のおすすめ記事の並び順です。「商品コードが登録されている製品は購入意欲が高い」という加点があり、そこに誤った加点が混ざっていました。痛いけれど、読者が別の商品を買わされる話ではありません。 同じ構図は以前にも一度あって、その時の調査メモにも「表示には出ない」と書き残してありました。同じ罠を二度踏んだわけです。
洗い出した候補のうち7件は、公開前に台帳から外しました。ノートPC用やタブレット用のチップで、そもそも部品単体では売られておらず、正しい商品コードが存在しないと分かったからです。残りの約20件は「990 EVO と 990 EVO Plus」のような近い別製品で、正しいコードに差し替える必要があるので、宿題として残っています。
AIの弱点:タイトルの情報が足りないと甘くなる
とはいえ、AIが万能というわけでもありません。逆方向、タイトルの情報が足りない場合は甘く判定します。
| 登録されている製品 | 実際のAmazonタイトル | 正解 | AI |
|---|---|---|---|
| be quiet! Dark Rock Slim 2 | be quiet! Dark Rock Slim(2 が無い) | 別物 | 0.87 |
| Cooler Master CK352 | Home Styles Cooler Master…(型番なし) | 別物 | 0.52 |
こちらはプログラムのほうが正しい。語が足りないケースは、文字列照合が確実に弾ける領域でした。
実験2:プログラムが匙を投げた147組の66%に決着
本題はここからです。「判定不能」とされた147組。この集合でのプログラムの正答率は、定義上ゼロです。何も答えを出していないのですから。なぜ答えられなかったのか、理由を集計しました。
| 件数 | 詰まった理由 |
|---|---|
| 57 | 語の欠落 |
| 47 | 語として独立して現れない |
| 17 | アクセサリの疑い(本体か付属品か不明) |
| 13 | 容量・規格値がタイトルに無い |
中身を見て納得しました。日本語と英語が混ざっているのです。 MasterBox TD500 **Mesh** に対してタイトルは TD500 **メッシュ**、Vault **Series** に対して Vault**シリーズ**。be quiet! に至っては 静かに! と機械翻訳されていました。be quiet! の ! が語として扱えずに破綻する、というものもあります。
置き換えの対応表を書き足しても追いつきません。Mesh→メッシュ を書いたら、次は Series→シリーズ、その次は be quiet!→静かに! です。
この147組にAIを当てました。そして答えを見る前に、40組を自分の目で判定して答え合わせをしています。
| 結果 | |
|---|---|
| はっきり判定できた割合 | 66%(確率0.2以下または0.8以上) |
| 人間の判定との一致率 | 85.0%(40組で検証) |
| 判断が明確な32組のみ | 87.5% |
| 147組の所要時間 | 11秒 |
| 147組の費用 | 約0.4円 |
私が迷った8組を除くと、一致率は上がります。人間が迷う問題では、AIも迷っていました。
際どい案件だけ、答えが少し揺れる
文字列照合の大きな美点は、何度実行しても答えが変わらないことです。AIはどうか。同じ入力を5回ずつ投げました。
| ケース | 5回の結果 | 揺れ幅 |
|---|---|---|
| 明確に別物 | 0.06 / 0.05 / 0.05 / 0.06 / 0.05 | 0.01 |
| 際どい | 0.65 / 0.61 / 0.64 / 0.61 / 0.61 | 0.04 |
| 明確に同一 | 0.96 / 0.96 / 0.96 / 0.96 / 0.96 | 0 |
明確なものは1ミリも動かず、際どいものだけ揺れます。
これは実務では無視できません。「0.63以上なら自動処理」と線を引くと、真ん中の案件は実行のたびに通ったり弾かれたりします。境目(閾値)は、揺れ幅より余裕をもって引く必要があります。裏を返せば、答えが揺れていること自体が「これは際どい」という信号として使えます。
指示文を厳しくしても、総得点は4/6のまま動かなかった
判定の基準は日本語の一文で渡します。ならば書き方を工夫すれば精度が上がるはず。そう考えて、3通りの指示で同じ6件を判定させました。C の指示には「世代・グレード・色・容量が違えば別製品。タイトル側に登録名に無いグレード語が付いていたら必ず別製品と判定せよ」と厳しく書いています。
| ケース | 正解 | A 素朴 | B 現行 | C 厳格 |
|---|---|---|---|---|
| Trinity vs Trinity Performance | 別物 | 0.70 ✗ | 0.64 ✗ | 0.23 ✓ |
| B760M Mortar WiFi II | 別物 | 0.12 ✓ | 0.05 ✓ | 0.02 ✓ |
| 990 EVO Plus | 別物 | 0.11 ✓ | 0.04 ✓ | 0.02 ✓ |
| Dark Rock Slim 2 | 別物 | 0.84 ✗ | 0.87 ✗ | 0.62 ✗ |
| EIZO CS2740 | 同一 | 0.96 ✓ | 0.96 ✓ | 0.86 ✓ |
| 「静かに! ダークパワー13」 | 同一 | 0.89 ✓ | 0.87 ✓ | 0.41 ✗ |
| 正答数 | 4/6 | 4/6 | 4/6 |
狙いどおり Trinity は直りました。0.70 から 0.23 へ。ところが同時に、正しく同一だった「静かに! ダークパワー13」が 0.89 から 0.41 に落ちて、誤答に転じています。 直した分と壊した分が相殺し、総得点は 4/6 のまま動きません。
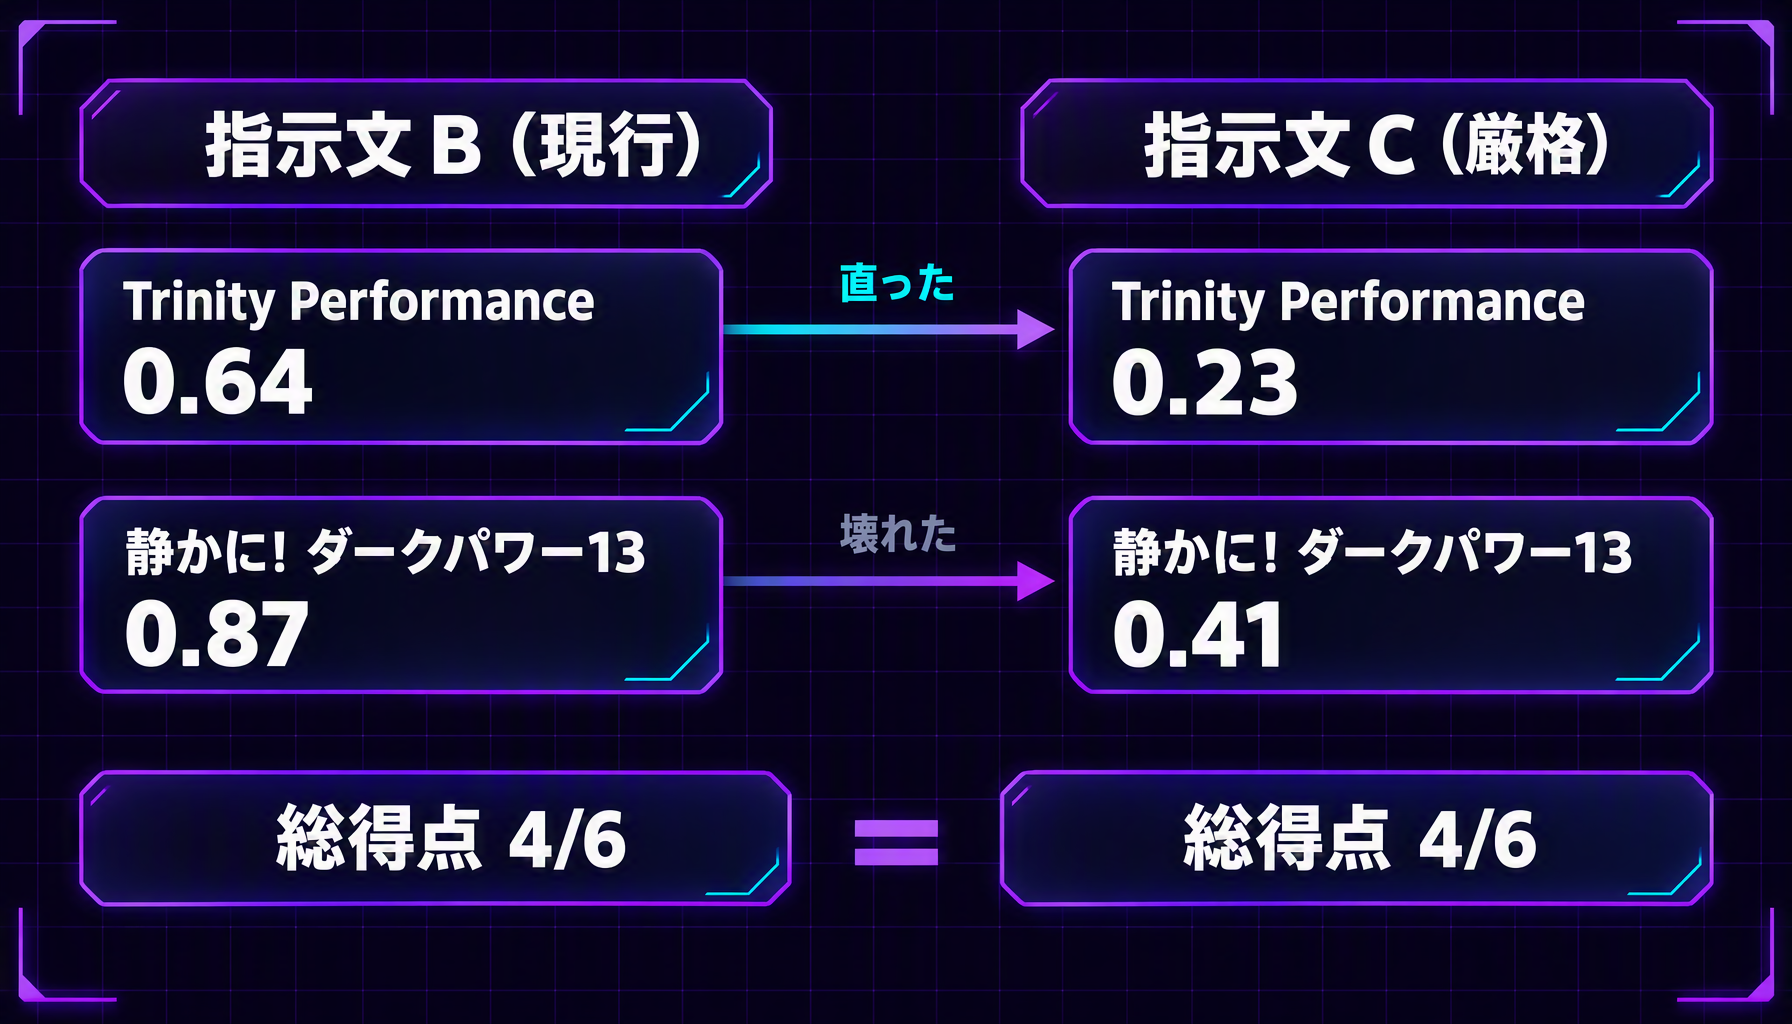
厳しくしても総得点は動かない。入れ替わるのは誤りの種類だけ
ここが今回いちばん意外だった発見です。指示文は、精度を上げる道具ではありませんでした。「どちら側の誤りを許容するか」を選ぶツマミです。厳しくすれば別製品を通す誤りは減り、同じ製品を弾く誤りが増える。業務上どちらの間違いが痛いかで、書き方を決めることになります。うちの場合は読者を別商品に飛ばすほうが痛いので、厳しめが正解です。
もうひとつ。Dark Rock Slim 2 のケースは3通りすべてで誤答でした。0.84 → 0.87 → 0.62 と下がりはしますが、0.5 を割りません。「語が足りない」は指示文では直らない構造的な弱点です。
置き換えではなく、分担にした
実験を通して、二つのやり方の得意・不得意がきれいに分かれました。
| 文字列照合 | 判定モデル | |
|---|---|---|
| 得意 | 語が足りないケース。速い・タダ・毎回同じ | 表記ゆれ・翻訳・記号。意味での同一性 |
| 不得意 | 余計な語に盲目(別製品を通す) | 情報不足に甘い。答えが少し揺れる |
| 判定不能 | 147組を人間送りに | そのうち66%に決着 |
文字列照合にしかない美点がもうひとつあります。読めば動作が確定することです。^ASUS .*GR701 と書いてあれば、何に当たるか机上で言い切れます。判定モデルの基準は日本語の一文で、知らない入力に何を返すかは投げてみるまで分かりません。
速度と費用も桁が違います。照合はマイクロ秒でタダ、モデルは約250ミリ秒で1件0.003円ほど。数百万行をなめるような用途には向きません。というわけで、実務の構成はこうなりました。
- 文字列照合で機械的に判定できるものは、そのまま照合で処理する
- 「判定不能」になったものだけモデルに回す
- 「一致」と判定されたものもモデルで再点検する ← ここで誤リンク13件が出た
497組の処理にかかったのは、合計 37秒・約1.4円。人力の山はこう変わりました。
| 件数 | |
|---|---|
| 従来、人間が見るしかなかった | 147件 |
| モデルがはっきり判定し、人間不要になった | 97件 |
| 依然として人間が見るべき | 約50件 |
「人間を外す」のではなく「人間が見る山を3分の1に削り、どこを見るべきかを教えてもらう」道具です。はっきり判定した97件のうちも15%程度は外している見込みなので、抜き取り点検も要ります。
ローカルの GPU で AI を動かす実測を探している方は、DiffusionGemma 速度8.7倍の結論 — RTX 5090 実測で見えた品質の壁 もあわせてどうぞ。
測れなかったこと:確率の当たり具合は宿題
最後に、できなかったことを書いておきます。
このモデルの売りは「申告する確率が当てになること」です。「80%と言ったものは本当に8割当たる」という性質で、それを測るのが当初の目的でした。ところが測れませんでした。答え合わせに使う正解ラベル自体に、13件以上の誤りがあることが判明したからです。分母が汚れている状態で的中率を計算しても、意味がありません。
ラベルを直してから測り直します。そのときはまた書きます。
検証の条件
- 実測日: 2026年9月19日
- データ: 自サイトの商品ASIN監査台帳 657組(PCパーツ・2026年8月取得分)
- 判定モデル: TypeSafe Jev 1.13(OpenRouter 経由)
- 正解ラベルは既存のルールベース判定器が生成したもので、人手による判定ではありません。実験2の40組のみ、筆者が答えを見ずに判定しています
- 台帳の誤りのうち、単体販売が存在しないチップ7件は公開前に台帳から外しました。グレード違いの約20件は正しい商品コードへの差し替え待ちです
- 誤った商品コードが読者の画面に出ていないことは、公開中のページを実際に開いて確認しています
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事
Gemma 4 MTP drafter を今すぐ入れるべきか? RTX 4070 Ti 12GB でつまずいた3つのポイントと結論
RTX 4070 Ti 12GBでGemma 4 MTP drafterを実測。ドラフター0.14GB、ただし最速はvLLMの162.7 tok/s。導入判断を正直にまとめます。
RunPodでGPUを時給39円で借りて実測 — 安い16GBは24GBより割高だった結論
RunPodでgemma3:27bを16GBと24GBで実測。借りるのは簡単でも、安いGPUが得とは限らない理由を数字で整理します。

Claude 7構成にLPを作らせて比較——設計役(planner)が検証役(advisor)に半額で勝った
Claudeの高モデルは完成物レビューより事前設計に回した方が安く強い。7構成で同一LPを比較し、実コストと使用感から判断材料を整理しました。
gemma4:12bがollamaで直った — 0.30.5で3層バグ全解消を実測確認【回避策は不要に】
gemma4:12bのSIGFPE、macOS専用配布、日本語崩れを同一環境で実測。ollama 0.30.5で何が直り、何を捨ててよいかを整理します。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:開発環境・キャリアまわりのサービス
 シンVPSを見る
 XServer VPSを見る
 strategy career の転職支援を見る