Perplexity DeciderはJevから替える?11対0の判定差
Perplexity Decider V1.2を楽天の同一商品判定でJev・OpenAI・Clefと同じ89行で実測。正解率は合格線に1行届かず、版数語の取り違えは6モデル中最少でした。

当サイトの価格台帳では、楽天の検索結果が本当に同じ商品なのかを AI に判定させています。この作業に、Perplexity が2026年10月に出した判定専用モデル「Decider」(V1.2)を加えて、前作までと同じ条件で TypeSafe の JevJevTypeSafe が出している、文章を書かずに判定の答えだけを返す AI モデル。詳しく →、OpenAI の判定用API「Decisions」、Cloudflare の Workers AI で呼べる ClefClefCloudflare が出している、文章を書かずに判定の答えだけを返す AI モデル。画像も読める。詳しく → と並べました。判定専用AIというのは、返事も理由文も書かず、判定の結果だけを返すAIのことです。
Decider は、細かい型番判定では OpenAI に次ぐ2番手でした。正解率は79.8%で、最上位の OpenAI は85%。事前に決めた合格線80%には1行足りません。それでも、型番違いを本体と取り違えた行は6モデルで最少で、Jev が間違えて Decider が正した行は11、その逆は0でした。粗いふるいとはい/いいえ判定では1番です。費用は1呼びあたり Jev の約1/4、OpenAI の約1/6。小さい Flash は Jev と同程度で、替える理由は見つかりませんでした。
型番違いの取り違えを減らしたいなら、Decider は Jev の候補になります。細かい型番の正解を最優先するなら、いまも OpenAI のほうが安心です。迷うとしたら、「Jev から替えるか、いまのまま併用するか」の一点だと思います。
前作と同じ89行・同じ問いで、結果を見る前に合格線を決めた
前作では、細かい型番は OpenAI、粗いふるいは Jev と、用途ごとに分けて頼むしかありませんでした。その経緯は OpenAI DecisionsはJevから乗り換え?単価2.4倍の答え に書いています。Decider は単価が安いのに、公式の資料には日本語の精度の数字が見当たりません。それなら自分のデータで測るしかない、というのが今回の出発点です。
替えるかどうかを決めるとき、頼りになるのは発表文の言葉ではなく、同じ条件で並べた数字だと思っています。そこで、前作と同じ楽天の検索結果89行(人手で正解を付けたもの)を、同じ問い、同じ集計の定義で流しました。
楽天の検索結果は、型番の末尾に M・RGB・SE・V2 などが付くだけで別商品になることがあります。ここを見落とすと、台帳の値段が別商品にずれてしまう。だから正解率とは別に、「版数語を見落としたか」を数えています。
合格線は、結果を見る前に決めました。正解率80%以上、版数語の見落としは13行以下です。私の予想は、正解率68〜78%、見落とし15〜22行でした。
- 対象は楽天の検索ヒット89行。6択は、同一商品・別型番・付属品・セット・判断できない・無関係の6つ
- はい/いいえの1問版も同じ行で測定
- 並列4・1回実行。HTTP 429 が6件出たため、その6件は1件ずつ送り直して全件成功
Decider の中身:問いは3種類、出力は無料
判定に特化している点は、Jev・OpenAI・Clef と同じです。返事の文章もコードも理由も返さず、判定の結果だけを返します。Decider・OpenAI・Clef はテキストに加えて画像も受け付けます。Jev は画像を受け付けないので、画像の判定は Jev を除いて測りました。
違うのは、提供元と呼び出し口、それに値段です。Decider は Perplexity の判定用 API(Decisions APIDecisions APIOpenAI が 2026年10月に出した、判定の答えだけを返す API。詳しく →)で動くモデルで、公式の説明では、問いは3種類あります。はい/いいえの確率を返す noul、選択肢ごとの確率を返す choice、段階評価を返す score です。画像は1問8枚まで、data URL でのみ送れます。出力は無料で、1リクエストの手数料もかかりません。上限は組織あたり毎秒10リクエストまで。他社の問いの形との細かな対応は、今回は確認していません。
呼んだのは OpenRouterOpenRouter多くの会社の AI モデルを、1つの窓口と1つの請求でまとめて使えるサービス。詳しく →(複数社のAIを1つの窓口から呼べるサービス)経由です。2026年10月17日、OpenRouter のモデル一覧画面に「0d ago」(公開当日)の表示で並んでいるのを見つけて、そのまま調べ始めました。ところが一般のモデル一覧 API には載っておらず、呼べたのは判定用の窓口(/api/alpha/decisions)だけでした。
| 腕 | 経路 | 応答したモデル版 | 実行日 |
|---|---|---|---|
| Decider V1.2 | OpenRouter の判定用窓口 | perplexity/pplx-decider-v1.2-20261016 | 10-17 |
| Decider Flash V1.2 | 同上 | perplexity/pplx-decider-flash-v1.2-20261016 | 10-17 |
| OpenAI(gpt-6-luna) | 同上 | openai/gpt-6-luna-decisions-20261006 | 10-09(P2 は 10-10) |
| Jev | 同上 | typesafe/jev-1.13-20260917 | 10-09(P2 は 10-10) |
| Clef / Clef-flashClef-flashCloudflare の判定専用モデル Clef の軽量版。詳しく → | Cloudflare Workers AI の REST | clef / clef-flash | 10-09(P2 は 10-10) |
ここは先に断っておきます。他の4モデル(Jev・OpenAI・Clef・Clef-flash)は、今回は流していません。送信を Perplexity 宛てだけに絞り、Cloudflare は無料枠が切れていたため、前作の結果を使っています。Jev・Clef・Clef-flash は 10-08 から 10-09 で89行すべて同じ答えでしたし、OpenAI も 10-09 から 10-10 で472行の答えが変わりませんでした。とはいえ、全モデルを同じ日に測ったわけではありません。
楽天の同一商品判定で、Decider は合格線に1行届かず
最初に引っかかるのは、79.8%という数字だと思います。丸めれば80%に見えますが、ここは79.8%と書きます。
| モデル | 6択の正解率 | 版数語の見落とし(35行中) | はい/いいえ(1問版) | 中央値(応答) |
|---|---|---|---|---|
| OpenAI | 85%(76/89) | 11 | 75% | 434ms |
| Decider | 79.8%(71/89) | 10(最少) | 87%(最高) | 547ms |
| Jev | 67%(60/89) | 26 | 66% | 392ms |
| Decider Flash | 63%(56/89) | 26 | 65% | 455ms |
| Clef-flash | 64% | 30 | 64% | 321ms |
| Clef | 62% | 32 | 64% | 509ms |
合格線を満たすには、89行中72行の正解が必要でした。Decider は71行なので、1行足りません。一方で、版数語の見落としは10行で、もうひとつの合格線(13行以下)は満たしています。予想よりは良い結果でした。
不合格の中身を見ると、間違え方に癖があります。誤り18行のうち6行は、別型番の行を「判断できない」と答えたものでした。TD500 Mesh と TD500 Mesh V2、MSI B760M Mortar WiFi と MORTAR WIFI II、Endgame Gear OP1 8K と OP1 8K V2、ROG Falchion と ROG Falchion Ace といった組み合わせです。OpenAI は同じ行を、別型番と言い切って正解しています。OpenAI の「判断できない」は0行でした。
言い切って間違えるよりは安全な外し方です。この「判断できない」に回す癖が、言い切らない設計によるものかどうかは私の推測で、理由は確認していません。
版数語の取り違えは、Jev に対して11対0で Decider が勝った
同じ89行で、Jev が誤り Decider が正しかったのは11行でした。逆に、Jev が正解で Decider だけが誤った行は0です。前作で OpenAI と比べたときの15対0と、同じ形になりました。
11行の例は、B760 と B760M、B860 と B860M、Hyper 212 と Hyper 212 RGB、AK620 Digital と AK620 DIGITAL SE、B550M DS3H と B550M DS3H AC R2 のような組み合わせです。どれも末尾の一語か数字の違いで、Jev は同じ商品と見て、Decider は別商品と判定しました。台帳の値段がずれるのは、まさにこういう行です。
OpenAI とも比べました。OpenAI が誤り Decider が正しかったのは2行(Corsair M75 Wireless と M75 AIR、HyperX Alloy 65 と Alloy Origins 65)。逆に、Decider が誤り OpenAI が正しかったのは7行で、そのうち4行は「判断できない」という答えでした。
当サイトの今のルール(型番の照合)が見逃していた3行(Zoria、SL-INF、Freezer A35)では、Decider が正解したのは1行、Flash は0行です。ルールの穴を埋めてくれるところまでは、まだ届いていません。
確信度の高い順に任せるなら、上位30件までは Decider が安定
それぞれの答えには確信度が付きます。確信度の高い順に件数をそろえて任せたとき、どれだけ正解するかを見ました。同点は無作為の順で1000回平均しています。
| 上位の件数 | Decider | Decider Flash | OpenAI | Jev | Clef | Clef-flash |
|---|---|---|---|---|---|---|
| 18件 | 100% | 100% | 98% | 98% | 94% | 67% |
| 30件 | 97% | 90% | 93% | 87% | 83% | 60% |
| 54件 | 91% | 81% | 94% | 78% | 74% | 63% |
上位30件までは Decider が最も高く、54件まで広げると OpenAI が上回ります。自信満々で外した行(誤答のうち確信度0.8以上)は、Decider が5行、OpenAI が2行、Jev が12行、Flash が0行でした。
粗いふるい(本体か端末か)は、Decider だけが4/4で誤検知0
粗いふるいは、本体の価格に別物が紛れていないかを拾う作業です。383行を対象に、「本体そのもの」以外と答えた行を全件目で確かめました。正解ラベルは付けていないため、見逃しの総数は分かりません。
| モデル | 疑った行 | 本物(4件中) | 誤検知 |
|---|---|---|---|
| Decider | 4 | 4 | 0 |
| Decider Flash | 6 | 4 | 2 |
| OpenAI | 1 | 1 | 0 |
| Jev | 3 | 3 | 0 |
| Clef | 6 | 4 | 2 |
| Clef-flash | 6 | 2 | 4 |
本物の問題は、SoCSoCCPU・GPU などを1つのチップにまとめた部品。スマホやタブレットの頭脳。詳しく →(スマホなどに載る頭脳部分の半導体)のページに、別の端末の価格が載っていた4行です。MediaTek Helio G96 のページに蔵衛門 Pocket Tough(スマホ)が、Dimensity 9000 に OPPO Pad 2、Dimensity 6300 に OPPO A5 5G、Apple A17 Pro に iPad mini(A17 Pro)が混ざっていました。Decider は4行とも拾い、誤検知は0。6モデルで4/4と誤検知0を両立したのは Decider だけです。
ここは、前作との違いがはっきり出たところです。前作では OpenAI が慎重すぎて1/4しか拾えず、問い文を直してようやく4/4になった場面です。今回は前作の問い文のままで、Decider が4/4を拾っています。問い文の書き方の差が大きく出る場面なので、そのままで拾えるのはありがたいところです。
はい/いいえは87%で1番、画像も9枚とも正解
はい/いいえの1問版では、Decider が87%で6モデル中最も高く、OpenAI は75%、Jev は66%でした。Flash は65%、Clef と Clef-flash は64%です。
画像は、前作と同じ公開サムネイル9枚と同じ正解で測りました。動物の絵、Llama の文字、マークの3種類です。Decider は3種類とも9/9、Flash はマークで8/9でした。n=9 の実演なので、精度の主張はしません。
送り方で一度つまずいています。画像を top-level の images 欄に入れると HTTP 400 で返されたので、state 配列の image_url(data URL)で送り直しました。画像つきで599トークン、画像なしで260トークンなので、画像をちゃんと読んでいることは確認できています。
Decider Flash は Jev と同程度で、替える理由は見つからなかった
Flash は6択で63%、Jev は67%です。版数語の見落としは、どちらも26行で同じでした。1問版は Flash 65%、Jev 66%。上位30件だけ見ると Flash が90%、Jev が87%で、差は数字の上ではわずかです。
粗いふるいでは、Flash も4/4を拾いました。ただし、Fractal Torrent と Corsair 7000D の本体を付属品と判定して、誤検知が2行ありました。画像はマークで1件外しています。
Perplexity の公式説明では、Flash は基準がはっきりした大量の判定(振り分け・ラベル付け・ふるい)向けとされ、選ぶ前に自分のラベル付きデータで両方を試すよう書かれています。その通りに試した結果、今回の数字では Flash は Jev から替える理由になりませんでした。
費用は Jev の約1/4、速さは6モデル中で最も遅い
単価は、27Bの Decider が入力100万トークントークンAI が文章を読み書きする時の、文字を細かく区切った単位。料金もこの数で決まる。詳しく →あたり $0.02、小さい Flash が $0.01です。前身の v1 は $0.04 で、v1.1 で $0.02 に下がりました。旧い名前を指定しても、v1.2 が選ばれます。
6択1行の入力トークンは、Decider が414、OpenAI が516、Jev が863でした。同じ文字列でも、モデルによって数え方が違うんですよね。理由は確認していません。単価とこの数を合わせると、1呼びあたりの費用は Jev の約1/4、OpenAI の約1/6になります。
実際に払った額は、2モデル合計で約 $0.015(疎通を含め約2,500呼び)でした。内訳は Decider が $0.010、Flash が $0.005 です。流す前に上限を $0.30 と決め、見積もりは $0.05 でしたが、実際はそれよりも安く済みました。
速さは、中央値で Decider が547msです。Jev は392ms、OpenAI は434ms、Clef は509msで、今回の6モデルのなかでは最も遅い数字になりました。ただし公開2日目で、別日の結果を並べた参考値です。
新しい100行でも Decider が1位、ただし差は1点
パート2では、Claude 2者が独立にラベルを付けた新しい100行(一致は98行)で測りました。ラベルは人手ではなく Claude によるものなので、ここはデータの限界として見てください。6択の正解率は、Decider が90%で最も高く、OpenAI が89%、Jev と Clef が86%、Clef-flash と Flash が85%でした。
問い文に差分語の一覧を足す改良も試しています。Decider は悪化せず、旧89行では4行増えて約84%に、新100行では1行増えました。一方の Flash は、旧89行で版数語の見落としが26から32に増えて悪化しています。同じ工夫でも、効くかどうかはモデル次第でした。
私なら、ふるいは Decider、細かい型番は OpenAI に分けて試す
ここから先は、数字をもとにした私の判断です。事実とは分けて読んでください。
版数語の取り違えを減らしたいなら、Decider を Jev の候補に入れる理由は十分あると思います。11対0は、今回の89行の中でははっきりした差です。ただ、Jev が他の用途で持つ強みは、今回の対象外です。
一方、細かい型番判定の正解をいちばん優先するなら、OpenAI のほうが安心だと私は考えます。正解率は85%で、判断できないに逃げた行は0です。
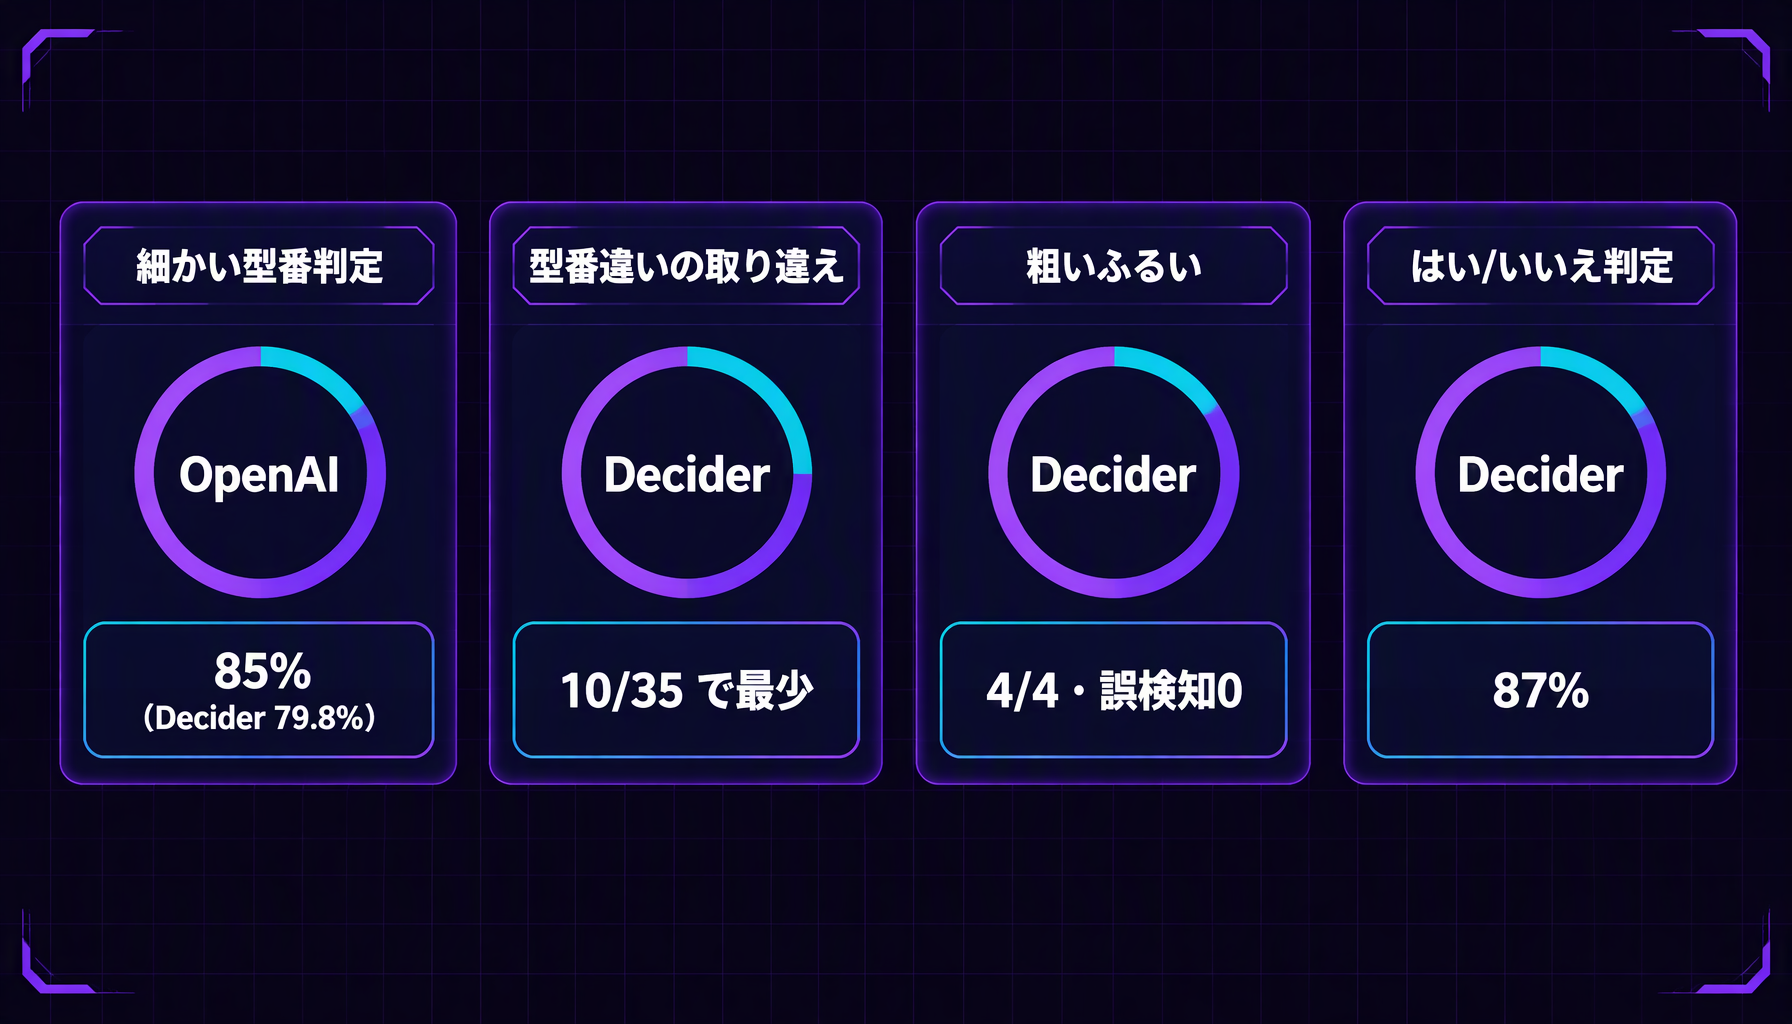
私なら、粗いふるいとはい/いいえは Decider、細かい型番の確認は OpenAI と役割を分けて、最初の数百件で試します。
数字を読むときの前提も書いておきます。標本は楽天の89行(新しい100行を含む)、1回実行、公開翌日の版で、主要な基準の差は1行しかありません。他の4モデルの結果は別日のもので、過去に日をまたいでも答えが変わらなかったことを根拠にしていますが、全モデルを同じ日に測ったわけではありません。画像は n=9 で、粗いふるいの見逃し総数は不明です。Perplexity の公式資料には、精度の数値も日本語の数値も見当たりませんでした。ここに載せた数字は、当サイトのデータと問いでの結果です。
替えるかどうか迷っているなら、自分の型番データで100行ほど流してみると、今回の数字と並べやすいと思います。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事
Clefへの乗り換えは待ち——Jevを選ぶ日本語判定、画像だけは別
楽天商品89行とサムネ9枚を同日比較。日本語ECの版数判定はJev、画像判定はClefが候補になる理由を実測で整理します。

Jev・OpenAI Decisions・Clef、型番判定で最強はどれ?
Jev・OpenAI Decisions・Clefを楽天の型番判定189行で実測。正解数はOpenAI Decisions 165・Jev 146・Clef 141。規則の取り違えは指示文1文で直ったが、型番の見落としは直らなかった。

d1-ultraはOpenAI Decisionsから替える?日本語型番で正解率91%
Liquid AIのd1-ultraを前作と同じ楽天89行で実測。日本語の型番違いの見落としは8モデル中最少で、無印d1はJev並み。費用・速さ・限界も。
商品台帳657組を判定モデル TypeSafe Jev で再判定——文字列照合の盲点13件と判定不能147組
自サイトの商品台帳657組を判定モデル(TypeSafe Jev)で再判定した一次検証。文字列照合が構造的に見逃す「登録名が部分集合になる」誤りを13件見つけ、判定不能147件の66%に決着をつけた記録。指示文を厳しくしても総得点が4/6のまま動かなかった実測まで。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:開発環境・キャリアまわりのサービス
 シンVPSを見る
 XServer VPSを見る
 strategy career の転職支援を見る