Jev・OpenAI Decisions・Clef、型番判定で最強はどれ?
Jev・OpenAI Decisions・Clefを楽天の型番判定189行で実測。正解数はOpenAI Decisions 165・Jev 146・Clef 141。規則の取り違えは指示文1文で直ったが、型番の見落としは直らなかった。

このサイトでは、楽天の出品が「その製品そのものか、付属品か、別の型番か」を AI に見分けさせて、製品ページの価格を集めています。使っているのは判定モデル(決まった選択肢から1つを選ぶことに特化した AI)です。前作で OpenAI の Decisions APIDecisions APIOpenAI が 2026年10月に出した、判定の答えだけを返す API。詳しく →、TypeSafe の JevJevTypeSafe が出している、文章を書かずに判定の答えだけを返す AI モデル。詳しく →、Cloudflare の ClefClefCloudflare が出している、文章を書かずに判定の答えだけを返す AI モデル。画像も読める。詳しく → と軽量版の Clef-flashClef-flashCloudflare の判定専用モデル Clef の軽量版。詳しく → の4つを同じ指示文で比べたので、今回は「指示文を直したら、負けたモデルも追いつくのか」を確かめました。
細かい型番の見分けで一番強かったのは、今回も OpenAI です。189行(今回の新しい100行と前作の89行)の正解は、従来の指示文で OpenAI 165、Jev 146、Clef-flash 142、Clef 141 でした(前作の89行の Jev・Clef 系は10月9日の答えで、日をまたいでも答えは変わっていません)。最上位の OpenAI と Jev の差は約20行あり、指示文の工夫で動いたのは数行だけでした。費用は、本体の計測で OpenRouter の実費が OpenAI 0.0568ドル、Jev 0.0251ドルでした。Clef 2つは Cloudflare の無料枠内です。
指示文で直ったのは、規則の取り違えによる誤りだけでした。本体か付属品かの粗いふるいでは、1文直すと3つとも同じところまで届いています。一方、V2 や G5 のような版数語(世代や版を表す英数字)の見落としは、例を並べても、一覧を渡しても、選択肢の名前を替えても減りませんでした。その「一覧を渡す」案は、私が最初に推したものです。「ヒントを足せば良くなるはず」という直感は、今回はっきり裏切られました。
前作で残った宿題と、結果を見る前に決めた線
前作の末尾には、問いが二つ残っていました。指示文を直せば Jev や Clef も版数語を拾えるのか。OpenAI の慎重さは直るのか。前作の細かい型番判定(6択・人手89行)では、OpenAI 85%、Jev 67%、Clef 62%、Clef-flash 64% でした。版数語の見落としは35行中、OpenAI 11、Jev 26、Clef 32、Clef-flash 30 です。前作の4モデル比較はこちらにあります。
今回は事前登録(改良案と「効いた」と言える線を、結果を見る前に文書にしておくこと)をしてから測りました。後から基準を都合よく動かさないためです。旧い指示文は1字も変えず、改良版を別の指示として横に並べています。
測り方:正解の半分は AI が付けた
新しい100行は、当サイトの価格台帳(楽天の検索ヒット)から、前作の89行を除いた530行から層別に抽出しました。正直に書いておくと、この100行の正解は私が手で付けたものではありません。Claude の2者が、製品名と出品名だけを見て互いに独立に付け、98行で一致しました。残り2行も Claude が裁定しています。前作の89行は人手ラベルですが、その答えは前回見ているので、そこでの改善は参考扱いにします。
計測条件は次のとおりです。
- 経路: OpenAI と Jev は OpenRouterOpenRouter多くの会社の AI モデルを、1つの窓口と1つの請求でまとめて使えるサービス。詳しく → の判定 API(OpenAI は beta の版 20261006、Jev は 1.13)、Clef 2つは Cloudflare の Workers AI(REST)
- 並列4。再試行は転送失敗のときだけで、全実行で失敗は0件
- 費用: OpenRouter の実費合計は約0.12ドル。Cloudflare は無料枠内
もう一つ、前提として確かめたことがあります。同じ問いを2026年10月9日と10日に送ったところ、OpenAI は472行中0行、Jev は89行中0行しか答えが変わりませんでした。毎回の気まぐれで答えが揺れるわけではないので、指示文を変えて動いた行は、指示文の差として読めます。
粗いふるい(383行):規則の範囲を閉じたら1文で直った
最初に直ったのは、粗いふるい(383行)のほうでした。従来の指示文には「GPU は、そのチップを搭載したグラフィックカード製品を本体(product_itself)とみなす」という例外規則がありました。SoCSoCCPU・GPU などを1つのチップにまとめた部品。スマホやタブレットの頭脳。詳しく →(スマホ用のチップ)の出品にも、この規則が当てはめられてしまった、というのが私の見立てです。確認まではしていません。
その結果、チップを積んだスマホやタブレットまで「本体」扱いになっていました。SoC のページに3万〜17万円の端末価格が「チップの価格」として並ぶと、読者は誤った値段で判断してしまいます。地味ですが、サイトとしてはかなり困る誤りです。
改良は、規則の後ろに「(この規則は GPU だけ)」を足し、「SoC・CPU などのチップが product で、item がそれを積んだスマホ・タブレット・PC などの完成品なら bundle」を1文足しただけです。bundle の基準文には、スマホ・タブレット・ゲーム機も名指しで入れています。
| 判定モデル | SoC 4行で拾った数(従来→改良) | 誤検知(従来→改良) |
|---|---|---|
| OpenAI | 1 → 4 | 0 → 0 |
| Jev | 3 → 4 | 0 → 0 |
| Clef | 4 → 4 | 2 → 0 |
| Clef-flash | 2 → 4 | 4 → 8(悪化) |
OpenAI の答えで分かりやすかったのは、製品「MediaTek Dimensity 6300」に「OPPO A5 5G 4GB+128GB Simフリー スマートフォン」の出品が来た行です。従来は product_itself でしたが、改良後は bundle(その確率0.98)になりました。「Apple A17 Pro」に対する iPad mini の出品も、同じく bundle 0.98 に変わっています。
ただ、ここで喜びすぎないようにしています。この4行は、改良の文言を書く前に私が見ていた行です。4/4は狙った行での実演にすぎず、n=4です。本当の証拠は、残り379行で誤検知が増えなかったことのほうです。OpenAI と Jev は0のまま、Clef は2から0に減りました。
Clef-flash(軽量版)だけは、別の方向に引っぱられました。「完成品」の語に反応して、ノートPC本体(Let's note、Inspiron、Surface Go)まで bundle にし、PCケース4行を付属品と判定しています。誤検知は4から8に増え、いずれも確信度は0.75以下でした。1文の足し算でも、狙っていない行まで動くことがあるわけです。
型番判定:私の推した「差分語の一覧」は見落としを減らさなかった
型番判定のほうは、事情がまるで違いました。従来の指示文には版数語の例(V2・II・III・SE・Lite・Pro・Mini など)がすでに書いてあったのに、Jev で26行、Clef で32行を見落としていました。語を並べても効かないのなら、探す作業はプログラムに任せて、AI には見分けるだけをやらせればいい。これが私の推した案でした。
具体的には、出品名にあって製品名にない英数字の語を、プログラムで機械的に抜き出します。分類はしません。それを判定材料の item_only_words として足し、指示文に「この中に版数や型番の違いを表す語があるか確かめてから選んで」を1文足しました。
| 判定モデル | 正解(従来→改良) | 直った | 壊れた | 型番違い9行の見落とし(従来→改良) |
|---|---|---|---|---|
| OpenAI | 89 → 86 | 1 | 4 | 4 → 7 |
| Jev | 86 → 87 | 1 | 0 | 9 → 8 |
| Clef | 86 → 85 | 0 | 1 | 9 → 9 |
| Clef-flash | 85 → 85 | 1 | 1 | 9 → 9 |
旧89行でも見ました(参考)。版数語の見落としは、OpenAI 11→14、Jev 26→24、Clef 32→29、Clef-flash 30→31 でした。事前に決めた「効いた」の線(Jev 18以下、Clef 24以下)には届いていません。
いちばん首をかしげたのは OpenAI です。一覧に版数語がそのまま載っているのに、「同じ製品」と答えた行がありました。「DeepCool AK500」の製品に「AK500 G2」の出品、「Endgame Gear OP1 8K」の製品に「OP1 8K V2」の出品がそれです。後者は、前作では OpenAI が正しく別型番と判定していた行でした。Kingston Fury Renegade 系では「G5」の出品が、一覧に g5 があるのに match になっています。答えを机の上に置いておいたのに、かえって見なくなった。そんな印象でした。
無関係な美容品(GB10 という名のヘアケア品)が match になった行もありました。一覧にあったのは「100ml」だけでした。版数語が見当たらないことを「同じ製品」の根拠にしたように見えますが、原因の特定まではしていません。
追試:注意書きのせいではなかった
私の予想は、一覧の注意書き(「色・ショップ名・型番コードなども混ざります」)が原因、という説でした。注意書きのせいで、一覧を雑音として扱ったのではないか、という読みです。そこで OpenAI だけで189行を使い、版ごとに切り分けました。
| 版 | 正解(189行) | 直った / 壊れた(従来比) |
|---|---|---|
| 従来 | 165 | — |
| 一覧+説明+注意書き | 159 | 2 / 8 |
| 注意書きだけ消す | 158 | 2 / 9 |
| 一覧だけ置く(説明なし) | 160 | 1 / 6 |
注意書き説は外れました。注意書きを消すと、壊れる行はむしろ8から9に増えています。一方で、説明を外して一覧だけ置いても6行壊れました。事前登録の基準ではどちらの説も満たさず、決着はしていません。ただ少なくとも、「書き方が悪い」だけではなく、判定の材料に「答えの手がかりらしき欄」が入ること自体が悪化を招いている、と読めます。
ここから持ち帰れる実務の形は単純です。判定の材料には見たままの情報(製品名・出品名・価格)だけを入れる。差分・候補・ヒントのような下ごしらえの産物は、混ぜないほうが安全です。
選択肢の名前を A〜F に替えても、良くはならなかった
もう一つ、論文で提案されている検査を実際のモデルで試しました。出典は arXiv:2610.02586「Labels Override Definitions in Jev-Style Typed Decision Models」(南カリフォルニア大、2026年10月1日、CC BY 4.0)です。主張は、選択肢の名前(label)に意味があると、モデルが説明文(definition)をほとんど読まずに名前で決めてしまう、というものです。検査は、説明文はそのままで名前だけを替えて2回送るだけなので、正解表が要りません。
ただし、論文が測ったのは Jev に似た公開モデル4種で、Jev 本体・Clef・OpenAI は測られていません。論文自身も、名前そのものが意味を運ぶ分類では A/B のような記号名がかえって逆効果になりうると断っています。今回の分類は match や accessory のように名前に意味を持たせたものなので、ちょうどその但し書きに当てはまる位置です。
189行で、選択肢名を A〜F に替えました。割り当ては旧名の文字列順で、並び順は変えていません。指示文の中で「ambiguous を選ぶ」と書いた1か所だけ「B を選ぶ」に変えています。
| 判定モデル | 答えが変わった行 | 正解(従来→A〜F) | 直った / 壊れた | 型番違いを match(44行中・従来→A〜F) |
|---|---|---|---|---|
| OpenAI | 4 | 165 → 162 | 0 / 3 | 15 → 17 |
| Jev | 8 | 146 → 140 | 0 / 6 | 35 → 34 |
Jev の8行は、すべて「判断できない(B)」へ移りました。日をまたいでも答えが動かないことは確かめてあるので、この動きは名前替えによるものです。ただし、指示文で1か所だけ書き換えた「B を選ぶ」の B が、1文字の名前だと目立ちすぎた可能性もあり、そこは切り分けていません。一方で、A〜F にして良くなった行は両モデルとも0でした。「match という名前に引っぱられて型番違いを見落とす」という説も、支持されませんでした。
論文の効果は、Jev 本体にも小さく移っているように見えます。それでも、この分類では意味のある名前のままのほうが正しい、というのが今回の結果です。検査の費用は2腕で0.02ドル程度でした。Clef と Clef-flash はまだ流していません。Cloudflare の1日の無料枠を使い切っていたためです。
直る誤りは1か所に集まり、直らない誤りは散らばっていた
三つの結果を並べると、指示文の改良で直るものと直らないものは、はっきり分かれました。直ったのは規則の取り違えです。誤りが SoC という1種類の製品に集中していて、指示文の中に原因の文(GPU の例外規則)が見つかるケースでした。直らなかったのは、違いに気づけないケースです。版数語の見落としは、OpenAI の15行が7種類(マザーボード・CPUクーラー・キーボード・マウス・SSD など)、Jev の35行も7種類にまたがっていました。しかも版数語の例は最初から指示文に書いてあり、誤りを生んだ文は見当たりません。
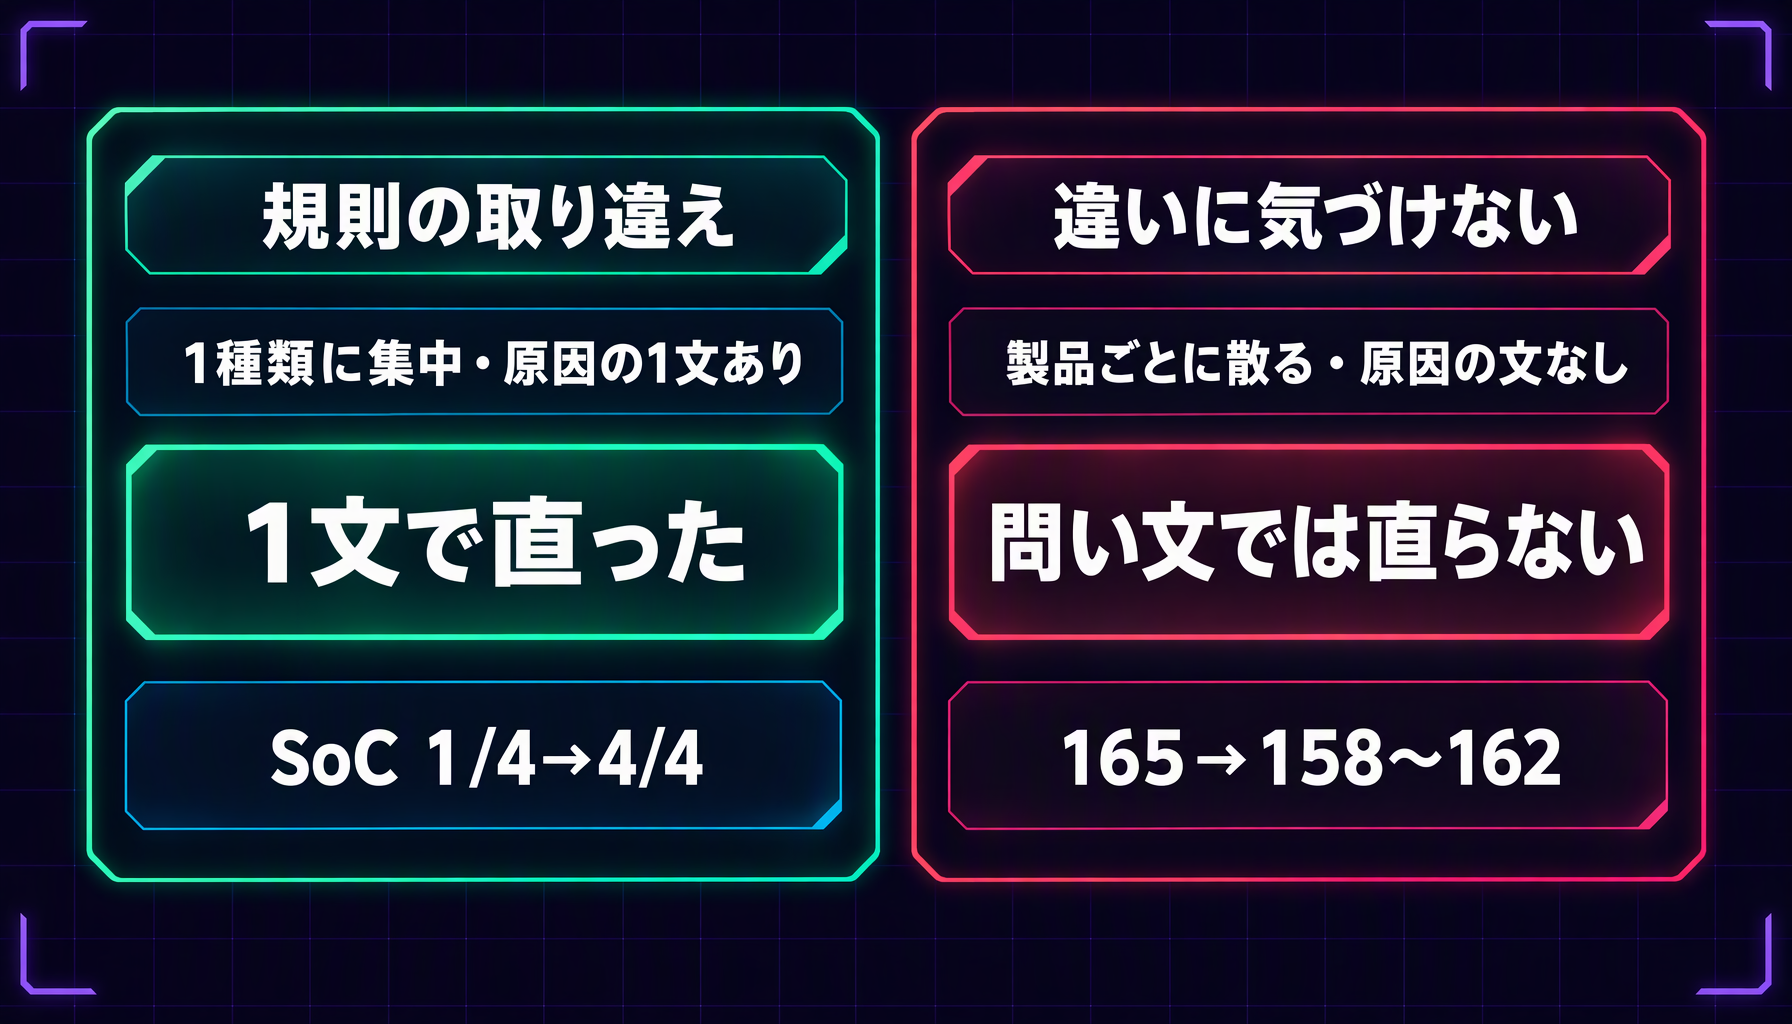 誤りが1か所に集まり原因の文があれば問い文で直る。散っていれば問い文の外側で補う
189行で見ると、OpenAI と Jev の差は約20行(165対146)でした。指示文の工夫で動いたのは数行で、悪化した行のほうが多かったです。この差は、指示文では埋まりにくい部分でした。
精度が出ないとき、迷うのはたぶん「指示文をもう少し練るか、モデルを替えるか」の一点だと思います。私なら次の順番で見ます。ただ、この見分け方は今回の2つの例から読み取ったもので、別のデータで確かめたわけではありません。
- 誤った行を、製品の種類ごとに数えます。1種類に集中しているか、いろいろな種類に散っているかを見ます。
- 集中していて、指示文にその原因になりそうな文(例外規則など)が見つかるなら、規則の範囲を「この規則は○○だけ」と閉じます。1文で直る可能性があります。
- 散っていて、原因の文も見当たらないなら、指示文には期待しすぎないほうがいいです。モデルを替えて比べるか、既知の版数語をコードで突き合わせる関所を後ろに置く方法があります。関所は私はまだ試していません。
私見:指示文の問題か、モデルの地力か
ここからは私見です。一通り実験を終えたとき、正直に言うと「指示文の書き方より、モデルの性能の問題では」と感じました。今回の数字は、その感覚をおおむね支持していると思っています。ただ、これは私の解釈です。数通りの指示文と、日本語 EC の商品名だけで測った結果からの判断だ、という前提は外せません。
だから私は、指示文を直すのは「規則の取り違え」が疑われる誤りに限ります。版数語のような見落としが多いなら、指示文の書き直しに時間を使うより、判定モデルを替えて比べるほうが早い、というのが今の考えです。
まだ測れていないこと
Clef と Clef-flash の名前替え検査は未実施です。論文は Jev 本体・Clef・OpenAI を測っていません。今回の OpenAI と Jev は OpenRouter 経由で、OpenAI は beta(版 20261006)です。OpenAI の本家の API 直では測っていません。正解の半分は Claude のラベルで、人手のラベルではありません。試した指示文も数通りで、他の言語や商品カテゴリでの挙動も確認していません。「どんな指示文でも Jev は届かない」とまでは言えません。
替えるか、指示文を直すかで迷ったら、まず誤った行を製品の種類ごとに数えてみてください。1か所に集まっていて原因の文が見つかるなら、直し方は1文で済むかもしれません。散っているなら、指示文の外側に手を入れる段階だと思います。判定モデルそのものの比較は、Jev と Clef の比較もあわせて読んでみてください。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事

GPT-5.6 Luna xhigh: 知能49・タスク単価$0.04・待ち時間40秒、安い理由まで実測
2026年7月30日の80%値下げ後、通常セッションのモデルをLunaに切り替えるべきか。OpenAI公式発表と第三者ベンチの実測データ(Intelligence Index、TTFT、タスク単価)から、API従量とCodex定額それぞれの判断材料を整理します。
GPT-6.1 Solをeffort別実測:medium 47.8、Astraとの差はどこまで縮むか
GPT-6.1 SolをDevDay 2026の発表とArtificial Analysisのeffort別実測で検証。旧Sol・Astraとの性能、費用、待ち時間から使い分けを判断します。
Codex CLI 0.112.0→0.114.0 で権限設計が変わった。request_permissions が実務で効く理由
Codex CLI 0.112.0から0.114.0で、権限要求の設計が段階的に進化。request_permissions、plugin拡張、承認フロー修正が実務でどう効くかを整理します。

月3万円のCodex Pro 20xはAPI約80万円分?5時間枠を実開発ベースで換算した
Codex Pro 5x・20xの5時間枠をOpenAI公式の25 credits=$1レートでAPI料金へ換算し、Azure上で30日に流れた約4.97億トークンの実測と重ねて「APIで数千ドル」が起きる条件を示します。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:開発環境・キャリアまわりのサービス
 シンVPSを見る
 XServer VPSを見る
 strategy career の転職支援を見る