OpenAI DecisionsはJevから乗り換え?単価2.4倍の答え
OpenAIのDecisions API(gpt-6-luna)をJev・Clefと同じ日に楽天89行で実測。型番違いの見落とし、確信度で任せられる件数、実費の差を整理しました。

当サイトでは、楽天で見つけた商品が、照合元の製品と同じ型番かどうかを AI に判定させています。いちばん手を焼いているのは、型番の後ろに付く V2・II・M・RGB のような小さな違いです(以下「版数語」と書きます)。これまで使ってきた TypeSafe の JevJevTypeSafe が出している、文章を書かずに判定の答えだけを返す AI モデル。詳しく →(選択肢から答えを選ぶだけの判定専用AI)も、同じ使い方ができる Cloudflare の ClefClefCloudflare が出している、文章を書かずに判定の答えだけを返す AI モデル。画像も読める。詳しく → も、ここを見落とす行がありました。
そこへ2026年10月6日、OpenAI が判定専用の Decisions APIDecisions APIOpenAI が 2026年10月に出した、判定の答えだけを返す API。詳しく →(判定の答えだけを返すAPI)をベータ公開しました。単価は Jev の約2.4倍です。同じ89行で4モデルを測ったところ、細かい型番の判定では OpenAI の gpt-6-luna が正解率85%で、事前に決めた合格線を超えたのはこのモデルだけでした。Jev は67%です。しかも実際に払った額の差は約1.4倍まで縮みました。
ただ、本体か付属品かを大まかに分ける判定では話が逆になります。OpenAI が拾ったのは1行だけで、Jev は誤検知0のまま3行を拾いました。版数語の見落としが困るなら OpenAI に替える価値があり、大まかな振り分けなら Jev のままで足ります。迷うのは、全部を替えるか一部だけ替えるか、というところだと思います。
前回と一字一句同じ問いで、OpenAIを足して同じ日に測った
前回のClef 比較と同じデータ、同じ問い文に、OpenAI を足して同じ日に測りました。比べたいのはモデルの違いだけなので、問い文には手を入れていません。そもそもの経緯は、Jevの解説編と実測編に書いています。
合格線は、結果を見る前に決めました。正解率80%以上と、版数語の見落とし13行以下の両方です。結果を見てから線を引き直すと、どの数字でも良く見えてしまうからです。
OpenAI は、本家ではなく OpenRouterOpenRouter多くの会社の AI モデルを、1つの窓口と1つの請求でまとめて使えるサービス。詳しく →(複数社のモデルを一つの窓口で呼べるサービス)経由で呼びました。Jev と同じ窓口に、同じ形の本文で送れるからです。本家とは送る形が違うので、本家で同じ数字になるかは確かめていません。
実はここで一度、手が止まりました。素の gpt-6-luna を指定すると「Model does not exist」と返ってきて、OpenRouter には OpenAI のモデルが無いのだと早合点したんです。正解は、判定用の別名 openai/gpt-6-luna-decisions を指定することでした。同じところで詰まる方がいそうなので、先に書いておきます。
3社の判定モデルは、答えの形が同じで、対応範囲が違う
Decisions API も Jev も Clef も、文章を書きません。返すのは、はい・いいえの確率、選択肢から1つ、段階評価といった、型の決まった答えだけです。
違うのは対応している範囲です。Decisions API が動くのは gpt-6-luna だけで、画像も読めます。OpenAI は「Responses API より約10倍速い」と述べていますが、日本語の精度を示す数字は出していません。Clef は Cloudflare の Workers AI で動き、Clef-flashClef-flashCloudflare の判定専用モデル Clef の軽量版。詳しく → はその軽量版です。Jev は画像を読めないので、画像の実験で比べたのは OpenAI、Clef、Clef-flash の3モデルになります。
| モデル | 入力100万トークントークンAI が文章を読み書きする時の、文字を細かく区切った単位。料金もこの数で決まる。詳しく →あたりの単価 | 今回の経路 | 画像 |
|---|---|---|---|
| OpenAI(gpt-6-luna) | $0.10 | OpenRouter | 対応 |
| Jev | $0.042 | OpenRouter | 非対応 |
| Clef | $0.24 | Workers AI | 対応 |
| Clef-flash | $0.09 | Workers AI | 対応 |
3社を直接比べた精度の数字は、調べた範囲では見当たりませんでした。海外メディアの The Decoder は、今回の公開を「Jev が流行らせた判定モデルへの OpenAI の応答」と書いていましたが、精度は比べていません。調べた範囲で比べた例が無いなら、日本語のEC商品で確かめる意味がある、と考えました。
楽天89行で、両方の合格線を超えたのはOpenAIだけだった
材料は、当サイトの価格台帳から楽天の検索にヒットした619組のうち、人手で正解を付けた89行です。内訳は、同じ商品41行、型番違い35行、付属品6行、セット4行、判断が分かれるもの2行、無関係1行。この6つのラベルから1つを選ばせる6択と、問いを1つに絞った1問版の2通りで判定させました。
| モデル | 6択の正解率 | 版数語の見落とし(型番違い35行中) | 1問版の正解率 | 中央値(ミリ秒) |
|---|---|---|---|---|
| OpenAI(gpt-6-luna) | 85%(76/89) | 11行 | 75% | 434 |
| Jev | 67%(60/89) | 26行 | 66% | 392 |
| Clef | 62%(55/89) | 32行 | 64% | 509 |
| Clef-flash | 64%(57/89) | 30行 | 64% | 321 |
OpenAI は85%(76行)、見落とし11行で、合格線を両方とも満たしました。4モデルで両方を満たしたのは OpenAI だけで、私の事前の予想(正解率70〜80%、見落とし15〜22行)も上回っています。中央値(1件の判定にかかった時間の真ん中の値)は4モデルとも0.3〜0.5秒台で、速さで選ぶほどの差はありません。
とはいえ、89行は多い件数ではないので、この正解率の差だけで言い切るのは控えます。決め手にしたのは、次の行ごとの比較です。
Jevが外した15行をOpenAIが拾い、その逆は0行
版数語の見落としは、Jev の26行から OpenAI の11行へ減りました。同じ行どうしで並べると、差がもっとはっきりします。Jev が見落とし、OpenAI が正しく「別型番」と答えた行が15行。逆に、Jev が正しくて OpenAI だけが誤った行は0行でした。この89行の細かい判定では、替えて悪くなった行が1つも無かったことになります。
拾えた行の代表は次のとおりです。
| 製品名 | 出品名で違う部分 |
|---|---|
| ASRock B760 Pro RS WiFi | 「B760M」のM |
| Cooler Master Hyper 212 Black Edition | 「RGB」 |
| Cooler Master MasterBox TD500 Mesh | 「V2」 |
| MSI B760M Mortar WiFi | 末尾の「II」 |
| Endgame Gear OP1 8K | 末尾の「V2」 |
MasterBox TD500 Mesh の V2 は、前回の Clef 比較で3モデルとも見落とした行です。今回は OpenAI がこれを拾いました。ASRock の B760M は M が1文字付くかどうかだけの違いで、OpenAI は確信度0.71で別型番と判断しています。
それでも OpenAI は11行を見落としました。ただ、そのうち10行は確信度が0.75未満で、モデル自身が「自信が無い」と申告していた行です。高い確信度で外したのは Seagate FireCuda 530 1TB の1行だけで、人手では型番違いとした出品を、確信度0.94で同じ商品として扱っていました。ほかに Corsair M75 Wireless(出品は M75 AIR、確信度0.30)と、ROG Gladius III Wireless(確信度0.48)も外しています。
当サイトの現行ゲート(今使っている振り分けルール)が誤っていた3行(Zoria、SL-INF、Freezer A35)は、4モデルとも3行中1行しか正しく答えられませんでした。モデルを替えても、版数語のチェックはルール側でも持ち続けるのが安全だと見ています。
確信度の高い順に任せると、OpenAIは54件まで94%を保った
確信度は、モデルが自分の答えにどれだけ自信があるかを0から1で返す値です。「自信がある時だけ自動にする」運用で知りたいのは、上から何件まで任せても誤りが少ないか、です。
同じ閾値(0.8)で切ると、自動に回る件数がモデルごとにばらつき、比べ方が不公平になります。そこで確信度の高い順に上位k件を取り、その正解率を並べました。
| 上位の件数 | OpenAI | Jev | Clef | Clef-flash |
|---|---|---|---|---|
| 18件 | 98% | 98% | 94% | 67% |
| 30件 | 93% | 87% | 83% | 60% |
| 54件 | 94% | 78% | 74% | 63% |
上位18件までは OpenAI と Jev が並びますが、30件で OpenAI 93%、Jev 87%、Clef 83%と開き、54件まで広げると OpenAI は94%のまま、Jev は78%、Clef は74%まで下がりました。自動に回す件数を増やしたいなら、OpenAI がいちばん崩れにくい、という結果です。なお54件は89行のうちの54件で、全行を自動にした場合の数字ではありません。
細かいことですが、Jev の上位18件は前回の記事では100%で、今回は98%でした。89行の答えは前日とすべて同じなのに、確信度の値がわずかに動いて、上位に入る行が入れ替わったためです。
粗いふるいでは、OpenAIは慎重すぎてJevのほうが拾う
粗いふるいは、本体か、付属品かセットか、無関係かを大まかに分ける判定です。こちらは正解を付けていないので、「本体以外」と判定された行を人の目で全件確かめました。判定にかけたのは383行です。
| モデル | 疑った行 | そのうち本当に問題だった行 | 誤検知(問題ではなかった行) |
|---|---|---|---|
| OpenAI | 1 | 1 | 0 |
| Jev | 3 | 3 | 0 |
| Clef | 6 | 4 | 2 |
| Clef-flash | 6 | 2 | 4 |
見たかったのは、SoCSoCCPU・GPU などを1つのチップにまとめた部品。スマホやタブレットの頭脳。詳しく →のページに端末の価格が載ってしまっていた4行です。OpenAI は誤検知こそ0でしたが、4行のうち拾ったのは1行(OPPO Pad 2、確信度0.52)だけでした。細かい判定でいちばん正確だったモデルが、粗いふるいではいちばん拾わない、という逆転が起きています。
Jev は誤検知0のまま3行を拾っていて、粗いふるいに限ればいちばんバランスが良い結果でした。Clef は4行を拾った代わりに誤検知が2行、Clef-flash は誤検知が4行で、PCケースや NT-H1 グリスのような本体の商品まで疑っていました。疑わなかった行は目視していないので、見逃しの総数は分かりません。
理由について一つだけ私見を書くと、OpenAI が慎重だったのは、版数の違いに強く反応する作りだからかもしれません。ただ、これは確かめていない推測です。
画像は3モデルとも判定できたが、優劣を言える枚数ではない
画像は、前回と同じ公開サムネイル9枚で測りました。OllamaOllama(ローカルLLMランタイム)手元の PC でオープンウェイトの LLM を手軽に動かすための、無料のソフト。詳しく → のリャマの線画6枚と、NVIDIA、AMD、プラグインの画像です。
| モデル | 動物の絵の有無 | Llamaの文字の有無 | マーク(許容する答えを含む判定) | マーク(正解を1つに絞った判定) | 中央値(ミリ秒) |
|---|---|---|---|---|---|
| OpenAI(gpt-6-luna) | 9/9 | 9/9 | 9/9 | 7/9 | 586 |
| Clef | 9/9 | 9/9 | 9/9 | 6/9 | 893 |
| Clef-flash | 9/9 | 9/9 | 9/9 | 7/9 | 519 |
許容する答えを含めれば3モデルとも9/9で、正解を1つに絞ると OpenAI と Clef-flash が7/9、Clef が6/9でした。9枚では精度の上下は言えないので、ここで言えるのは「OpenAI も画像の判定ができた」というところまでです。
ここまでを用途で分けると、粗いふるいは Jev、版数語の細かい判定は OpenAI、画像は OpenAI か Clef、という形になります。
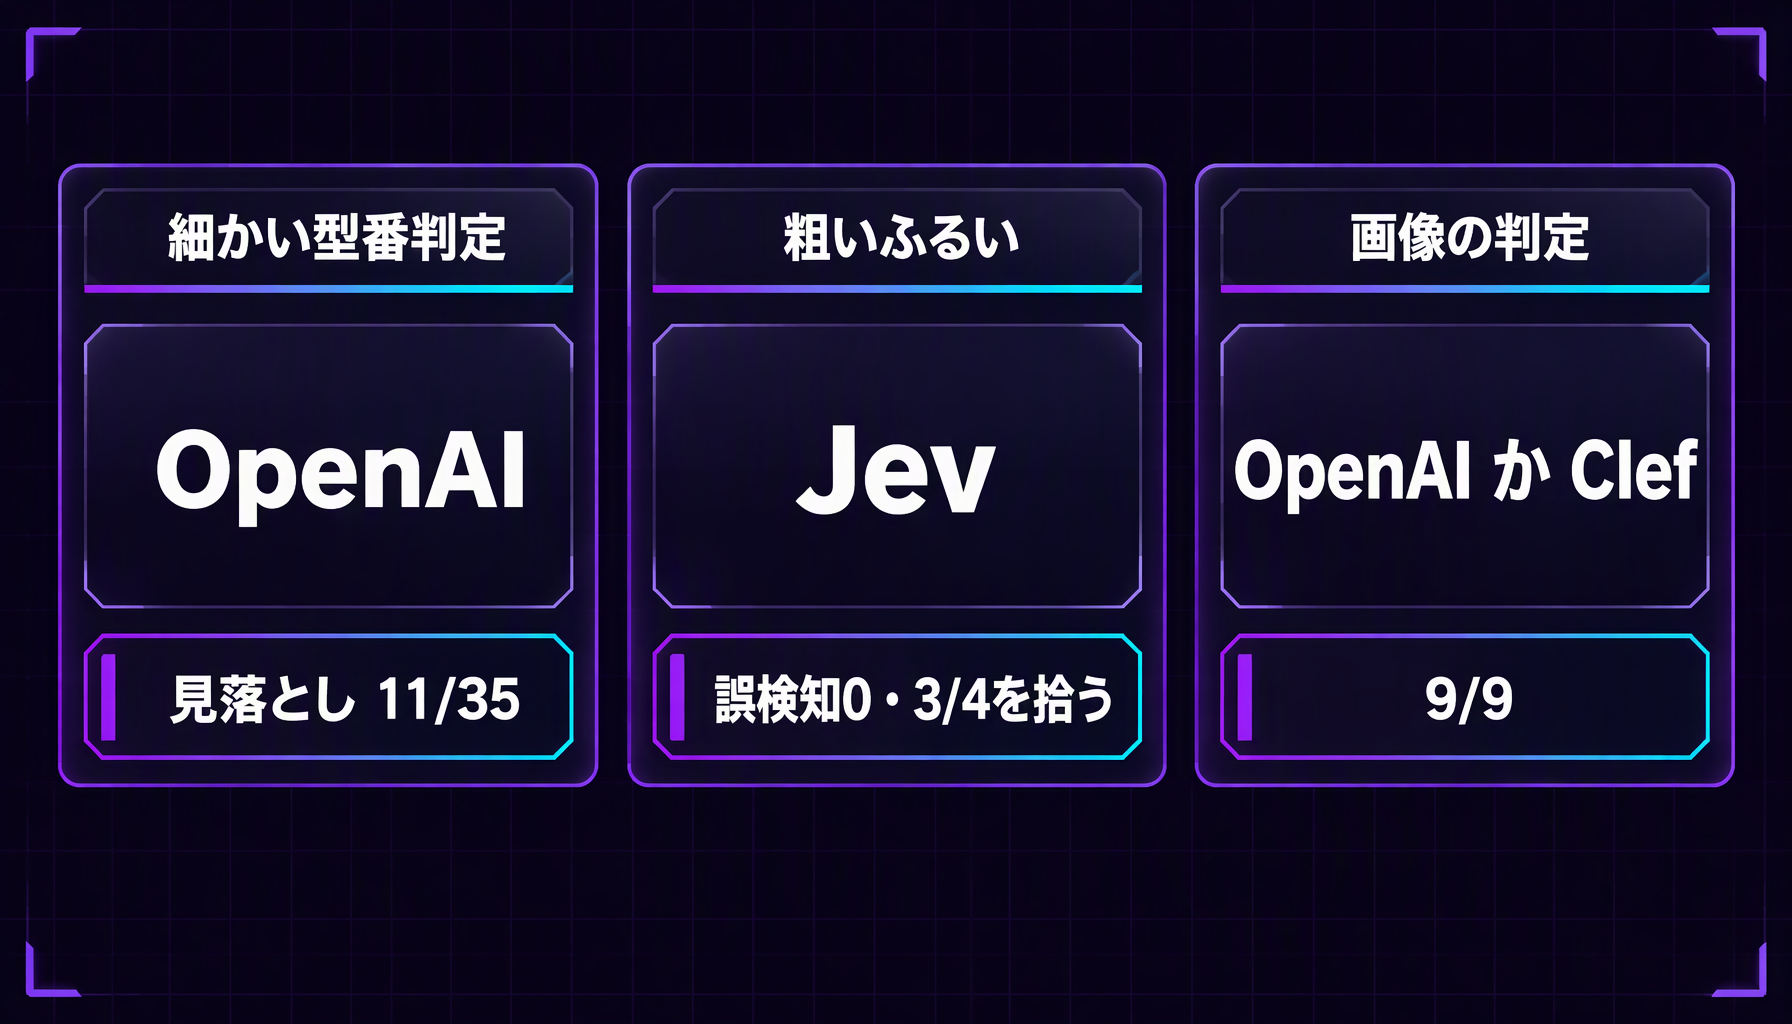 細かい判定と粗いふるいで、得意なモデルが入れ替わる
単価は約2.4倍なのに、払った額の差は約1.4倍だった
公式の単価は、入力100万トークンあたり OpenAI が $0.10、Jev が $0.042 で、約2.4倍です。最初に目に入るのはこの数字ですが、実際に払う額は、判定1件で数えられる入力トークンの量で変わります。今回は OpenRouter が返してきた実費を合計しました。
| 項目 | OpenAI | Jev |
|---|---|---|
| 入力100万トークンあたりの単価 | $0.10 | $0.042 |
| 6択1行あたりの入力トークン | 516 | 863 |
| 実費(A+Bの合計・各561呼び) | $0.0240 | $0.0174 |
同じ文章を送っても、6択1行あたりの入力トークンは OpenAI が516、Jev が863で、OpenAI のほうが少なく数えられました。そのぶん実費の差は約1.4倍まで縮んでいます(2.4 × 516 ÷ 863 ≈ 1.4)。なぜ少なく数えられるのかは、確かめていません。
A+Bの平均から単純に換算すると、1000回の判定で OpenAI は約0.04ドル、Jev は約0.03ドルです。画像や問いの種類で平均は変わるので、目安として見てください。Clef系はそれぞれ236,827トークンずつで、Cloudflare の無料枠に収まる見込みですが、収まったかどうかは確認していません。全実験を合わせても0.1ドル未満でした。
OpenAIとJevを替えるか、併用するかの目安
数字を判断の順に並べると、こうなります。
- 版数語の見落とし(型番違いを同じ商品として扱うこと)が困るなら、OpenAI を候補に入れる。実費は約1.4倍です。
- 大まかな振り分けが中心なら、Jev を残す。粗いふるいの誤検知は0でした。
- 確信度の高い順に自動化を広げるなら、OpenAI は件数を増やしても精度が落ちにくく、上位54件で94%でした。
ここからは私見ですが、私なら、版数語を見落とすと困る判定は OpenAI に任せ、大まかな振り分けは Jev に残す形を考えます。全部を替えるより、一部だけ替える案のほうが現実的だと感じました。
どのモデルも完璧ではありません。OpenAI でも版数語を11行見落としていますし、画像の9枚は差を言える枚数ではありません。替えるか迷っているなら、まず自分の商品データから版数語が絡む行だけを抜き出し、同じ問い文で測ってみてください。そのほうが、今回の89行より判断の材料になりやすいと思います。
再現情報と、この結果の限界
データ本体は公開していませんが、代表例と集計の定義、再現に必要な情報を残しておきます。モデル名は、応答として返ってきた版です。
| 腕 | 経路 | 応答されたモデル名 |
|---|---|---|
| OpenAI(gpt-6-luna) | OpenRouter の判定用窓口(/api/alpha/decisions)、リクエストは openai/gpt-6-luna-decisions | openai/gpt-6-luna-decisions-20261006(提供元 OpenAI) |
| Jev | OpenRouter の同じ窓口、リクエストは typesafe/jev-1.13 | typesafe/jev-1.13-20260917 |
| Clef | Cloudflare Workers AI の REST(@cf/cloudflare/clef) | clef |
| Clef-flash | 同じ経路(@cf/cloudflare/clef-flash) | clef-flash |
計測条件は次のとおりです。
- 実行日は2026年10月9日。4モデルを並列4(同時に4件)で1回ずつ実行。再試行は転送失敗(429・5xx)のみで、失敗は0件。
- 問い文は前回(10月8日)のClef比較と同一で、6択、1問版、粗い4択、画像3問。全文は前回記事の付録「送った問いの全文」に載せています。
- 送った state(判定の材料)の形は
{"category", "product", "item", "price_jpy"}。product が当サイトの製品名、item が楽天の商品タイトル。 - 正解率は正解数÷件数。確信度の上位k件は、同点の並びを無作為に入れ替えた1000回の平均。
- 画像は幅768pxのJPEG(品質85)に変換してから送信。
画像の送り方だけは、一か所変えています。OpenRouter 経由の OpenAI は、画像を専用の欄(top-levelのimages)で受け付けず、HTTP 400が返りました。そこで、問いの本文(state)の中に、文字と画像(data URL)の配列として入れる形にしました。答えを見る前に、事前登録の記録へ追記してから直しています。Jev、Clef、Clef-flash は、89行すべて前日と同じ答えでした。
限界ははっきりしています。件数は89行、実行は1回、OpenAI の Decisions API はベータ版(2026年10月6日版)、経路は OpenRouter です。別の商品群でも同じ結果が出るかは、まだ分かりません。
公開にあたって、各社の規約も確認しました。OpenAI の共有と公開に関するポリシーには、APIに関する研究の公開を歓迎する旨の記載があります(2026年10月9日に確認)。OpenRouter の規約(2026年8月31日版)と、TypeSafe・Cloudflare の規約(10月7〜8日に確認)にも、確認できた範囲では性能比較の公開を禁じる条項は見当たりませんでした。Cloudflare の利用条件が再現に必要な情報の併記を求めているので、この節を設けています。これは法的な判断ではなく、確認した範囲の記録です。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事

GPT-5.6 Luna xhigh: 知能49・タスク単価$0.04・待ち時間40秒、安い理由まで実測
2026年7月30日の80%値下げ後、通常セッションのモデルをLunaに切り替えるべきか。OpenAI公式発表と第三者ベンチの実測データ(Intelligence Index、TTFT、タスク単価)から、API従量とCodex定額それぞれの判断材料を整理します。
GPT-6.1 Solをeffort別実測:medium 47.8、Astraとの差はどこまで縮むか
GPT-6.1 SolをDevDay 2026の発表とArtificial Analysisのeffort別実測で検証。旧Sol・Astraとの性能、費用、待ち時間から使い分けを判断します。

Jev・OpenAI Decisions・Clef、型番判定で最強はどれ?
Jev・OpenAI Decisions・Clefを楽天の型番判定189行で実測。正解数はOpenAI Decisions 165・Jev 146・Clef 141。規則の取り違えは指示文1文で直ったが、型番の見落としは直らなかった。
Codex CLI 0.112.0→0.114.0 で権限設計が変わった。request_permissions が実務で効く理由
Codex CLI 0.112.0から0.114.0で、権限要求の設計が段階的に進化。request_permissions、plugin拡張、承認フロー修正が実務でどう効くかを整理します。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:開発環境・キャリアまわりのサービス
 シンVPSを見る
 XServer VPSを見る
 strategy career の転職支援を見る