Clefへの乗り換えは待ち——Jevを選ぶ日本語判定、画像だけは別
楽天商品89行とサムネ9枚を同日比較。日本語ECの版数判定はJev、画像判定はClefが候補になる理由を実測で整理します。
このサイトの製品ページには楽天の値段も載せていて、その出品が「本当にこの製品か」をAIに見分けさせています。使っているのはTypeSafe社の「JevJevTypeSafe が出している、文章を書かずに判定の答えだけを返す AI モデル。詳しく →」で、文章は書かず、「はい/いいえ」や用意した選択肢から答えを選ぶことだけに特化したAIです。2026年10月1日、Cloudflare社がほぼ同じ使い方のできる「ClefClefCloudflare が出している、文章を書かずに判定の答えだけを返す AI モデル。画像も読める。詳しく →」と、軽量版の「Clef-flashClef-flashCloudflare の判定専用モデル Clef の軽量版。詳しく →」を公開しました。画像も読めて、Cloudflareの評価では多くの項目でJevを上回ったという発表です。
乗り換えるべきか、手持ちの日本語データで確かめました。文字で商品を見分ける用途はJevのままでよく、Clefを選ぶ理由は「画像を見て答えさせたいとき」だけ、というのが私の結論です。V2・II・Proのように型番の後ろに付く小さな違い(以下「版数語」)を、ClefはJevより多く見落としました。
検証は2026年10月8日の1日で、3つのAIに同じ問いと同じ商品データを送っています。比べたのは、楽天の出品が製品そのものかの見分け、表示中の楽天価格に付属品などが混ざっていないかのふるい分け、サムネイル画像に何が描かれているかの3つ。費用は合計約0.10ドル(無料枠を引く前)でした。
値段の取り違えを防ぐために、判定専用のAIを使っている
楽天で「TD500 Mesh」というPCケースを検索すると、後継の「TD500 Mesh V2」や専用の部品、そのケースを使った完成品PCまで一緒に出てきます。これをそのまま製品ページに載せると、読者は別の商品の値段を見て「安い/高い」を判断してしまう。件数が多いので、人がすべて目で確かめるのは現実的ではありません。
ふつうのチャットAIに「同じ商品ですか?」と聞くと、答えは文章で返ってきて、言い回しも毎回少しずつ変わります。プログラムで扱うには、そこからもう一度答えを読み取る手間がかかるんですよね。JevやClefは、用意した選択肢の中から必ず1つを選び、「どれくらい確かか」を数字(確信度)で返します。だから「自信が高いものは自動で処理し、低いものだけ人が見る」という仕組みが作りやすい。費用も安く、今回の約1,700回の呼び出し全体で約0.10ドルでした。
新しいAIが出るたびに「○○より高性能」と発表されますが、その評価に自分のデータ、今回なら日本語の商品名が含まれているとは限りません。この記事は、発表を信じて乗り換える前に、1日・1ドルもかからない規模で試して決めた記録でもあります。ノーコードやvibeコーディングでAIを組み込んでいる方も、同じやり方で判断できると思います。
商品の見分けでは、Jevが上でClefは合格線に届かなかった
楽天の検索で出てきた出品619件のうち、人の目で1件ずつ正解を付けた89件で比べました。AIには「この出品は、製品そのもの・別の型番・付属品・セット商品・無関係・判断できない、のどれか」を6つの中から選ばせています(前回Jevを試したときと同じ質問文です)。正解の内訳は、製品そのもの41件、別の型番35件、付属品6件、セット4件、判断できない2件、無関係1件です。
| モデル | 6択の正解率 | 版数語の見落とし(別の型番35件中、製品そのものと誤答) | 「製品そのものか」1問だけの正解率 | 応答時間(中央値) |
|---|---|---|---|---|
| Jev | 67%(60/89) | 26/35 | 64% | 392ms |
| Clef | 62%(55/89) | 32/35 | 64% | 431ms |
| Clef-flash | 64%(57/89) | 30/35 | 64% | 191ms |
Clefには事前に合格線を決めておきました。正解率80%以上、版数語の見落とし13件以下です。ClefもClef-flashも届いていません。別型番を本体と取り違えた件数はClefが32件で、Jevの26件より6件多い。私は事前にClefの正解率を75〜85%と予想していたので、正直、大外れです。
取り違えの中身を見ると、どれも型番を並べれば分かる違いです。製品名が「Cooler Master MasterBox TD500 Mesh」で、出品タイトルが「TD500 Mesh V2」のケースを、3モデルとも本体と判定しました。「ASRock B760 Pro RS WiFi」と「ASRock B760M Pro RS WiFi White」、「Hyper 212 Black Edition」と「Hyper 212 RGB Black Edition」、「M75 Wireless」と「M75 AIR」でも同じことが起きています。
6択の選択肢が多すぎて迷わせたのでは、とも考えました。そこで「このitemはproductの本体そのものですか」と1問に絞り、同じ型番、容量、世代、版数かを問う形でも試しています。結果は3モデルとも57/89、正解率64%。選択肢の数ではなく、日本語の装飾付き商品タイトルから版数語を拾うこと自体がつまずきの元でした。
3モデルとも正しく別物と判定できた版数違いは、ROG RYUJIN IIからIIIのように差がはっきりした2行だけです。版数の見分けをAIの読解だけに任せるより、型番やV2、II、SE、Pro、Liteなどの語をルールで照合する仕組みを残したほうが安全だと判断しました。
「Clefは確信度が正直」と一度書いて、撤回した
最初の集計では、確信度0.8以上の答えだけを自動で採用すると、Clefが94%(18件)、Jevが78%(54件)でした。この数字だけ見ると、Clefは自信のある答えを選ぶのがうまいように見えます。私も最初はそう読んで、「Clefは確信度が正直」と中間結論に書きました。
ところが、これは不公平な比べ方でした。Clefは18件、Jevは54件で、自動処理に回る件数が3倍違います。少ない件数だけを通したモデルのほうが、高い正解率に見えやすいのは当然です。そこでこの中間結論は撤回し、確信度の高い順に件数をそろえて数え直しました。結果は逆になります。
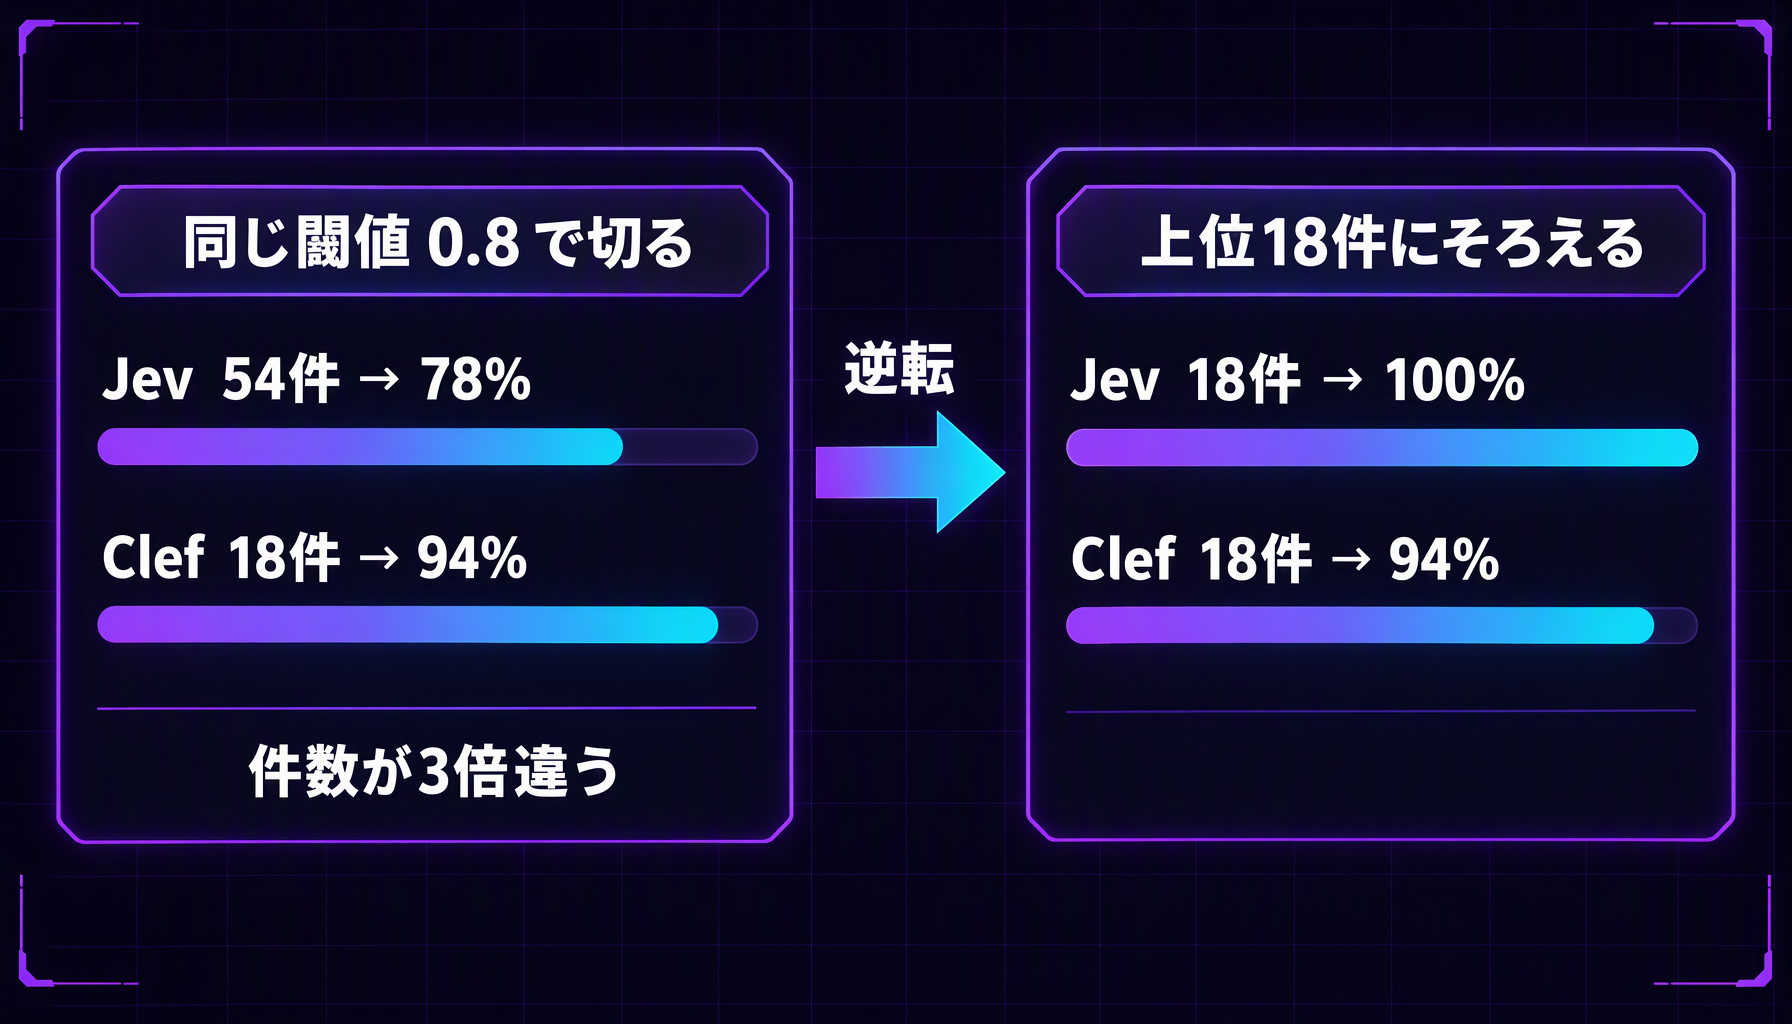
同じ閾値で切ると件数が3倍違う。件数をそろえると順位が入れ替わる
| 自動採用する上位件数 | Jev | Clef | Clef-flash |
|---|---|---|---|
| 18件 | 100% | 94% | 67% |
| 30件 | 91% | 83% | 60% |
| 54件 | 78% | 74% | — |
モデルごとに確信度の出し方や分布が同じとは限らないので、「自信があるときだけ自動処理」にするにしても、同じ0.8という閾値を置けばよいわけではありません。比べるときは、まず自動で採用する件数をそろえ、その件数で正解率と見逃しを確かめる。今回いちばん持ち帰ってほしいのは、実はこの手順です。
迷うとしたら、「同じ閾値でClefのほうが高く見えるから乗り換えるか」と「同じ件数を任せたとき本当に安全か」のどちらを信じるか、という場面だと思います。今回の上位18件、30件ではJevが上でした。
楽天価格のふるい分けでは、Clefだけが拾った商品もあった
次に、表示中の楽天価格383行を、本体(product_itself)・付属品(accessory)・セット(bundle)・無関係(unrelated)の4択でふるいにかけました。こちらは全件の正解を用意していないので、各モデルが「本体以外」と疑った行を目で確かめています。見ていない379行について、見逃しの総数は分かりません。
SoCSoCCPU・GPU などを1つのチップにまとめた部品。スマホやタブレットの頭脳。詳しく →カテゴリには、SoCの値段としてスマートフォンやタブレット本体の価格が載っている行が4つありました。Clefは4行すべてを拾い、Jevは3行、Clef-flashは2行です。OPPO A5はClefだけが拾いました。
一方で、疑いを出した件数はJevが3、Clefが6、Clef-flashが6。誤検知はJevが0、Clefが2、Clef-flashが4です。ClefはDellのノートPC本体と小型ケース本体を「セット」と判定し、Clef-flashはPCケース、Arc Pro B50のカード、ケースのBTF版、グリスを付属品またはセットと判定しました。
3モデルとも、事前に決めた「誤検知5件以下」は満たしています。ただし全件の正解率を測った試験ではないので、SoCカテゴリの端末価格をClefのほうが拾えた、という局所的な差として受け取ってください。
画像の判定は、Clefにしかできない実用上の差だった
ClefとClef-flashには、Jevにない画像入力があります。公開中のサムネイル9枚を使い、動物を線で描いたイラストがあるか、「Llama」という文字が書かれているか、見えるロゴやマークはどれかを尋ねました。題材はOllamaOllama(ローカルLLMランタイム)手元の PC でオープンウェイトの LLM を手軽に動かすための、無料のソフト。詳しく →記事のリャマ線画6枚、DGX Spark、Ryzen、Claudeプラグイン記事の画像です。
| モデル | 動物の絵 | 「Llama」の文字 | 見えるマーク |
|---|---|---|---|
| Clef | 9/9 | 9/9 | 9/9 |
| Clef-flash | 9/9 | 9/9 | 9/9 |
見えるマークは、複数のマークがある画像で「動物マスコット」と「上記以外」のどちらでも正解とする幅を持たせています。単一の正解として数えると、Clefは6/9、Clef-flashは7/9です。画像の正解は執筆側が目で見て付けました。最初の下書きではプラグイン画像を「マークなし」としていたのですが、実物を見直したらマークがあったので、送る前に「上記以外のマーク」を選択肢へ足しています。
NVIDIAとAMDは確信度0.84〜0.91で判定しました。うれしかったのはOllamaのリャマです。両モデルとも「動物の絵はあるが、Llamaという文字はない」と分けて答えました。この画像は以前、画像を文字に書き起こすモデルがMetaの「Llama」と取り違えたものなので、文字の有無と絵の中身を分けて聞ける点は、実務でそのまま使えそうです。
とはいえ、9枚の実演だけで画像認識の精度を言い切ることはできません。サムネイルにロゴがあるか、商品画像に特定のマークがあるか、といった「見えるものだけ」を尋ねる用途の候補になった、という範囲の話です。
画像はPNGのままだと送れず、768pxのJPEGで通った
画像では、AIの判定とは別のところで詰まりました。2〜3MBのPNGは、公式の上限4MiB以内なのにHTTP 413(送るデータが大きすぎるというエラー)で弾かれます。エラー表示を見ると、推定79万トークントークンAI が文章を読み書きする時の、文字を細かく区切った単位。料金もこの数で決まる。詳しく →が65,536トークンの上限を超えていました。
次の前処理で768pxのJPEGに変換すると、1枚約100KBになり、送れるようになりました(1枚目の実際の入力は766トークン)。
convert <thumbnail.png> -resize 768x -quality 85 <jpg>
画像を扱うなら、モデル選びの前に、入力画像を縮小する工程を組み込んでおく必要があります。公式のファイルサイズ上限だけを見て元画像をそのまま渡す前提で作ると、ここで止まります。
Cloudflareの評価と食い違うのは、測っているものが違うから
CloudflareがHugging Faceで公開している説明(HF README)のDecision Index 0.2.1では、BANKING77などの分類系でClefが上位に入り、GPQA、BBH、MMLU-Proなどの推論系ではJevが大きく上回っています。これはCloudflareが社内で実行した自社評価です。
ただ、その表に日本語の項目はなく、Jevの版や経路も書かれていません。今回の楽天タイトルは、日本語の商品名、型番、版数語、ショップ独自の装飾が混ざったデータです。評価の対象も入力の条件も違うので、Cloudflareの数字と今回の結果が食い違っても、そのままどちらかが間違っているとは言えません。
分類で強いと自社評価に出たモデルが、日本語の商品照合でも同じように強いとは限らない、ということです。自分のデータで89行ほど正解を作り、1日、約0.10ドル規模で同じ問いを送れば、乗り換える前の判断材料は少なくとも手に入ります。
再現したい方へ:経路・費用・条件
ここからは、同じことを試したい方向けの条件です。今回の数値は、2026年10月8日に実行した当方の実測です。3モデルとも並列4、実行1回で、再試行は429または5xxによる転送失敗だけに限りました。
| モデル | 経路 | 応答モデル |
|---|---|---|
| Jev | OpenRouterOpenRouter多くの会社の AI モデルを、1つの窓口と1つの請求でまとめて使えるサービス。詳しく → alpha decisions https://openrouter.ai/api/alpha/decisions | typesafe/jev-1.13-20260917 |
| Clef | Workers AI REST /accounts/<id>/ai/run/@cf/cloudflare/clef | clef |
| Clef-flash | Workers AI REST /accounts/<id>/ai/run/@cf/cloudflare/clef-flash | clef-flash |
AIに渡す材料(state)は{"category","product","item","price_jpy"}の形にし、productには当サイトの製品名、itemには楽天の商品タイトルを入れました。問いのidはidentityです。版数判定の問いは、「このitemはproductの本体そのもの(同じ型番・同じ容量・同じ世代・同じ版数(V2/II/SE/Pro/Liteなどの語))の販売ですか。色違いは本体。GPUはそのチップを搭載したカードを本体とみなす。」としました。pが0.5以上を本体として集計しています。
料金も書いておきます。単価は入力100万トークンあたりJevが0.042ドル、Clefが0.24ドル、Clef-flashが0.09ドル。実際の入力は、Jevが413,278トークンで約0.017ドル、Clefが236,827トークンで約0.057ドル、Clef-flashが236,827トークンで約0.021ドルでした。単価だけならClefはJevより高く、成績でも上回らなかったことになります。Cloudflareには1日10,000 neuronsの無料枠があります。
なお、Cloudflare上のJevはHTTP 402「Insufficient balance; add money to your gateway or use BYOK」で動かせませんでした。Workers AIの無料枠は他社のモデルには効かず、AI Gatewayの前払い残高か、TypeSafeの鍵の持ち込みが必要です。そのため、応答時間の中央値(Jev 392ms、Clef 431ms、Clef-flash 191ms)は経路が違う参考値で、速度の結論には使っていません。
日本語の商品照合はJevのまま、Clefは画像用の別枠にする
私の判断では、日本語ECの商品照合をJevからClefへまとめて移す理由はありません。89行の6択正解率はJev 67%、Clef 62%、Clef-flash 64%。版数語の見落としもClefのほうが多く、前回から問題になっていた「型番は近いが別物」は解消しませんでした。
確信度で自動処理を振り分ける場合も、今回のデータではJevを残します。Clefだけが高く見えた0.8閾値の比較は、件数をそろえると成り立ちませんでした。モデルを替えるなら、閾値をそのまま写さず、同じ自動処理件数で調整し直してください。
Clefを使う理由は画像です。サムネイルに特定のロゴがあるか、動物の線画があるか、指定した文字が画像の中にあるかを尋ねる用途では、今回の9枚で両モデルが必要な区別をつけられました。画像を768px程度のJPEGへ縮小する前処理を入れられるなら、商品照合の主役ではなく、ルール判定の前段や補助として試す価値があります。
Jevの版数判定とClefの画像判定を、同じ土俵で勝ち負けにする必要はないと思っています。日本語の商品照合は型番・版数語のルールを中心に置き、画像が要るところだけClef系に任せる。今回の実測から見て、これがいちばん無理のない組み方です。
Jevそのものの解説はJevが効く人、不要な人——選択肢を先に並べられるか、文字列照合とJevの分担を実データで測った前回の実測は判定モデルを判定不能147組で実測、人力の山はどこまで減るかにまとめています。今回の結果を踏まえても、版数をルールで持つという判断は変わりません。
参考資料(一次情報)
- Cloudflare 変更履歴: Introducing Clef: Cloudflare's first open-source decision models, now on Workers AI(2026-10-01・Jev 互換の主張と公表遅延)
- Cloudflare Workers AI モデルページ: Clef / Clef-flash / Jev(typesafe/jev)
- Cloudflare 料金: Workers AI Pricing(neurons 単価と 1 日 10,000 neurons の無料枠)
- モデルカード: Cloudflare/clef(Hugging Face)(Decision Index 0.2.1 の自社評価表・ベースモデル)
- Cloudflare ブログ: Clef decision models(学習方法)
- TypeSafe: Models(Jev 1.13)
付録:送った問いの全文
再現できるよう、3つの実験で送った問いをそのまま載せます(questions の中身。state は上の形です)。
6択(同一商品判定・"type": "choice"):
{
  "instructions": "product は当サイトに登録された製品名、item は楽天市場の検索ヒットの商品タイトルです。この item は product の「本体そのもの」の販売ですか。判定の基準: 同じ型番・同じ容量・同じ世代・同じ版数(V2/II/SE/Pro/Lite などの語)なら本体。色違いは本体。GPU の場合はそのチップを搭載したグラフィックカード製品を本体とみなす。product 側に容量・世代・版数の情報が無く、item がそのどれかである可能性が残る場合は ambiguous を選ぶ。",
  "criteria": {
    "match": "product の本体そのもの(色違い・販売店の在庫表記・型番コードの併記は同一とみなす)",
    "accessory": "product 用の保護フィルム・ケース・ブラケット・ケーブル・マウスパッド等の付属品や周辺品",
    "bundle": "product を搭載した完成品PC・ノートPC、または product と他の商品のセット販売",
    "different_sku": "別の型番・別容量・別世代・別版数(V2/II/III/SE/Lite/Pro/M/Mini/WiFi 付き等)・複数個セット・ジャンク",
    "unrelated": "product とは関係のない商品",
    "ambiguous": "product 側に容量・世代・版数の情報が無く、item が同一か別版か判断できない"
  }
}
粗い4択(楽天価格のふるい・"type": "choice"):
{
  "instructions": "product は当サイトに登録された製品名、item は楽天市場の商品タイトルです。item は product の本体そのものの販売ですか、それとも付属品・周辺品、product を含むセットや完成品PC、無関係な商品ですか。型番・世代・版数の細かい違いはここでは区別しません(本体と同じ種類の製品なら product_itself を選ぶ)。色違い、販売店の在庫表記、型番コードの併記は product_itself。GPU はそのチップを搭載したグラフィックカード製品を product_itself とみなす。",
  "criteria": {
    "product_itself": "product と同じ種類の製品そのもの(色違い・別メーカーのグラフィックカード・細かい版の違いを含む)",
    "accessory": "product 用の保護フィルム・ケース・ブラケット・ケーブル・交換部品・マウスパッド等の付属品や周辺品",
    "bundle": "product を搭載した完成品PC・ノートPC、または product と他の商品のセット販売",
    "unrelated": "product とは関係のない商品"
  }
}
画像の3問(state は「ブログ記事のサムネイル画像です。」、画像は images に base64 で1枚):
{
  "animal_drawing": {
    "type": "noul",
    "instructions": "画像の中に、動物(例: リャマ)を線や図形で描いたイラストがありますか。"
  },
  "word_llama": {
    "type": "noul",
    "instructions": "画像の中に、Llama という単語が文字として書かれていますか。"
  },
  "visible_mark": {
    "type": "choice",
    "instructions": "画像の中に見えるロゴやマークはどれですか。複数あるときは最も目立つものを選んでください。",
    "criteria": {
      "animal_mascot": "動物を描いたマスコットのイラスト",
      "nvidia_mark": "NVIDIA の文字または目のマーク",
      "amd_mark": "AMD の文字ロゴ",
      "other_mark": "上記以外のロゴやマーク(文字ロゴ・記号・アイコン)",
      "none": "ロゴやマークは見当たらない"
    }
  }
}
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事

Jev・OpenAI Decisions・Clef、型番判定で最強はどれ?
Jev・OpenAI Decisions・Clefを楽天の型番判定189行で実測。正解数はOpenAI Decisions 165・Jev 146・Clef 141。規則の取り違えは指示文1文で直ったが、型番の見落としは直らなかった。

OpenAI DecisionsはJevから乗り換え?単価2.4倍の答え
OpenAIのDecisions API(gpt-6-luna)をJev・Clefと同じ日に楽天89行で実測。型番違いの見落とし、確信度で任せられる件数、実費の差を整理しました。

Perplexity DeciderはJevから替える?11対0の判定差
Perplexity Decider V1.2を楽天の同一商品判定でJev・OpenAI・Clefと同じ89行で実測。正解率は合格線に1行届かず、版数語の取り違えは6モデル中最少でした。

d1-ultraはOpenAI Decisionsから替える?日本語型番で正解率91%
Liquid AIのd1-ultraを前作と同じ楽天89行で実測。日本語の型番違いの見落としは8モデル中最少で、無印d1はJev並み。費用・速さ・限界も。
META-MARK
GPU・CPU・PCパーツをMetaScoreで比較できます。
1,000件超のパーツデータベース。性能・効率・コスパの3軸スコアで、カタログスペックに振り回されない選択を。