高性能でも負けるArgon——Terminal-Bench 57.1%、Claude Sonnet 5.5は63.6%
Gemini 4 ArgonをArtificial Analysisの数値で検証。Claude Code・Codex利用者が乗り換える必要があるか、提供範囲と費用も含めて判断します。
2026年9月30日、Google が新しい最上位モデル Gemini 4 Argon を発表しました。Claude Code や Codex(どちらも、AI にコードを書かせたり直させたりする道具)を使っている人が迷うとしたら、「今の道具を使い続けるべきか、それとも Argon を待つべきか」の一点だと思います。
私の答えは、乗り換えなくていい、です。Argon はモデルの賢さだけなら Claude Opus 5.5 にかなり迫ります。それでも、使える人がまだごく一部に限られていますし、ターミナル作業に近い試験 Terminal-Bench では Claude の上位設定のほうが上です。Google の AI 開発環境 Antigravity にわざわざ移って Argon を選ぶ理由は、今のところ見当たりません。
数字は、AI モデルを同じ試験で採点して公開している Artificial Analysis から取りました。見るときは、同じ High 設定どうしと、各社の最上位設定どうしを分けます。ここを混ぜると、Argon が実際より強くも弱くも見えてしまうからです。普段のセッションでどのモデルを使うかは 2秒 vs 15秒:Codex・Claude Code・Grok、通常セッションの最適モデルを実測で選ぶ で実測しているので、そちらとあわせて読むと今回の話がつながりやすいと思います。
Argon はまだ、一般の Gemini 利用者の手元に届いていない
Google は Argon の用途として、実務のコーディング、法務・金融などの知的業務、サイバー防御を挙げています。ところが 2026年10月5日時点で使えるのは、Google の Fairwind Program に参加しているサイバー防御の提携先だけです。
次は有料 API の利用者、その次に Google AI Ultra の加入者へ順に広げる、と公式発表には書かれています。ただ、具体的な日付はどこにもありません。Antigravity、Gemini アプリ、Workspace での提供についても、公式発表には記載がありません。
私の Workspace アカウントで Antigravity CLI(agy)のモデル一覧を開いてみても、Argon は出てきません。設定を見直せば表示される、という種類の話ではなく、提供範囲そのものがまだそこまで来ていない、ということです。つまり Claude Code や Codex からの乗り換えを考える以前に、Argon を選べる人がほとんどいない状態です。
同じ High 設定なら、Argon は Opus 5.5 に次ぐ 52.6
Artificial Analysis が 2026年10月5日に掲載していた知能指数(同サイトが複数の試験からまとめている総合点)では、Gemini 4 Argon High は 52.6 でした。同じ High の Claude Opus 5.5 は 53.6 で、差は 1.0 しかありません。GPT-6 Astra は 50.9、GPT-6.1 Sol は 50.2、Claude Sonnet 5.5 は 46.8 です。
同じくらいの料金帯の Sol 6.1 や Sonnet 5.5 より、はっきり上にいます。Artificial Analysis の全224モデル中でも8位で、「Google の宣伝で高く見えているだけ」と片付けられる数字ではありません。
| モデル(High) | 知能指数 | 評価で使った出力トークン | 評価1課題あたり費用 |
|---|---|---|---|
| Claude Opus 5.5 | 53.6 | 53M | $1.82 |
| Gemini 4 Argon | 52.6 | 110M | 非公開 |
| GPT-6 Astra | 50.9 | — | — |
| GPT-6.1 Sol | 50.2 | 25M | $0.32 |
| Claude Sonnet 5.5 | 46.8 | 50M | $1.08 |
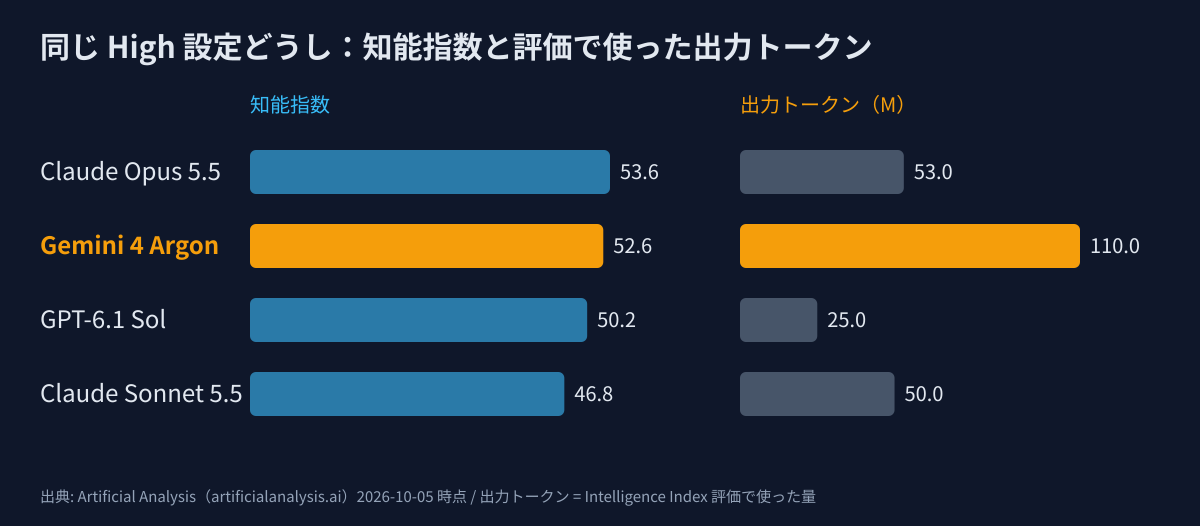
表を眺めていて引っかかったのは、知能指数ではなく、その隣の列でした。Argon が評価のために書き出した出力トークン(AI が読み書きする文章の量を数える単位)は 110M です。Sol 6.1 High の 25M の約4.4倍、Sonnet 5.5 High の 50M や Opus 5.5 High の 53M と比べても約2倍あります。
単価が同じでも、仕事を終えるまでに書く量が多ければ、請求額はそのぶん増えます。Artificial Analysis は Argon の評価費用を公開していないので、私はここで金額を推定しません。ただ、知能指数の順位が高いからといって、実際に API で動かしたときの費用まで Argon が有利だとは言えません。
各社の最上位設定で比べると Claude が上、Sol 6.1 とはほぼ互角
各社の一番深く考える設定(Max)を並べると、景色が変わります。Claude Opus 5.5 Max の知能指数は 57.6、Sonnet 5.5 Max は 56.0 です。一方、Argon は Artificial Analysis で High の1段しか計測されておらず、52.6 のままです。
Argon に High より上の設定があるかどうかは、公表されていません。なので Argon High と各社の Max を、同じ条件の勝負として扱うことはできません。それでも、いま確認できる設定どうしで比べるなら、Claude の Max が明確に上です。
| モデル・設定 | 知能指数 | Terminal-Bench v4.0 | HLE | SciCode | 長文読解 LCR |
|---|---|---|---|---|---|
| Claude Opus 5.5 Max | 57.6 | 59.6% | 61.4% | 66.9% | 84.7% |
| Claude Sonnet 5.5 Max | 56.0 | 63.6% | 55.0% | 61.0% | 82.7% |
| GPT-6 Astra Max | 52.7 | 59.1% | 54.7% | 56.5% | 80.7% |
| Gemini 4 Argon High | 52.6 | 57.1% | 57.1% | 61.8% | 79.7% |
| GPT-6.1 Sol Max | 51.8 | 56.1% | 52.9% | 54.2% | 83.0% |
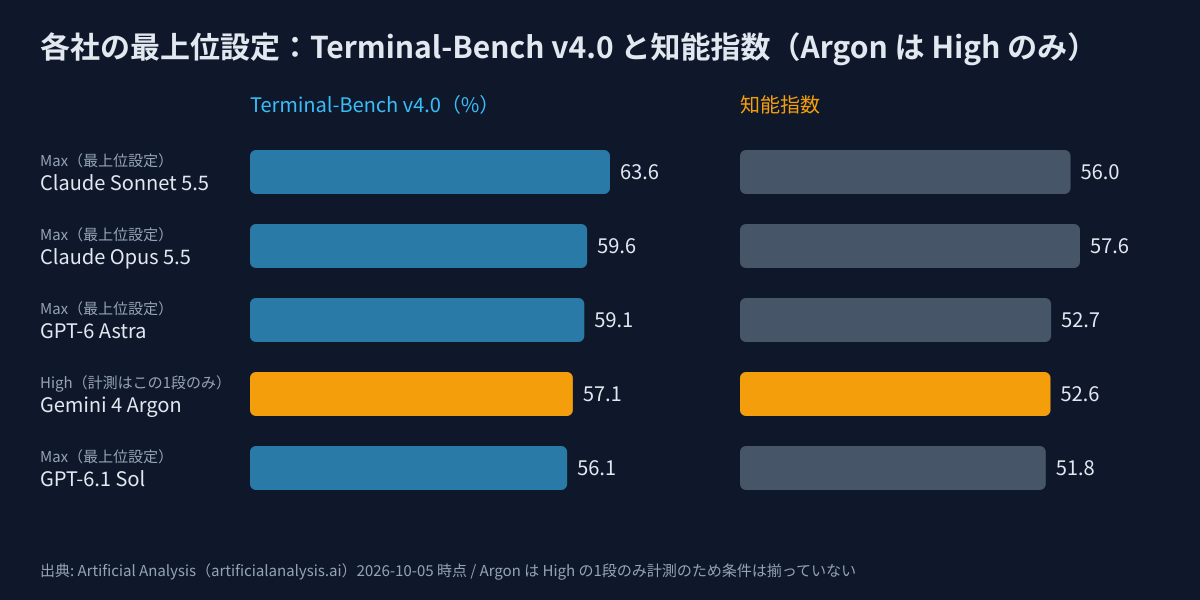
Claude Code や Codex を使っている人がいちばん見るべきなのは、Terminal-Bench v4.0 の列です。AI が自分でターミナル(文字で命令を打つ画面)を操作して課題を片付ける試験なので、知識問題よりも、コーディングを任せる道具の仕事にずっと近い物差しです。
ここで Argon High は 57.1% でした。Sonnet 5.5 Max は 63.6%、Opus 5.5 Max は 59.6% で、Sol 6.1 Max は 56.1% です。Argon は Sol 6.1 Max と 1.0 ポイント差で並び、Claude の上位設定には届いていません。
逆に、難しい知識問題の HLE では Argon が 57.1%、科学計算のコードを書く SciCode では 61.8% で、Sonnet 5.5 Max の HLE 55.0%・SciCode 61.0% を上回っています。難問や科学計算なら、Argon を試してみる意味はあります。ただしそれは、ターミナル作業で Claude の代わりが務まるという意味ではありません。
料金は今は Sonnet・Sol と同じ、記念期間が終わると Opus と同額
Argon の発売記念価格は、100万トークンあたり入力2ドル、出力10ドルです。Claude Sonnet 5.5 や GPT-6.1 Sol と同じ料金で、キャッシュ済みの入力(一度送った内容の使い回し)は入力単価から95%引きになります。
記念期間の後は、入力4ドル、出力20ドルになる予定です。これは Claude Opus 5.5 と同じ価格です。記念期間がいつ終わるのかは、公式には書かれていません。
料金と賢さを並べると、いまの Argon は「Sonnet・Sol の値段で、賢さは Opus のすぐ下」に見えます。ここだけ切り取るとかなりお得そうですが、先ほどの出力トークンの話を思い出すと、単価だけで判断するのは危ういです。実際の開発では、1つの作業を終えるまでにどれだけ書き出すか、何回やり直すかまで含めて費用が決まります。Argon は知能指数の評価で 110M トークンを使っていて、Sol や Claude の一部の設定より多くの出力を消費しています。
もう一つの特徴は、1回で書き出せる量です。Argon の出力上限は、前の世代の 64K トークンから 1M トークンへ広がりました。コンテキスト長コンテキスト長(Context Length)AI が1回のやりとりでまとめて扱える文章の長さの上限。トークン数で表す。詳しく →(一度に読み込める量)も Artificial Analysis では 1M トークンとされています。読み込める量なら他社の上位モデルにも 1M 級がありますが、書き出せる量まで 1M トークンというのは、長い成果物を一気に出させたい場面で Argon の強みになります。
一方で、出力の速さと、最初の文字が出てくるまでの時間は、Artificial Analysis でまだ計測されていません。遅いと確認されたわけではありませんし、出力上限が長いことが、そのまま日々の応答速度応答速度(ms)ディスプレイの画素が、ある色から次の色へ切り替わるまでにかかる時間。詳しく →や費用の有利さにつながるわけでもありません。
Argon は、9月後半の発表ラッシュの最後に出てきた
2026年9月は、上位モデルの発表が短い期間に集中しました。GPT-6 Astra が9月3日、Grok 4.7 が9月21日、Claude Opus 5.5 が9月22日、Claude Sonnet 5.5 が9月28日、GPT-6.1 Sol が9月29日、そして Gemini 4 Argon が9月30日です。
Argon はこの流れの一番最後で、しかも発表の時点では Fairwind Program の参加者しか使えませんでした。ここまでは確認できた事実です。そこから先、市場でどう受け止められるかは、また別の話として分けて考えたいところです。
なお Google 公式は、Vals 社の評価指標(Vals Index)で Argon が首位だと主張しています。Artificial Analysis とは評価の方法も物差しも違います。どちらか一方だけを正解にするより、自分の用途に近い試験を見たほうが、判断を誤りにくいと思います。
Claude Code・Codex 利用者は乗り換えなくていい、試すなら提供が始まってから
改めて、私の判断です。Claude Code や Codex を使っている人が、Argon のために Antigravity へ乗り換える必要はありません。コーディング作業に近い Terminal-Bench では Claude の上位設定が上で、Argon は Sol 6.1 Max とほぼ互角だからです。しかも 2026年10月5日時点では、一般の Workspace 利用者が Argon を選べる状態ですらありません。
モデルの性能を否定したいわけではありません。同じ High では Opus 5.5 に 1.0 ポイント差まで迫り、HLE と SciCode では Sonnet 5.5 Max を上回っています。1M トークンの出力上限も、長い成果物を一度に書き出させる用途なら立派な判断材料です。
だからこそ、Google AI Ultra の加入者や、Gemini API を中心に開発している人が、提供開始後に Argon を比較の候補へ加えるのは理にかなっていると思います。今の Google の環境から動かずに使えるなら、Claude や Sol とは違う強みを確かめられます。
迷うとしたら、自分の仕事がどちら寄りか、という点だと思います。Claude Code・Codex から移るか考えるなら、まず手元の作業を、Terminal-Bench に近いものと、HLE や SciCode に近いものに分けてみてください。
- ターミナルでリポジトリ(コード一式)を編集し、テストを直し、複数のファイルを触らせる仕事が中心なら、今の数字は移行を後押ししていません。
- 難しい調査や科学計算、長い成果物の一括出力が中心なら、提供が始まった後の検証候補になります。
性能は高い。ただ、出すのが遅かった。Opus 5.5、Sonnet 5.5、Sol 6.1 が9月後半の10日間で出揃った直後に、Argon は一般には使えない形で登場しました。Google の環境にいる人は、提供が始まったら試す価値があります。でも、今の開発環境を捨ててまで待つモデルではありません。
同じ時期の比較はClaude Sonnet 5.5とGPT-6.1 Solの比較に、思考の深さを変えたときの差はGPT-6.1 Solのeffort比較とClaude Sonnet 5.5のeffort比較にまとめています。
参考リンク
- Gemini 4 Argon: our next era of frontier intelligence(Google 公式ブログ)
- Gemini 4 Argon(Artificial Analysis のモデルページ)
- Google releases Gemini 4 Argon(TechCrunch)
- 数値の出典: Artificial Analysis(2026年10月5日取得)
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事

effort を途中で変えるとキャッシュはどうなる? Fable 5.1 と Opus 5 で実測した
Fable 5.1 の値下げはキャッシュ読みだけ。Claude Code が TTL を決める仕組み、キャッシュを壊す操作と壊さない操作、effort 切替時の再書き込みを Fable 5.1 と Opus 5 の usage で実測しました。

Anthropicリーク2連発:Claude MythosとClaude Code流出で見えたKAIROS、BUDDY、Undercover Modeの正体
Anthropicの2週間で2回のリークを整理。Claude Mythosの位置づけ、Claude Code流出の中身、KAIROS/BUDDY/Undercover Modeの意味を分けて読む。
reasoning effort 早見表——ChatGPTとClaudeの結論
ChatGPTとClaudeのreasoning effortを公式ドキュメントで突き合わせた早見表。既定値の違い(Claudeはhigh、GPT-5.6はmedium)、段階名が同じでも中身が違う理由、ultracodeはmaxの上ではないという誤解の訂正まで。

直ったのは生物分野だけ――Claude Code で Fable 5 の拒否が続く理由
8月7日のFable 5再調整は生物分野に限定。Claude Codeで拒否を招く三層の原因と、Opus 5との使い分けを整理します。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:開発環境・キャリアまわりのサービス
 シンVPSを見る
 XServer VPSを見る
 strategy career の転職支援を見る