単価は同じでもxhighの評価費用は約7倍:Sonnet 5.5とGPT-6.1 Sol
同じ入力$2・出力$10でも、xhighのAA評価費用は約7倍。速度・賢さの天井・出力トークンから使い分けを判断します。
こんにちは。9月も終わりが近づいて、ようやく秋の入り口らしくなってきましたね。そんな時期に、同じ値札の AI モデルが1日違いで2つ並びました。
Claude Sonnet 5.5 と GPT-6.1 Sol は、どちらも入力$2・出力$10です。値札だけ見れば同じコストで使えそうですが、Artificial Analysis(AI モデルを同じ試験で採点して公開しているサイト)の数字を同じ考える深さどうしで並べると、評価1課題あたりの費用は xhigh で Sonnet 5.5 が$2.74、GPT-6.1 Sol が$0.39でした。約7倍の差です。
ただ、安い側がすべて勝つわけではありません。GPT-6.1 Sol は medium〜xhigh で、評価費用あたりの知能指数が高くなっています。一方で Sonnet 5.5 は、返事を書き始めるまでの速さと、max まで上げたときの到達点で上回ります。見るべきは単価ではなく、そのモデルがどこに計算量を使うのか、です。
1日違いで出た、同じ値札の2モデル
Sonnet 5.5 は2026年9月28日、GPT-6.1 Sol は9月29日に公開されました。GPT-6.1 Sol は OpenAI の DevDay 2026 で、Astra Ultrafast や月額500ドルの新 Pro プランなどと同じ日に発表されたモデルです(DevDay 2026の振り返り)。料金はどちらも、1Mトークン(トークンは AI が文章を数える単位)あたり入力$2、出力$10。GPT-6.1 Sol にはキャッシュ済み入力$0.10という公式情報があります。Sonnet 5.5 のキャッシュ料金は Sonnet 5 と同じと案内されていますが、今回の比較では具体額を扱いません。
どちらも effort(どれだけ考えてから答えるかの段階)を low、medium、high、xhigh、max の5段階で持っています。ここで一つ引っかかるのが既定値で、API の既定は Sonnet 5.5 が high、GPT-6.1 Sol が medium です。名前だけ指定して使うと、最初から同じ深さで動いているわけではありません。
medium では GPT-6.1 Sol のほうが賢く、費用は約3分の1
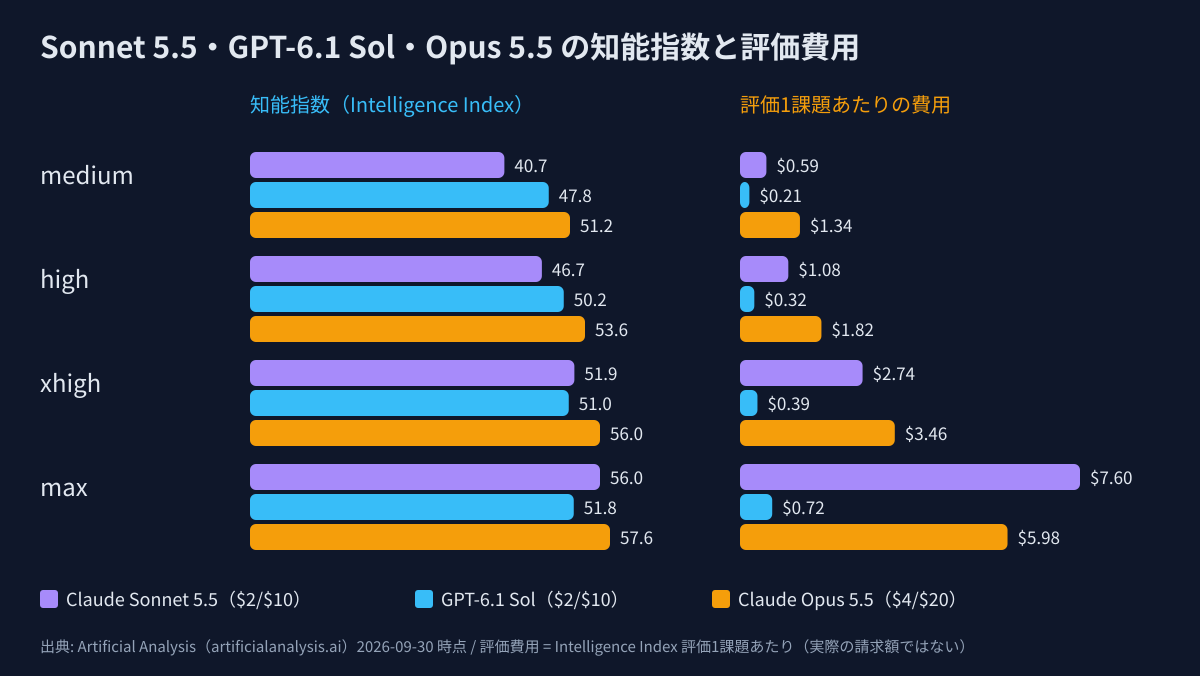
2026年9月30日に取得した Artificial Analysis の値では、medium の知能指数(複数の試験をまとめた総合点)は GPT-6.1 Sol が47.8、Sonnet 5.5 が40.7でした。評価1課題あたりの費用はそれぞれ$0.21と$0.59です。Sol のほうが知能指数は7.1高く、費用は Sonnet 5.5 の約3分の1に収まっています。
単価は同じなのに、なぜこうなるのか。理由は、評価中に AI が書き出した量です。評価で生成した出力トークンは Sonnet 5.5 が29M、GPT-6.1 Sol が15Mでした。出力の速さよりも、答えを出すまでにどれだけ考え続けるかが請求額に効いてくる、という構造です。
high でも傾向は変わりません。GPT-6.1 Sol は知能指数50.2・費用$0.32、Sonnet 5.5 は46.7・$1.08でした。おもしろいのは段を上げたときの伸び方で、medium から high へ上げると Sol は2.4、Sonnet 5.5 は6.0伸びています。同じ「一段上げる」でも、効き方はモデルによって違います。
xhigh では賢さがほぼ並ぶのに、費用は約7倍違う
xhigh になると、差の見え方が変わります。知能指数は Sonnet 5.5 が51.9、GPT-6.1 Sol が51.0で、Sonnet 5.5 が0.9上です。ところが評価費用は Sonnet 5.5 が$2.74、GPT-6.1 Sol が$0.39。ほぼ同じ水準に届くための費用が、Sonnet 5.5 では約7倍かかっています。
出力トークンは Sonnet 5.5 が100M、GPT-6.1 Sol が36Mです。単価が同じでも、書き出す量が約2.8倍違えば、課題単位の費用は同じになりません。値札が同じだから同じ費用、と考えてしまうのが、今回の比較で最初に確かめたかった落とし穴です。
一つだけ断っておくと、ここでいう「評価1課題あたり費用」と「評価で使った出力トークン」は、Artificial Analysis の Intelligence Index 評価での値です。皆さんが API を使ったときに、そのまま同じ請求額になるわけではありません。実際の請求は、入力する文章、出力の長さ、キャッシュ、利用するプロバイダーなどで変わります。
max まで上げると、Sonnet 5.5 が GPT-6.1 Sol より高い所に届く
最上段では順位が逆転します。Sonnet 5.5 max は知能指数56.0、GPT-6.1 Sol max は51.8で、差は4.2です。Artificial Analysis の全674行の中では、Sonnet 5.5 max が Claude Opus 5.5 xhigh と同点で2番手、GPT-6.1 Sol max は10位でした。
その代わり、Sonnet 5.5 max は評価費用$7.60、出力トークン410Mです。GPT-6.1 Sol max は$0.72、67Mでした。Sonnet 5.5 は xhigh の51.9から max の56.0まで4.1伸びますが、Sol は xhigh の51.0から max の51.8まで、0.8の伸びにとどまります。Sonnet 5.5 は、たくさん書き出すことで上限を取りに行く作りだと言えます。
この差が意味を持つのは、GPT-6.1 Sol の最上段でも届かない「あと一段の推論」が要る最難関の課題です。逆に、すべての処理を max にすると、費用と待ち時間のほうが先に問題になります。この水準を本気で取りに行くなら、次の Claude Opus 5.5 も候補に入ってきます。
Claude Opus 5.5 は単価2倍でも、56.0の水準では評価費用が安い
同じ日の Artificial Analysis には、Claude Opus 5.5 の5段もそろっています。Opus 5.5 の単価は入力$4・出力$20で、ここまでの2モデルのちょうど2倍です。それでも評価1課題あたりの費用で並べると、上のほうの水準では順番が入れ替わります。
| effort | GPT-6.1 Sol | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|
| low | 42.1・$0.13 | 未掲載 | 42.3・$0.55 |
| medium | 47.8・$0.21 | 40.7・$0.59 | 51.2・$1.34 |
| high | 50.2・$0.32 | 46.7・$1.08 | 53.6・$1.82 |
| xhigh | 51.0・$0.39 | 51.9・$2.74 | 56.0・$3.46 |
| max | 51.8・$0.72 | 56.0・$7.60 | 57.6・$5.98 |
(知能指数・評価1課題あたりの費用。2026年9月30日のArtificial Analysis)
知能指数56.0には、Opus 5.5 xhigh と Sonnet 5.5 max が同点で並んでいます。評価費用は Opus 5.5 xhigh が$3.46、Sonnet 5.5 max が$7.60。評価で使った出力トークンは Opus 5.5 xhigh が100M、Sonnet 5.5 max が410Mでした。単価が2倍でも、同じ水準に届くまでに書き出す量が少なければ、課題単位ではかえって安くなります。最上位の Opus 5.5 max は57.6で全674行の1位、評価費用は$5.98でした。
一方、51前後の水準では GPT-6.1 Sol が有利なままです。Sol xhigh は51.0・$0.39、Opus 5.5 medium は51.2・$1.34、Sonnet 5.5 xhigh は51.9・$2.74でした。Opus 5.5 は medium の段で Sol の max(51.8)とほぼ同じ所に届きますが、費用は Sol xhigh の3倍を超えます。
気をつけたいのは待ち時間で、Opus 5.5 は3モデルの中で最も長くなります。最初のトークンまでは medium で12.75秒、xhigh で53.97秒でした。短い返事を速く返してほしい用途には向きません。
返事を書き始めるのは Sonnet 5.5 のほうが速い
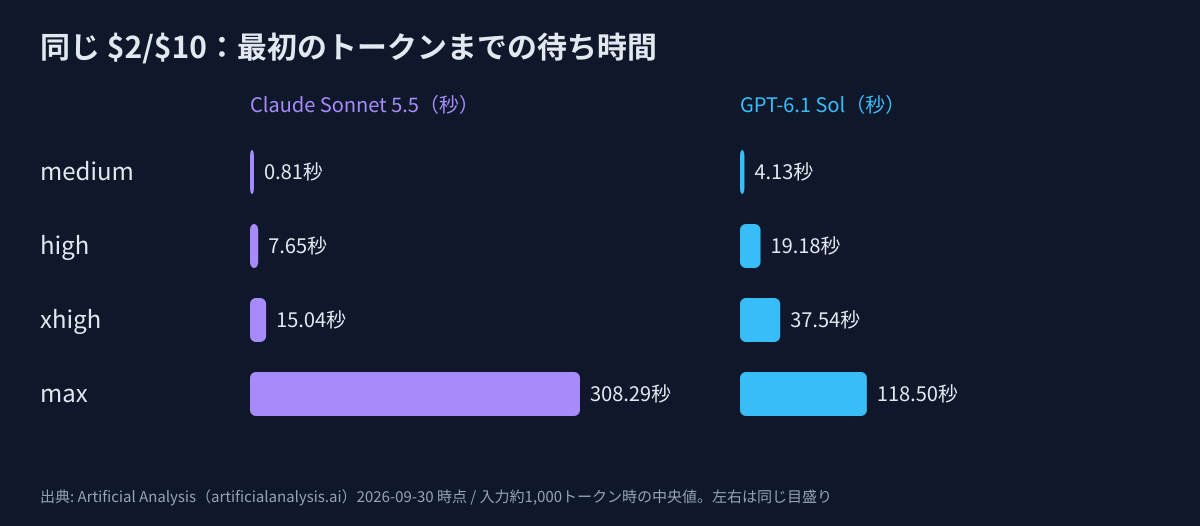
最初のトークンが出るまで(返事を書き始めるまで)の時間は、medium で Sonnet 5.5 が0.81秒、GPT-6.1 Sol が4.13秒でした。xhigh では15.04秒と37.54秒です。同じ段なら、最初の一文字を待つ時間は Sonnet 5.5 のほうが短く済みます。
書き出す速さも、今回の表では全段で Sonnet 5.5 が上でした。xhigh では Sonnet 5.5 が109.7 tokens/s、GPT-6.1 Sol が89.2 tokens/s です。ただし、書く速さが速くても、考え始めるまでの時間や書き出す量が多ければ、終わるまでの時間は別物として見る必要があります。
会話、分類、短い頼みごとのように、最初の反応を早く返したい場面では、medium の0.81秒という差がそのまま扱いやすさになります。ここで Sonnet 5.5 を選ぶ理由は、知能指数の数字だけでは説明しきれない部分です。
私は Claude Code と Codex で、取り次ぎと重い思考を分けている
私は Claude と ChatGPT の両方を契約しています。Claude Code(Anthropic の、AI にコードを書かせる道具)のメインは Opus 5.5 の effort medium です。そのうえで、Codex(OpenAI 側の同じような道具)へ仕事を取り次ぐ補助役のサブエージェント3体を Sonnet 5.5 medium で動かし、設計と、詰まったときの救援は GPT-6.1 Sol xhigh、実装は GPT-6.1 Sol medium に渡しています。2026年9月30日には、設計役と救援役を GPT-6 Astra から GPT-6.1 Sol へ入れ替え、実装役の effort を high から medium に下げました。medium の知能指数47.8・評価費用$0.21なら、設計書どおりに手を動かす役には足りると判断したからです。
この分け方では、Sonnet 5.5 には短い仕事、見張り、結果の回収を任せています。返事を書き始めるのが速いからです。一方で評価費用は medium でも Sol より高いので、長い推論を Sonnet 5.5 に抱え込ませることはしません。重い設計や救援は、同じ段なら評価費用が低く、medium・high では知能指数も高かった GPT-6.1 Sol に渡します。
もちろん、これはどんな構成にも当てはまる結論ではありません。契約先を一つに絞るなら、そのサービスの中で、既定の effort、待ち時間、キャッシュの条件まで含めて選ぶ必要があります。
何に払うかで GPT-6.1 Sol と Sonnet 5.5 を使い分ける
迷うとしたら、たぶん二つです。「速く返す役に Sonnet 5.5 を置くか、最初から Sol に寄せるか」と、「最難関の課題だけ上の水準に上げるとき、何を使うか」。
私の判断では、ふだんの API 処理や重い推論を費用効率よく回すなら、GPT-6.1 Sol が扱いやすいです。medium で47.8、xhigh で51.0に届き、同じ段の Sonnet 5.5 より評価費用が低いからです。返事を書き始める速さを優先したい処理には Sonnet 5.5 を残します。知能指数の上限を取りに行く用途では、単価が2倍でも Claude Opus 5.5 の xhigh か max を先に検討します。56.0の水準に評価費用$3.46で届き、Sonnet 5.5 max の$7.60より安いからです。
同じ$2/$10という表示だけで選ぶと、比較の大事な部分を見落とします。GPT-6.1 Sol は少ない出力トークンで評価スコアを伸ばし、Sonnet 5.5 は返事の早さを持ち、Opus 5.5 は単価の高さを書き出す量の少なさで取り返して上の水準を取りに行く。私なら、契約先を決めたあとで、medium・high・xhigh を実際の仕事ごとに割り振ります。
Artificial Analysisの比較条件
- データ基準日は2026年9月30日。数値はArtificial Analysisの同日データから取得。
- Sonnet 5.5のAA行はすべてDefault Fallback条件。GPT-6.1 Solとの測定条件が完全に同一とは限らない。
- Claude Opus 5.5のAA行もすべてDefault Fallback条件。評価費用と出力トークンは各モデルページの記載値(low・high・maxは同日に追加で取得)。
- Sonnet 5.5のlowは同日未掲載。2026年9月29日の値は知能指数35.8だが、費用と出力トークンは比較対象にしていない。
Sonnet 5.5 の effort ごとの読み方はClaude Sonnet 5.5 effortガイド、GPT-6.1 Sol はGPT-6.1 Sol effortガイドに分けて整理しています。Opus 5.5 との比較条件を確かめたいときはClaude Opus 5.5 effortガイドもどうぞ。
出典: Artificial Analysis(Opus 5.5はxhigh・maxほか各effortのモデルページ)。公式仕様はClaude Sonnet 5.5の変更点、Sonnet 5.5のプロンプトガイド、OpenAIによるGPT-6.1 Solの発表、GPT-6.1 Sol APIモデルページを確認しています。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
META-MARK × AI
AI モデル選びの次は、動かす場所です。
エージェントや自作ツールを止めずに動かすなら、常時稼働できる置き場所が要ります。手元の GPU で動かす場合の必要スペックも確認できます。


関連記事

Claude Fable 5.2はLowでも旧版の最高点超え、費用は約3割|Opus+相談役よりLowで直接使う方が安かった
11月9日に出た Claude Fable 5.2 を、Artificial Analysis の指数と1問あたり費用で Fable 5.1・Opus 5.5 と比べました。Opus を本体に Fable を相談役(advisor)にする構成が得かどうかも、Anthropic の社内計測で確かめます。

Anthropicリーク2連発:Claude MythosとClaude Code流出で見えたKAIROS、BUDDY、Undercover Modeの正体
Anthropicの2週間で2回のリークを整理。Claude Mythosの位置づけ、Claude Code流出の中身、KAIROS/BUDDY/Undercover Modeの意味を分けて読む。

effort を途中で変えるとキャッシュはどうなる? Fable 5.1 と Opus 5 で実測した
Fable 5.1 の値下げはキャッシュ読みだけ。Claude Code が TTL を決める仕組み、キャッシュを壊す操作と壊さない操作、effort 切替時の再書き込みを Fable 5.1 と Opus 5 の usage で実測しました。
高性能でも負けるArgon——Terminal-Bench 57.1%、Claude Sonnet 5.5は63.6%
Gemini 4 ArgonをArtificial Analysisの数値で検証。Claude Code・Codex利用者が乗り換える必要があるか、提供範囲と費用も含めて判断します。
AI年表で詳しく見る
📅Claude Sonnet 5.5
Claude Sonnet 5.5——料金は Sonnet 5 のまま、「速さと賢さの最良の組み合わせ」をうたう中位モデル