Opus 5.5をeffort別に比較:mediumは10.4秒で全673モデル中8位
Claude Opus 5.5のeffort別性能・待ち時間・単価を比較し、mediumを常用しhigh以上へ切り替える判断基準を整理します。
こんにちは。日が短くなって、夕方があっという間に暗くなる季節になりましたね。
Claude Opus 5.5 の普段使いは、medium を基準にするのがいちばん無理がありません。effort は「AI が答える前にどれだけ考えるか」を5段階で選ぶ設定で、軽い作業は low、メインの実務は medium、詰まった問題にだけ high 以上を使う。この3段階に分けると、賢さと待ち時間の交換条件が見やすくなります。私自身も、普段の簡単なセッションは low、少し難しいメインのタスクは medium で使っています。
迷うとしたら、「最初から high にしておけば安心では」と「medium で待ち時間を抑えたほうが作業は進む」のどちらを取るか、だと思います。Artificial Analysis の2026年9月26日時点のデータでは、Opus 5.5 は low から medium へ上げた一段で知能指数が最も大きく伸びます。一方、medium より上は待ち時間の増え方が急です。以下、その数字を順に見ていきます。
Opus 5.5 は値下げされ、何も指定しないと medium で動くようになった
Claude Opus 5.5 は2026年9月22日に公開されました。API 価格は入力100万トークンあたり4ドル、出力100万トークンあたり20ドルです(トークンは AI が文章を数えるときの単位です)。キャッシュ読み取りは0.20ドル、コンテキスト(一度に覚えていられる会話の量)は100万トークン、最大出力は12.8万トークンです。Anthropic は、Opus 5 より約4割安い価格で、Fable 5.1 級の性能だと説明しています。
Opus 5 から乗り換える人が先に知っておきたいのは、既定の effort が high から medium になったことです。effort を指定しなければ、Opus 5.5 は Opus 5 以前より1段低い medium で動きます。性能が落ちたわけではなく、同じ会話でも最初に割り当てられる計算量が変わった、という話です。既定値だけを見て「前より浅くなった」と受け取ると、比較を取り違えます。
Anthropic の公式ベンチマークでは、Terminal-Bench 4.0 が66.4%で、Fable 5.1 の55.8%、GPT-6 Astra の57.9%を上回っています。ただし Terminal-Bench Science は58.7%対64.6%、AutomationBench は40.0%対41.4%で、こちらは Astra が上です。Opus 5.5 がすべての仕事で勝つ、というデータではありません。
low から medium の一段で、知能指数が8.9伸びる
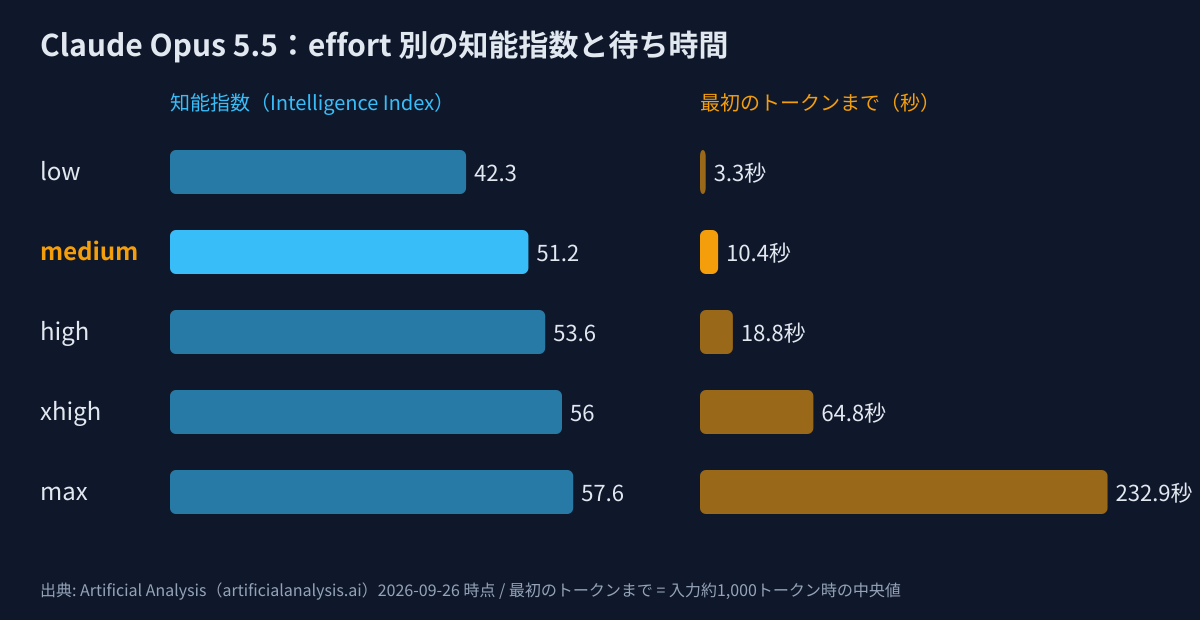
Artificial Analysis の知能指数(AI モデルを同じ条件で測った総合点)は、Opus 5.5 の low が42.3、medium が51.2、high が53.6、xhigh が56.0、max が57.6でした。low から medium で8.9ポイント上がりますが、その先は high まで2.4、xhigh まで2.4、max まで1.6ポイントです。伸びのほとんどが、最初の一段に集まっています。
どの effort でも単価は同じとはいえ、得られる差は均等ではないんですよね。medium から high へ上げても知能指数は2.4しか増えず、xhigh と max ではさらに待ち時間が伸びます。ここを常用設定にすると、難しい問題への保険を毎回買い続けるような使い方になりやすいです。
| Opus 5.5のeffort | 知能指数 | 最初のトークンまで | 出力速度 | API単価(入力/出力) |
|---|---|---|---|---|
| low | 42.3 | 3.3秒 | 76 t/s | $4 / $20 |
| medium | 51.2 | 10.4秒 | 76 t/s | $4 / $20 |
| high | 53.6 | 18.8秒 | 79 t/s | $4 / $20 |
| xhigh | 56.0 | 64.8秒 | 85 t/s | $4 / $20 |
| max | 57.6 | 232.9秒 | 99 t/s | $4 / $20 |
数値の出典は Artificial Analysis です。待ち時間は入力約1,000トークン時の中央値で、考えてから答えるタイプのモデルでは、その考えている時間も含みます。チャットで送信してから最初の返事が出始めるまでの体感に近い数字です。
medium を過ぎると、待ち時間が急に伸びる
出典: Artificial Analysis(2026-09-26 時点)のデータから作図
medium の待ち時間は10.4秒です。知能指数51.2は、Artificial Analysis の全673モデル中8位にあたります。なお、この673は effort 違いを別々に数えた件数で、Opus 5.5 自身の high 以上も上位に含まれています。同じ知能指数51.2には Fable 5.1 の high もいますが、Fable の API 単価は入力10ドル・出力50ドルで、Opus 5.5 の2.5倍です。待ち時間は Fable 5.1 high が8.8秒と medium より短いので、そこは単価との交換になります。
上の段を見ると、high は18.8秒で知能指数53.6、xhigh は64.8秒で56.0、max は232.9秒で57.6です。max は返事を待つだけで約4分かかる中央値なので、雑談や軽い修正に置く設定ではありません。最大の知能指数がどうしても要る一回の調査や、どうしても解けない実装の詰まりに使う段階です。
知能指数40〜53のモデルと並べると、Opus 5.5 medium の立ち位置が見える
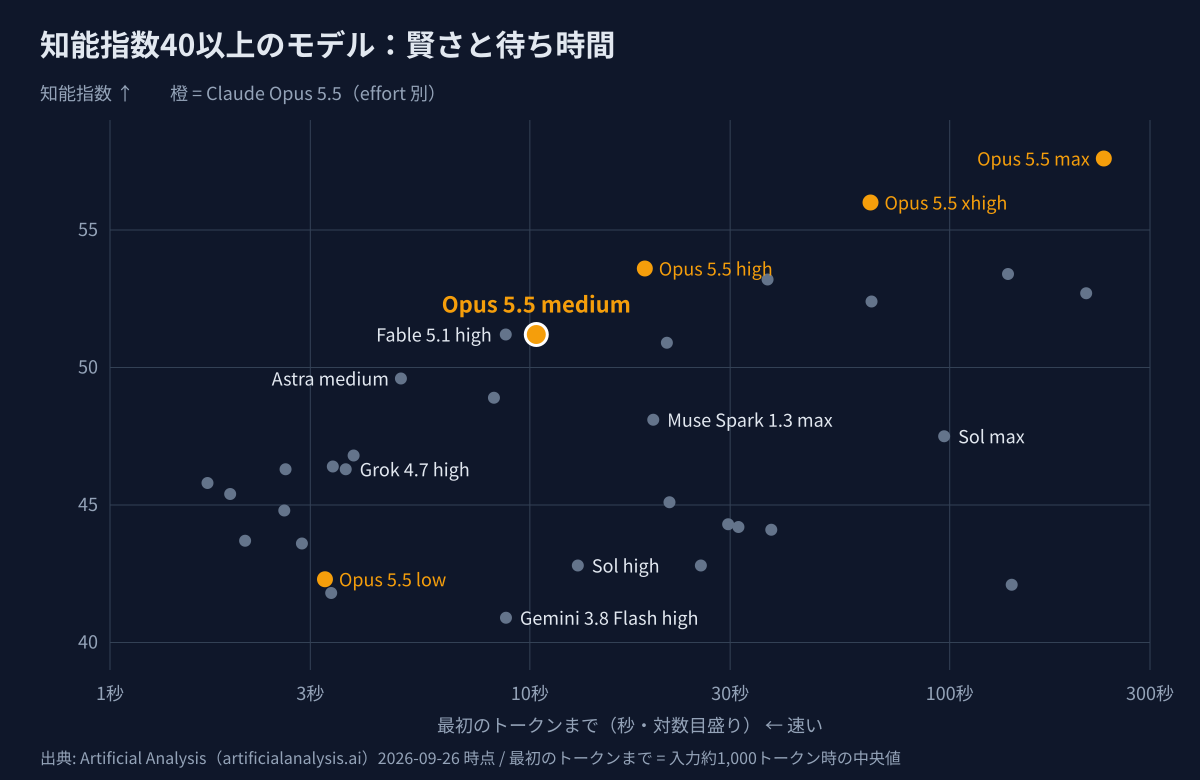
Opus 5.5 medium と同じくらいの賢さの帯には、速さや価格で勝るモデルもあります。GPT-6 Astra medium は知能指数49.6で、最初のトークンまで4.9秒と速い。ただし入力10ドル・出力50ドルで、Opus 5.5 medium より高価です。Astra high 以上は知能指数50.9〜52.7まで上がりますが、待ち時間は21.2秒、65.1秒、211.4秒と伸びていきます。
GPT-6 Sol は入力2ドル・出力10ドルで、Opus 5.5 の半額です。Sol high は知能指数42.8で最初のトークンまで13.0秒、xhigh は44.1で37.6秒でした。medium の51.2と同じ帯ではありませんが、ChatGPT 契約者が普段の作業を安く回す選択肢としては筋が通っています。ひとつ注意したいのは、OpenAI が示す「Sol xhigh が Opus 5 の max を上回り、1タスクあたり約9%の費用」という比較です。相手は Opus 5.5 ではなく Opus 5 です。
Grok 4.7 high は知能指数46.3、最初のトークンまで3.6秒で、入力2ドル・出力6ドル。Muse Spark 1.3 max は知能指数48.1、19.7秒、入力1.25ドル・出力4.25ドルでした。Gemini 3.8 Flash high は知能指数40.9、8.8秒、入力0.75ドル・出力3.75ドルで、出力速度も278 t/s あります。Gemini を契約しているなら、軽い普段使いを Flash に寄せる判断は数字で説明できます。ただしこの価格は2026年12月31日までで、2027年1月1日から倍額になると案内されています。
| モデル・設定 | 知能指数 | 最初のトークンまで | 入力/出力 $/1M |
|---|---|---|---|
| Claude Opus 5.5 medium | 51.2 | 10.4秒 | $4 / $20 |
| Claude Fable 5.1 high | 51.2 | 8.8秒 | $10 / $50 |
| GPT-6 Astra medium | 49.6 | 4.9秒 | $10 / $50 |
| Muse Spark 1.3 max | 48.1 | 19.7秒 | $1.25 / $4.25 |
| GPT-6 Sol max | 47.5 | 97.0秒 | $2 / $10 |
| Grok 4.7 high | 46.3 | 3.6秒 | $2 / $6 |
| Gemini 3.8 Flash high | 40.9 | 8.8秒 | $0.75 / $3.75 |
出典: Artificial Analysis(2026-09-26 時点)のデータから作図。左上ほど「賢くて待たない」
この表には、Artificial Analysis で速度が計測されているモデルだけを載せています。未計測の行は外しました。並べてみると、知能指数が同じでも料金と待ち時間はそろいません。逆に、安くて速いモデルが Opus 5.5 medium と同じ賢さの帯にいるとも限りません。
medium より上は、詰まりを抜くために取っておく
Opus 5.5 の high、xhigh、max は、同じ契約の中に用意された上の段です。Artificial Analysis の総合上位3つは、Opus 5.5 max の57.6、xhigh の56.0、high の53.6で占められています。medium でも全673モデル中8位ですが、さらに上を使える場所が同じ会話の中に残っています。
途中で段を上げるときに気になるのが、プロンプトキャッシュ(同じ会話の前半を覚えておいて、送り直す手間と費用を省く仕組み)が切れないかどうかです。公式ドキュメントでは、Opus 5.5 は会話の途中で effort を変えてもキャッシュが保たれると説明されています。条件は、会話の途中に「ここから effort を変える」という目印を挟む方式で変えることです(API ではベータ)。会話全体の設定値そのものを書き換える方式では、キャッシュは最初からやり直しになります。契約しているサービスの画面での操作と API の挙動は同じとは限らないので、お使いの環境が対応しているかは確認してください。
私自身は、簡単なセッションを low、少し難しいメインの作業を medium に置いています。この記事の準備中も、同じ会話のまま/effortを low から medium へ上げて作業を続けました。最初から max に固定するより、作業の流れを保ったまま必要な場面だけ計算量を足せるほうが、実務では扱いやすいと感じています。
max にすると、使うトークンは約6.8倍になる
単価の表だけを見ると、effort を上げても料金は変わらないように見えます。でも4ドル/20ドルは100万トークンあたりの単価で、effort が変えるのは「使うトークンの量」のほうです。Artificial Analysis の無料 Data API にはこの量が入っていないので、各モデルのページ(例:Opus 5.5 medium)の要約欄から、知能指数の評価1タスクあたりの費用と、評価全体で使った出力トークン数を拾いました(2026-09-26 時点、知能指数はページ上の整数表示)。
| Opus 5.5のeffort | 知能指数 | 1タスクあたりの費用 | 評価で使った出力トークン |
|---|---|---|---|
| low | 42 | $0.55 | 20M |
| medium | 51 | $1.34 | 38M |
| high | 54 | $1.82 | 53M |
| xhigh | 56 | $3.46 | 100M |
| max | 58 | $5.98 | 260M |
medium から max へ上げると、出力トークンは約6.8倍(38M→260M)、1タスクあたりの費用は約4.5倍($1.34→$5.98)になります。それで得られる知能指数の差は7です。一方、low から medium は費用が約2.4倍で、知能指数が9上がります。いちばん割のよい一段はここです。
出力トークンが増えるということは、会話の容量を早く埋め、サブスクリプションの利用枠も早く減るということです。「同じ価格だから max を常用しても無料」ではありません。ついでに比べておくと、medium の$1.34は、同じ知能指数51の Fable 5.1 high($3.91)の約3分の1です。
他社も公平に見ておくと、GPT-6 Astra medium は19Mという少ないトークンで知能指数50に届いていて、トークン効率ではこの帯でいちばん優秀です。費用の安さでは、GPT-6 Sol の medium が$0.25、Luna の low が$0.0045と、桁が違います。
契約先によって、Opus 5.5 の置きどころは変わる
Claude Pro や Max で Opus 5.5 を主に使うなら、medium を標準にして、軽い依頼だけ low、詰まったときだけ high 以上へ上げる運用が最も納得しやすいです。low から medium の知能指数差が8.9あるのに、待ち時間は3.3秒から10.4秒に増えるだけだからです。ここは毎回払ってもいい待ち時間だと思います。
ChatGPT 契約者なら、GPT-6 Sol を普段使いに回し、難しいコードや長い会話の継続性を Opus 5.5 medium に任せる分担が現実的です。Sol は API 単価が半分で、OpenAI の契約内でも使えます。Astra medium も待ち時間4.9秒と速く、知能指数49.6も十分高いので、ChatGPT の中で賢さと速さを両立したいときの候補になります。ただ単価は Opus 5.5 の2.5倍なので、API で大量に回す用途では差が出ます。
Gemini 契約者なら、Gemini 3.8 Flash high を速くて安い普段用にして、Opus 5.5 を難しい実装や判断の軸に置く組み合わせが考えられます。Flash high は Opus 5.5 medium より知能指数が低い一方、出力速度278 t/s と単価の低さがあります。すべてを一つのモデルに集める必要はありません。
同じ Claude 契約の中で性能の天井まで手が届くこと。私はそれが Opus 5.5 の最大の強みだと考えています。ただし、天井を常用することが強みなのではありません。medium で全673モデル中8位の位置を確保しておき、必要なときだけ同じ会話のまま xhigh や max へ移れる。この段差の使い方にこそ、契約の価値があります。
参考リンク
- Anthropic: Claude Opus 5.5
- Artificial Analysis
- Claude Docs: Effort
- OpenAI: Introducing GPT-6 Sol and Luna
- Claude Codeのeffort新オプション
- Claude Fable 5.1のeffort別カーブ
- Claude Opus 5とSolのeffort比較
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
META-MARK × AI
AI モデル選びの次は、動かす場所です。
エージェントや自作ツールを止めずに動かすなら、常時稼働できる置き場所が要ります。手元の GPU で動かす場合の必要スペックも確認できます。


関連記事
Sonnet 5.5 xhighは買いか、Claude Opus 5.5 mediumが得か
Claude Sonnet 5.5のeffort別実測と公式指針を整理。Sonnet 5からの破壊的変更、Opus 5.5との費用差、mediumの使いどころを解説します。

Claude Fable 5.2はLowでも旧版の最高点超え、費用は約3割|Opus+相談役よりLowで直接使う方が安かった
11月9日に出た Claude Fable 5.2 を、Artificial Analysis の指数と1問あたり費用で Fable 5.1・Opus 5.5 と比べました。Opus を本体に Fable を相談役(advisor)にする構成が得かどうかも、Anthropic の社内計測で確かめます。

effort を途中で変えるとキャッシュはどうなる? Fable 5.1 と Opus 5 で実測した
Fable 5.1 の値下げはキャッシュ読みだけ。Claude Code が TTL を決める仕組み、キャッシュを壊す操作と壊さない操作、effort 切替時の再書き込みを Fable 5.1 と Opus 5 の usage で実測しました。

Anthropicリーク2連発:Claude MythosとClaude Code流出で見えたKAIROS、BUDDY、Undercover Modeの正体
Anthropicの2週間で2回のリークを整理。Claude Mythosの位置づけ、Claude Code流出の中身、KAIROS/BUDDY/Undercover Modeの意味を分けて読む。
AI年表で詳しく見る
📅Claude Opus 5.5
Claude Opus 5.5——Fable 5.1 級の性能を Opus 5 より4割安く、既定 effort は medium