GPT-6.2 Astra は Fable 5.2 と2.5点差で1問あたり約6.6分の1|Sol は Medium で 6.1 の Xhigh に並び費用は約半分
11月17日に Artificial Analysis へ載った GPT-6.2 Astra と GPT-6.2 Sol を、指数・1問あたり費用・所要時間で GPT-6.1 Sol・GPT-6 Astra・Claude Fable 5.2・Opus 5.5・Sonnet 5.5・Gemini 4 Carbon と比べました。単価が同じでも費用が大きく違う理由と、effort の選び方を AA の図で整理します。

こんにちは。朝の空気がすっかり冬めいてきましたね。
11月17日、OpenAI の新しいモデル「GPT-6.2 Astra」と「GPT-6.2 Sol」が、第三者の評価サイト Artificial AnalysisArtificial Analysis主要な AI モデルを同じ問題で採点し、賢さ・速さ・値段を比べて公開しているサイト。詳しく →(以下 AA)に載りました。上位の Astra は、いちばん深く考える設定の Max で AA 指数 62.1点・91モデル中3位。1位の Claude Fable 5.2(Max)とは2.5点差まで迫りながら、1問あたりの費用は約6.6分の1、1問を解く時間は約4分の1でした。
普段使い向けの Sol も、前の GPT-6.1 Sol から同じ設定どうしで2.7〜6.4点上がり、Max では1問の所要時間が23.1分から7.9分に縮んでいます。6.2 Sol の Medium は、6.1 Sol の Xhigh とほぼ同じ点数を約半分の費用で出します。数字は AA に揃え、AA の図もそのまま載せながら、どの設定を何に使うかまで見ていきます。
Astra は AA で3位、1位の Fable 5.2 とは2.5点差
まず全体の中での位置です。AA の総合指数(いくつもの評価をまとめた賢さの点数・v5.0.1)で、GPT-6.2 の2モデルと、前の世代・Claude・GeminiGeminiGoogle の AI モデルの系統。詳しく → の上位を並べた AA の図です。
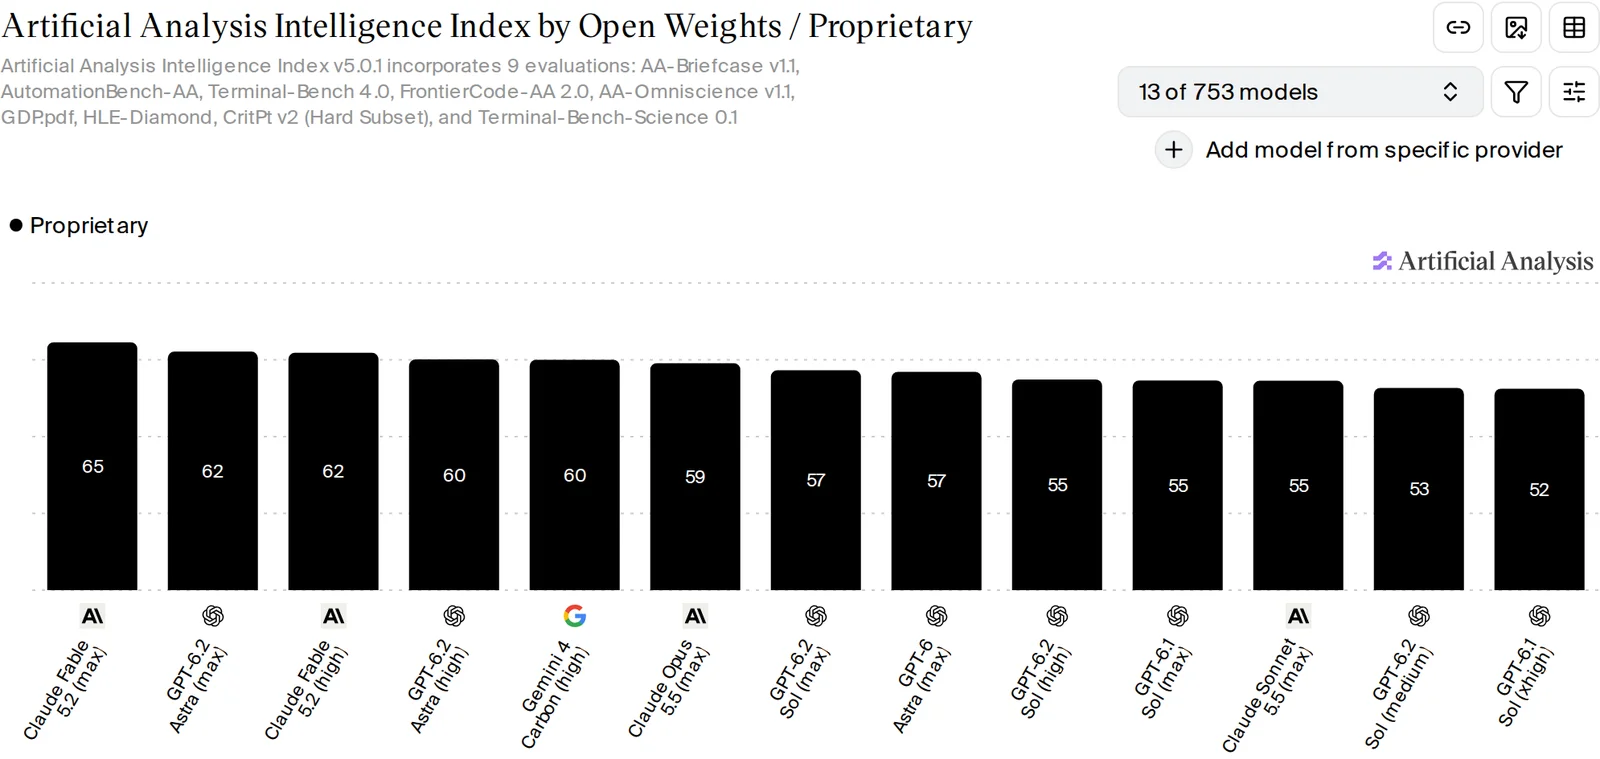 AA 指数 v5.0.1(整数表示)。GPT-6.2 Astra (max) は Fable 5.2 (max) の次、GPT-6.2 Sol (max) は GPT-6 Astra (max) と同じ57(出典 https://artificialanalysis.ai/ 、2026-11-18 取得)
小数まで出した値と、1問あたりの費用・時間です。
| モデル(effort) | AA 指数 | 1問あたり費用 | 1問の所要時間 |
|---|---|---|---|
| Claude Fable 5.2 (Max) | 64.6 | $26.54 | 40.8分 |
| GPT-6.2 Astra (Max) | 62.1 | $4.00 | 10.4分 |
| Claude Fable 5.2 (High) | 61.8 | $9.08 | 14.6分 |
| GPT-6.2 Astra (Xhigh) | 61.6 | $2.52 | 5.9分 |
| GPT-6.2 Astra (High) | 60.1 | $2.07 | 4.8分 |
| Gemini 4 Carbon (High) | 60.0 | $5.48 | 33.4分 |
| Claude Opus 5.5 (Max) | 59.1 | $10.04 | 24.6分 |
| GPT-6.2 Sol (Max) | 57.3 | $1.01 | 7.9分 |
| GPT-6.2 Astra (Medium) | 57.0 | $1.62 | 3.7分 |
| GPT-6 Astra (Max) | 56.9 | $6.24 | 20.4分 |
| GPT-6.2 Sol (Xhigh) | 55.7 | $0.65 | 5.1分 |
| GPT-6.2 Sol (High) | 54.9 | $0.56 | 4.3分 |
| GPT-6.1 Sol (Max) | 54.6 | $1.27 | 23.1分 |
| Claude Sonnet 5.5 (Max) | 54.5 | $10.02 | 32.3分 |
| GPT-6.2 Sol (Medium) | 52.7 | $0.41 | 3.1分 |
| GPT-6.1 Sol (Xhigh) | 52.5 | $0.76 | 9.7分 |
出典: Artificial Analysis(2026年11月18日取得・指数 v5.0.1)。efforteffortAI にどれだけ考えさせるかの段階設定。上げるほど賢く、遅く、高くなる。詳しく → は AI にどれだけ考えさせるかの設定です。
最上位との差を、1位の Fable 5.2(Max・64.6点)を100%として見ると、Astra の Max は約96%で、費用は約6.6分の1、時間は約4分の1。Sol の Max は約89%で、費用は約26分の1、時間は約5分の1です。Sol の Medium まで下げても約82%を保ち、費用は約65分の1になります。「最高点の9割前後を、桁違いに安く」というのが 6.2 の立ち位置です。
なお今回出た GPT-6.2 は、この Astra と Sol の2モデルだけです。Terra や Luna の 6.2 版はまだ出ていません。
単価は Fable 5.2 と同じ。違いは「書く量」だった
賢さと費用の釣り合いは、AA の散布図がいちばん分かりやすいです。左上(安くて賢い)ほど良い位置です。
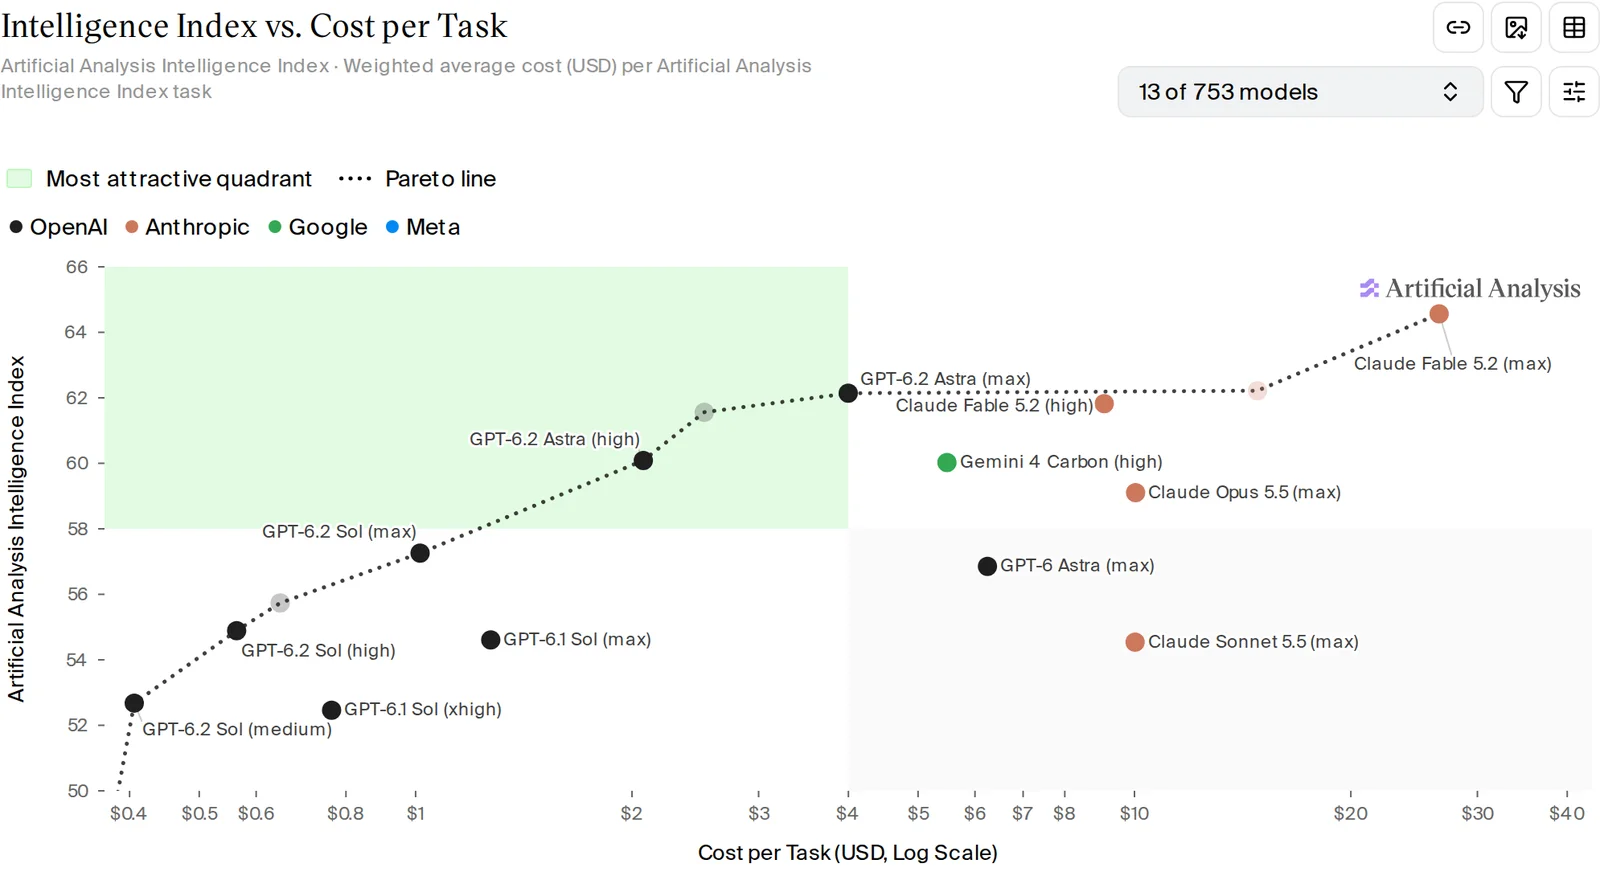 点線はパレート線(その費用で届く最高点を結んだ線)。GPT-6.2 Sol の Medium から Astra の Max までが線の上に乗り、Claude Fable 5.2 (max) だけが右上の端で線をつくる。薄い色の点は図に選んでいないモデル(出典 https://artificialanalysis.ai/ 、2026-11-18 取得)
GPT-6.2 の点は、Sol の Medium($0.41)から Astra の Max($4.00)まで、点線(その費用で届く最高点の線)の上に並んでいます。Claude と Gemini の点はどれも右側、つまり同じ点数ならより高くつく位置にあります。
面白いのは、Astra の単価が Fable 5.2 とまったく同じ(100万トークントークンAI が文章を読み書きする時の、文字を細かく区切った単位。料金もこの数で決まる。詳しく →あたり入力 $8・出力 $40)だということです。それでも1問あたりの費用は約6.6分の1。差を生んでいるのは書く量でした。
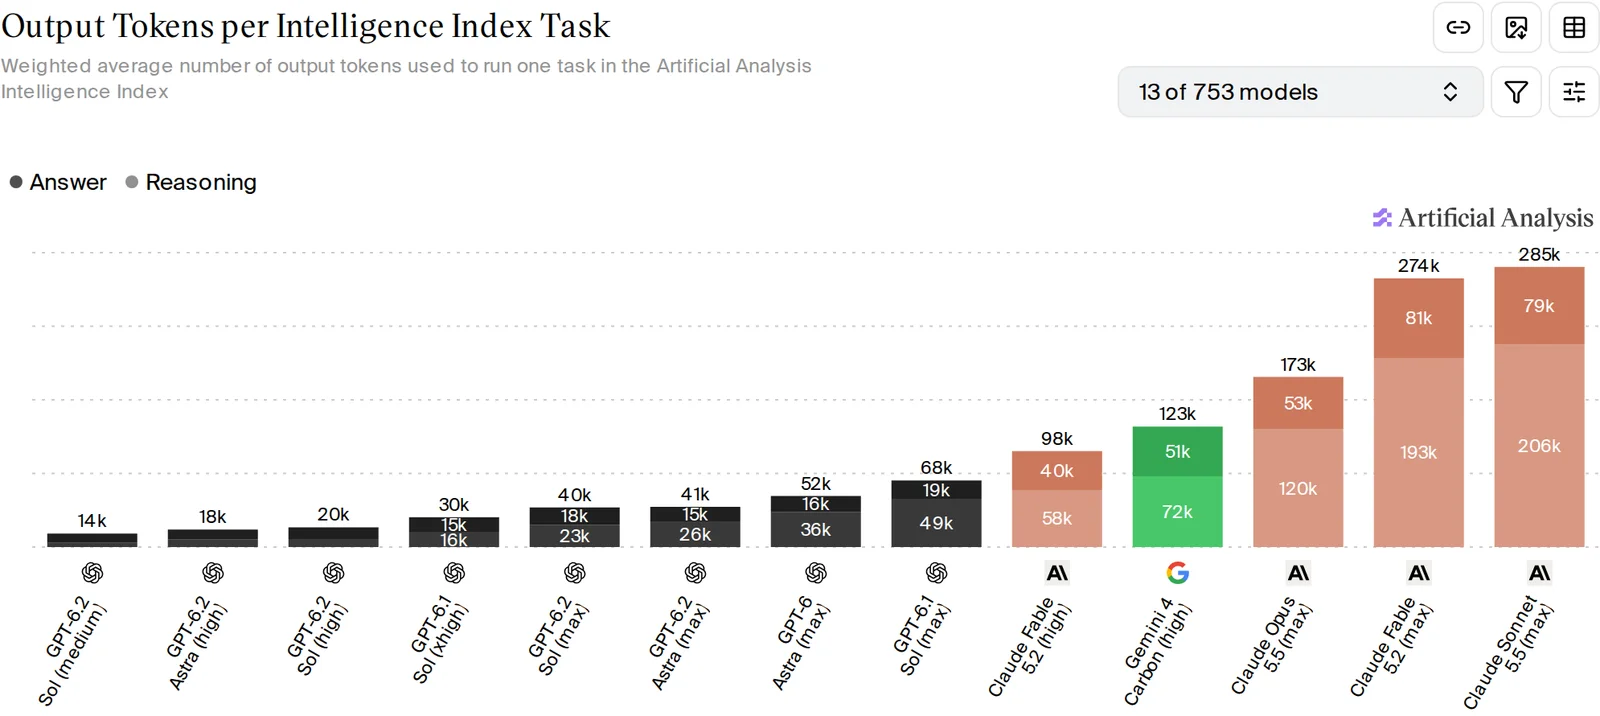 1問を解くのに書いた出力トークン。濃い部分が答え、淡い部分が考える文章。GPT-6.2 Astra (max) は41k、Claude Fable 5.2 (max) は274k(出典 https://artificialanalysis.ai/ 、2026-11-18 取得)
推論モデル(答える前に頭の中で考える文章を書くモデル)は、その考える文章にも出力の料金がかかります。1問あたりに書いた量は、Astra の Max が4万1000トークン、Fable 5.2 の Max が27万4000トークンで、約6.7倍。単価が同じなので、この比がほぼそのまま費用の差(約6.6倍)になっています。Sonnet 5.5 の Max(28万5000トークン)と、ほぼ同点の Sol の High(2万トークン)では約14倍です。AA も Sol の Max を「かなり簡潔」、Claude 3モデルと Gemini 4 Carbon を「とても冗長」と分類しています。
速く書けても、たくさん書けば待たされる
書く量は時間にも効きます。
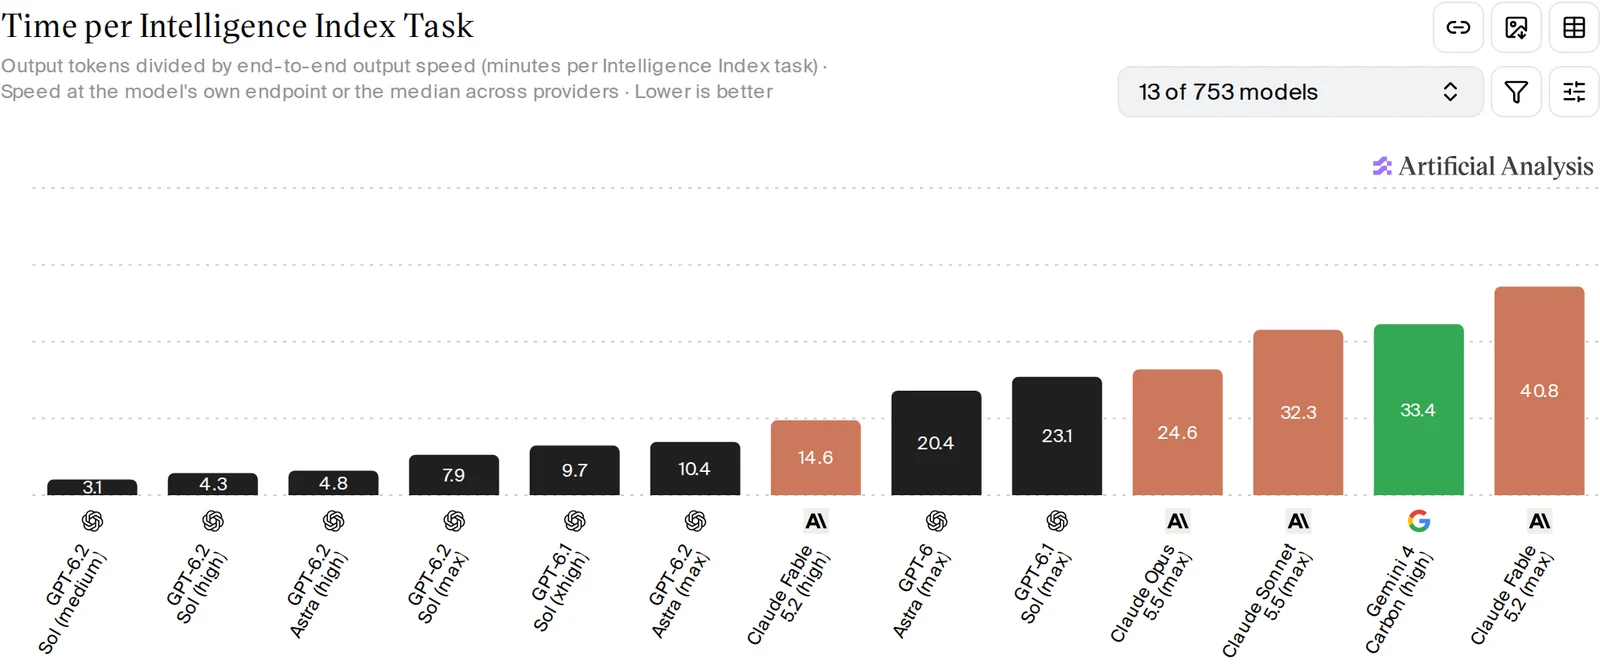 1問を解き終えるまでの分数。黒が OpenAI、茶色が Anthropic、緑が Google。GPT-6.2 の5本はすべて Claude Fable 5.2 (high) の14.6分より短い(出典 https://artificialanalysis.ai/ 、2026-11-18 取得)
出力の速さだけを見ると、Claude 勢は毎秒106〜147トークンで、GPT-6.2 の毎秒60〜85トークンより速く書きます。それでも1問の所要時間は GPT-6.2 の方がずっと短い。AA の所要時間は「1問あたりの出力量 ÷ 速さ」で、たとえば Fable 5.2 の Max は27万4000トークンを毎秒112トークンで書くので40.8分、Astra の Max は4万1000トークンを毎秒66トークンで10.4分です。カタログの「毎秒○トークン」で速いモデルを選ぶと、ここで読み違えます。
Sol は 6.1 から「同じ費用で賢く、ずっと速く」
次は前の世代との比較です。GPT-6.1 Sol と GPT-6.2 Sol の5つの設定を、同じ散布図に置きました。
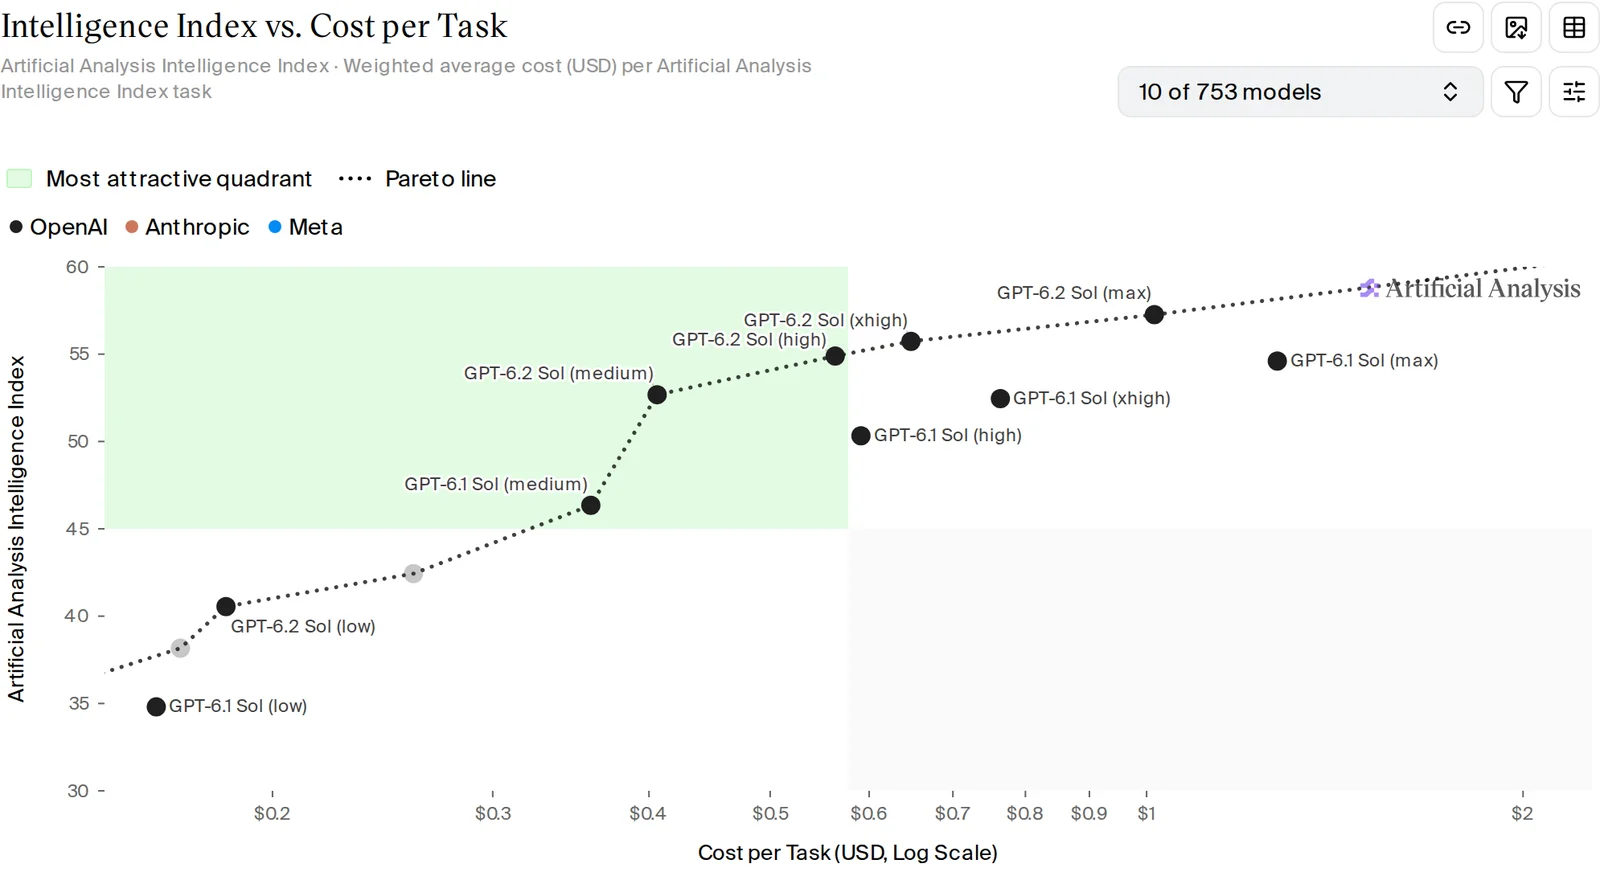 縦軸が AA 指数、横軸が1問あたり費用。GPT-6.2 Sol の5点が上の点線に並び、GPT-6.1 Sol の Max・Xhigh・High は右下に外れる。GPT-6.2 Sol (medium) が GPT-6.1 Sol (xhigh) より左上にある(出典 https://artificialanalysis.ai/ 、2026-11-18 取得)
| effort | 指数(6.1 → 6.2) | 1問あたり費用 | 1問の所要時間 |
|---|---|---|---|
| Max | 54.6 → 57.3(+2.7) | $1.27 → $1.01 | 23.1分 → 7.9分 |
| Xhigh | 52.5 → 55.7(+3.2) | $0.76 → $0.65 | 9.7分 → 5.1分 |
| High | 50.3 → 54.9(+4.6) | $0.59 → $0.56 | 7.4分 → 4.3分 |
| Medium | 46.3 → 52.7(+6.4) | $0.36 → $0.41 | 4.3分 → 3.1分 |
| Low | 34.8 → 40.6(+5.8) | $0.16 → $0.18 | 1.9分 → 1.4分 |
単価は 6.1 と同じ(入力 $2・出力 $10)です。そのうえで全部の設定で点が上がり、Max・Xhigh・High は1問あたりの費用まで下がりました。Medium と Low は費用が約1.1倍に増えますが、点の上がり幅はこの2つがいちばん大きいです。
いちばん変わったのは時間です。Max は23.1分から7.9分へ、約3分の1になりました。1問あたりに書く量が6万8000トークンから4万トークンへ約6割に減り、出力の速さも毎秒49から85トークンに上がった、その掛け算です。AA も 6.1 Sol の Max を「1問あたりは目立って遅い」と評していましたが、6.2 Sol の Max は「平均より速い」に変わっています。
設定をまたいで見ると、もっと分かりやすくなります。
- 6.2 Sol の Medium(52.7点)≒ 6.1 Sol の Xhigh(52.5点): 費用は約半分($0.41 と $0.76)、時間は約3分の1(3.1分と9.7分)。
- 6.2 Sol の High(54.9点)≒ 6.1 Sol の Max(54.6点): 費用は約44%($0.56 と $1.27)、時間は約5分の1(4.3分と23.1分)。
6.1 Sol を Xhigh や Max で使っていた人は、6.2 では設定を一段か二段下げても同じ点数が出る、ということです。
Astra は2割値下げで、全段の費用が約半分〜7割に
Astra は 6.1 版が無いので、前の GPT-6 Astra(9月3日)と比べます。
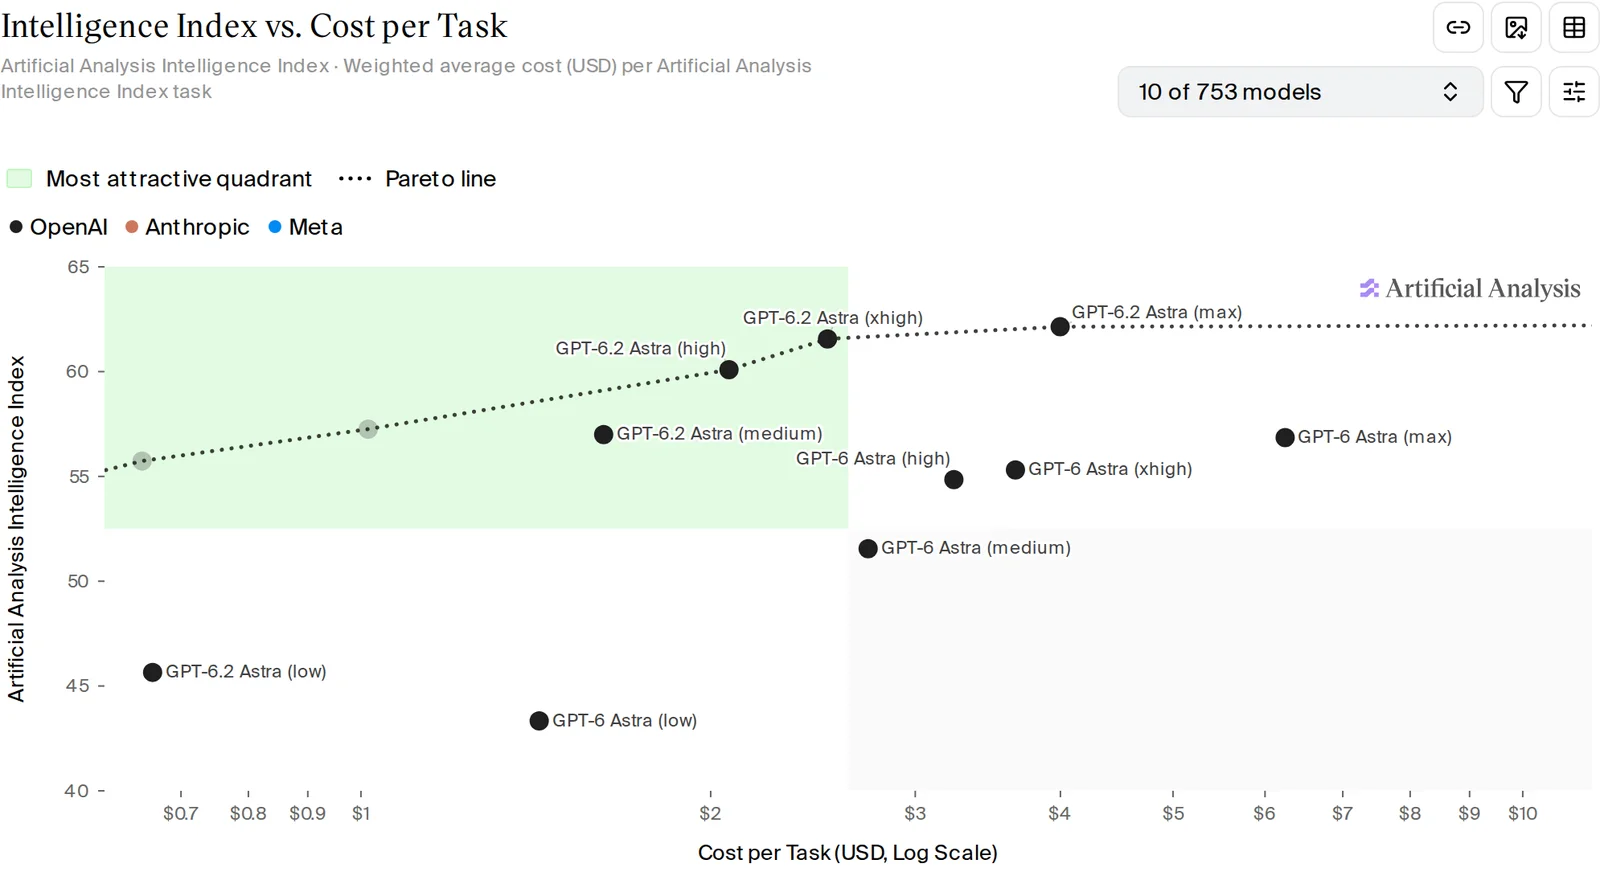 縦軸が AA 指数、横軸が1問あたり費用。GPT-6.2 Astra の Max・Xhigh・High が点線の上に並び、GPT-6 Astra の5点は右下に残る(出典 https://artificialanalysis.ai/ 、2026-11-18 取得)
| effort | 指数(6 → 6.2) | 1問あたり費用 | 1問の所要時間 |
|---|---|---|---|
| Max | 56.9 → 62.1(+5.2) | $6.24 → $4.00 | 20.4分 → 10.4分 |
| Xhigh | 55.3 → 61.6(+6.3) | $3.66 → $2.52 | 10.8分 → 5.9分 |
| High | 54.8 → 60.1(+5.3) | $3.24 → $2.07 | 9.0分 → 4.8分 |
| Medium | 51.6 → 57.0(+5.4) | $2.73 → $1.62 | 6.6分 → 3.7分 |
| Low | 43.3 → 45.7(+2.4) | $1.42 → $0.66 | 3.4分 → 1.4分 |
単価は入力 $10・出力 $50 から $8・$40 へ、2割下がりました。Low 以外は5点以上上がり、費用は約6〜7割、時間はほぼ半分です。キャッシュ済み入力(前に送った文章の使い回し)も $1 から $0.40 になっています。
ひとつ象徴的なのは、6.2 Sol の Max(57.3点)が、前の世代の最上位 GPT-6 Astra の Max(56.9点)を約6分の1の費用で上回ったことです。2か月半前の「いちばん賢い OpenAI」が、今は普段使い向けの値段で手に入ります。
Claude・Gemini と同じ点数どうしで比べる
料金と賢さの釣り合いを、点数がほぼ同じ組で並べ直しました。
| 点数帯 | GPT-6.2 | 相手 |
|---|---|---|
| 約62点 | Astra (Xhigh) 61.6点・$2.52・5.9分 | Claude Fable 5.2 (High) 61.8点・$9.08・14.6分 |
| 約60点 | Astra (High) 60.1点・$2.07・4.8分 | Gemini 4 Carbon (High) 60.0点・$5.48・33.4分 |
| 約57点 | Sol (Max) 57.3点・$1.01・7.9分 | Claude Opus 5.5 (Xhigh) 57.4点・$6.05・15.8分 |
| 約55点 | Sol (High) 54.9点・$0.56・4.3分 | Claude Sonnet 5.5 (Max) 54.5点・$10.02・32.3分 |
出典: Artificial Analysis(数字は AA 指数・1問あたり費用・1問の所要時間)
どの点数帯でも、GPT-6.2 が安くて速い側です。費用は Fable 5.2 の約28%、Gemini 4 Carbon の約38%、Opus 5.5 の約6分の1、Sonnet 5.5 の約18分の1。時間も Carbon と比べると約7分の1、Sonnet と比べると約7.5分の1です。
ただし AA の指数は、事務作業・自動化・コーディング・知識などを混ぜた総合点です。特定の作業、たとえば日本語の文章でも同じ順位になるとは限りません。総合点で同じくらいなら、まずは費用と時間で候補を絞り、最後は自分の作業で確かめる、という順番が無駄がありません。
effort は Astra なら Xhigh、Sol なら Medium〜High が釣り合う
それぞれの中で設定を比べると、上の段ほど割高になるのは同じです。
| effort | Astra(指数・費用・時間) | Sol(指数・費用・時間) |
|---|---|---|
| Max | 62.1点・$4.00・10.4分 | 57.3点・$1.01・7.9分 |
| Xhigh | 61.6点・$2.52・5.9分 | 55.7点・$0.65・5.1分 |
| High | 60.1点・$2.07・4.8分 | 54.9点・$0.56・4.3分 |
| Medium | 57.0点・$1.62・3.7分 | 52.7点・$0.41・3.1分 |
| Low | 45.7点・$0.66・1.4分 | 40.6点・$0.18・1.4分 |
Astra は、Xhigh が Max より0.5点下がるだけで、費用は約6割、時間は約57%に収まります。最上位に近い点が要るなら Xhigh、少し譲れるなら High(Xhigh より1.5点下で費用は約8割)がちょうどよい位置です。
Sol は、Medium から High の間が釣り合いのよいところです。Medium は High より2.2点下で、費用は約7割。どちらも Low へ下げると10点以上落ちるので、Low は「とにかく速く・安く」が要る作業向けです。
迷いやすいのが Astra の Medium(57.0点)と Sol の Max(57.3点)で、ほぼ同点です。費用は Sol の Max が安く($1.01 と $1.62)、時間は Astra の Medium が短い(3.7分と7.9分)。安さを取るなら Sol、待ち時間を取るなら Astra、と分けられます。
替えるとよい人、今のままでよい人
ここまでの数字を、今の使い方ごとにまとめます。
6.2 を試す価値が大きい人
- GPT-6.1 Sol を使っている人: 同じ設定で点が上がり、Max・Xhigh・High は費用も下がります。設定を一段下げても同じ点が出ます。
- GPT-6 Astra を使っている人: 全段で点が上がり、費用は約半分〜7割、時間はほぼ半分です。
- Claude Opus 5.5・Sonnet 5.5 を費用や待ち時間で見直したい人: 同じ点数の Sol は、費用が約6分の1〜18分の1です。
- Gemini 4 Carbon(High)を使っている人: Astra の High で同点、費用は約38%、時間は約7分の1です。
今のままでよい人
- いちばん高い点が要る作業: 1位は Claude Fable 5.2(Max)のままで、Astra の Max とは2.5点の差があります。
- 音声や動画を入力したい人: GPT-6.2 の入力は文章と画像だけです。Gemini 4 Carbon は音声・動画も受け付けます。
- 今のモデルが自分の作業にぴったり合っている人: AA は総合点なので、その作業での順位までは分かりません。
切り替える前に確かめたいこと
- 自分の作業で数十件比べる: AA の数字は評価の平均です。同じ入力を今のモデルと 6.2 に流し、正答と出力トークン数を見てください。
- Max から始めない: Astra は Xhigh、Sol は Medium か High から比べ、足りない作業だけ上げる方が無駄がありません。
- キャッシュを使えるか: キャッシュ済み入力は Astra が $0.40、Sol が $0.10 で、どちらも割引95%です。同じ前置きを何度も送る使い方なら、入力の費用はかなり下がります。
- 文脈の長さ: どちらも100万トークンまで入ります。重み(モデル本体)は公開されていないので、手元の PC では動かせません。
管理人はこう使い分けます
私は Claude CodeClaude CodeAnthropic が出している、AI にコードを書かせて実行まで任せる開発ツール。詳しく → から別のモデルへ作業を任せる仕組み(委託)を使っていて、その先の一つが OpenAI の CodexCodexOpenAI が出している、AI にコードを書かせて実行まで任せる開発ツール。詳しく →(コーディング用の道具)です。11月18日、その委託先を GPT-6.2 に切り替えました。設計や調査の相談役は GPT-6.1 Sol(Xhigh)から GPT-6.2 Astra(Xhigh)へ、実装役は GPT-6.1 Terra(Xhigh)から GPT-6.2 Sol(Medium)へ。手元の Codex CLI を新しい版(0.169.1)に更新したら、6.2 を選べるようになりました。
AA の数字で見ると、実装役の切り替えは分かりやすい得です。GPT-6.1 Terra(Xhigh)の45.3点・$0.40・6.5分に対して、GPT-6.2 Sol(Medium)は52.7点・$0.41・3.1分。1問あたりの費用はほぼ同じまま、点は7.4点上がり、時間は半分以下になります。相談役のほうは9.1点上がる代わりに費用が約3.3倍になりますが、時間は約6割に縮みます。
まだ切り替えたばかりで、6.1 との差を自分の作業で比べたわけではありません。この記事の数字はすべて AA の公開データです。
数字を並べていちばん驚いたのは、Astra と Fable 5.2 の単価がまったく同じなのに、1問あたりでは6倍以上の差がつくことでした。決め手はやはり書く量で、前の Gemini 4 Hydrogen の記事で見たことが、今度は Claude 側で起きています。GPT-6.2 は「最高点のすぐ下を、少なく書いて安く・速く出す」モデルです。委託先として使ってみての差は、これから自分の作業で確かめていきます。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
META-MARK × AI
AI モデル選びの次は、動かす場所です。
エージェントや自作ツールを止めずに動かすなら、常時稼働できる置き場所が要ります。手元の GPU で動かす場合の必要スペックも確認できます。


関連記事

Claude Fable 5.2はLowでも旧版の最高点超え、費用は約3割|Opus+相談役よりLowで直接使う方が安かった
11月9日に出た Claude Fable 5.2 を、Artificial Analysis の指数と1問あたり費用で Fable 5.1・Opus 5.5 と比べました。Opus を本体に Fable を相談役(advisor)にする構成が得かどうかも、Anthropic の社内計測で確かめます。
GPT-6.1 Solをeffort別実測:medium 47.8、Astraとの差はどこまで縮むか
GPT-6.1 SolをDevDay 2026の発表とArtificial Analysisのeffort別実測で検証。旧Sol・Astraとの性能、費用、待ち時間から使い分けを判断します。
GPT-6.1 Terra、Codex の実装役で Sol と同じ全問合格。時間は25%短く費用は半分
10月26日に出たGPT-6.1 Terraを、Codexでコードを書く実装役としてSol mediumと24回比べました。過去のバグ4つで全員8/8合格、Terra mediumは平均120秒・API換算$0.13。AAの指数では同じmediumで6.5点差があり、使い分けの線も整理します。

GPT-5.6 Luna xhigh: 知能49・タスク単価$0.04・待ち時間40秒、安い理由まで実測
2026年7月30日の80%値下げ後、通常セッションのモデルをLunaに切り替えるべきか。OpenAI公式発表と第三者ベンチの実測データ(Intelligence Index、TTFT、タスク単価)から、API従量とCodex定額それぞれの判断材料を整理します。