Claude Code で Opus 5.5 に Fable 5.2 の相談役を付けたら、バグは直らず費用は約2.9倍になった
公式の既定どおり effort medium の Opus 5.5 を本体にし、相談役(advisor)に Fable 5.2 を付けて、自作クレーンゲームの物理バグ2問を各3回解かせました。合格は6回中0回で、費用は Opus 単独の約2.9倍。品質も費用も悪くなった実測を、ゲーム画面の再現つきでまとめます。
こんにちは。朝晩の冷え込みが、いよいよ冬らしくなってきましたね。
Claude CodeClaude CodeAnthropic が出している、AI にコードを書かせて実行まで任せる開発ツール。詳しく → で、Opus 5.5 を公式の既定どおり efforteffortAI にどれだけ考えさせるかの段階設定。上げるほど賢く、遅く、高くなる。詳しく → medium のまま本体にし、上位モデルの Fable 5.2 を「相談役」に付けて、自作ゲームの物理バグを直させました。狙いは、Opus の安さのまま Fable の賢さを借りることです。ところが結果は、本体だけのときよりバグが直らず、費用も上がるという、いちばん残念な形で終わりました。
課題は2問、各条件6回だけなので、差は「傾向」として読んでください。この記事では、ゲームの画面を再現しながら「バグは直せたか」「費用は安くなったか」を順に確かめ、最後に、詰まったときにどうするのがよかったかをまとめます。
相談役(advisor)とは何か、なぜ試したか
Claude Code には、作業する本体のモデルとは別に、ときどき意見を聞く「相談役」のモデルを付ける機能があります(英語では advisor。設定名は advisorModel)。本体が迷ったところで相談役を呼び、相談役は会話を読んで助言を返します。公式ドキュメント(advisor の説明)も、速い本体と強い相談役の組み合わせは、強いモデルを最初から最後まで走らせるより安く済むことが多い、と説明しています。
わたしは自作のクレーンゲームを、普段は Fable 5.2 の effort low で開発しています。Fable 5.2 の単価は Opus 5.5 のちょうど2倍です(Artificial Analysis のモデルページ)。公開されている点数と単価で比べたFable 5.2 の記事では、Opus+相談役より Fable を low で直接使う方が安いという結果でした。それでも、実際の作業なら相談役の方が得になるかもしれない。それを自分の課題で確かめたのが、今回の実験です。
題材は自作のクレーンゲーム
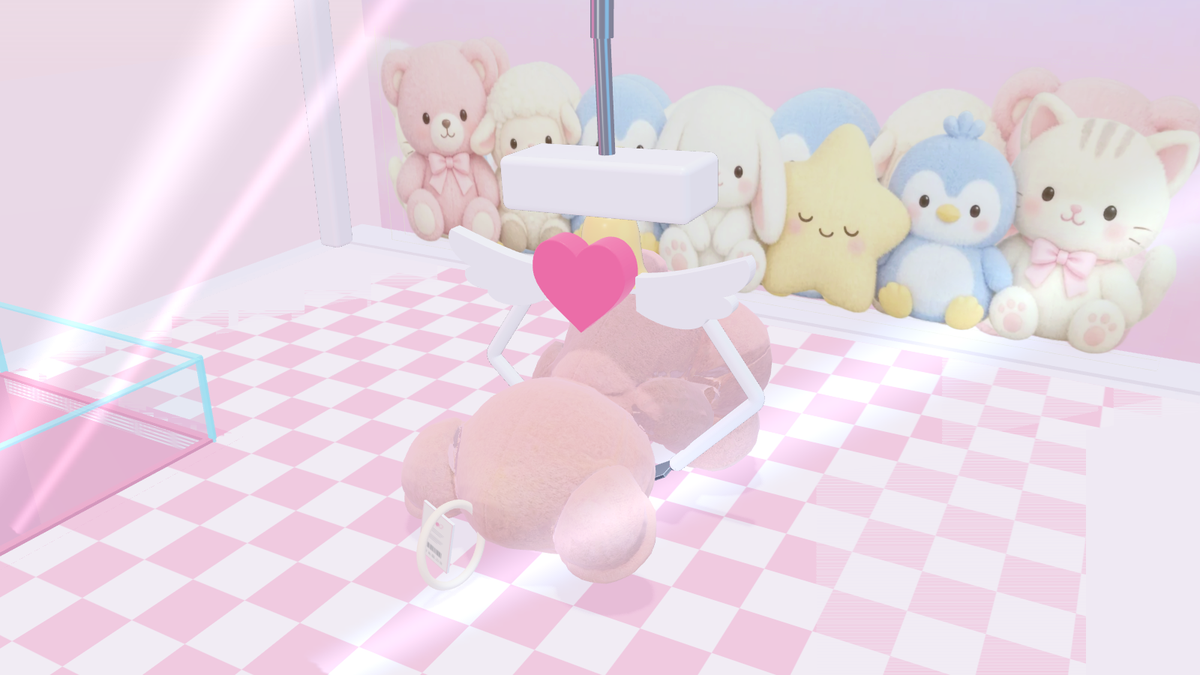
ゲームの画面。うつ伏せに寝かせたクマを爪が挟んだところ(実測と同じ試行を再現して撮影)。
題材にしたのは、ブラウザで動くクレーンゲームです。物理エンジン(重さや摩擦を計算する部品)で、景品・爪・爪を吊る軸を本気で動かしています。見た目だけの演出で結果を決めていないので、物理の設定が少しずれると、現実ではありえない動きになります。今回の2問は、どちらもその種類のバグです。
記事の画像は、実験と同じ試行を、ゲームの実際の3D描画で再現して撮ったものです。物理は実測と同じ手順・同じ乱数の種で進め、知りたい瞬間で止めて描画しました。作画や合成ではありません。
比べたのは次の3通りです。
- A: Opus 5.5・effort medium(相談役なし)。medium は Opus 5.5 の既定の設定です。
- B: Opus 5.5・effort medium+相談役に Fable 5.2
- C: Fable 5.2・effort low(相談役なし・わたしの普段の設定)
Claude Code 2.1.323 の claude -p(途中で人が答えない無人実行)で走らせ、使える道具はファイルの読み書き・検索・コマンド実行だけにしました。下請けの AI を呼ぶ機能と Web 検索は禁止です。1回ごとの費用の上限は $20、時間の上限は課題1が60分、課題2が90分。3通りを同時に1回ずつ走らせ、それを3回繰り返しました。2問で合計18回です。
バグは直せたか → 相談役付きは0回(×)
| 条件 | 課題1 | 課題2 | 合計 |
|---|---|---|---|
| A Opus 5.5 medium | 1/3 | 1/3 | 2/6 |
| B Opus medium+相談役 Fable 5.2 | 0/3 | 0/3 | 0/6 |
| C Fable 5.2 low | 1/3 | 2/3 | 3/6 |
相談役を付けた B だけが、一度も合格しませんでした。本体だけの A より下がっています。相談役を付けたことで、品質はむしろ落ちました。
課題1: 強く握るほど、箱が爪から抜け落ちる
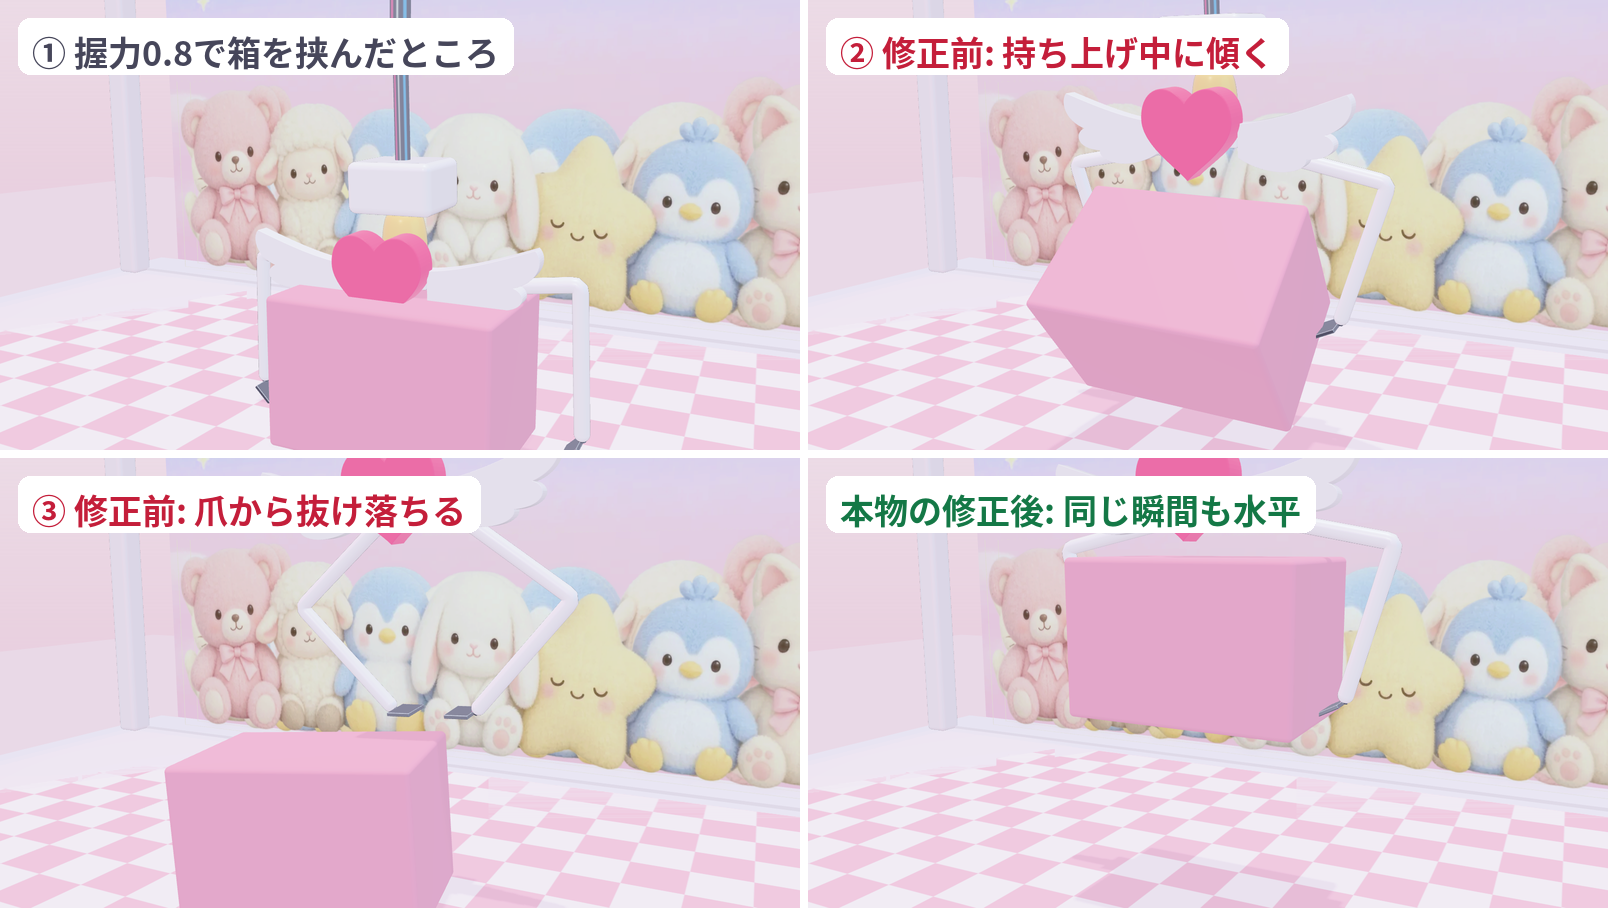
同じ試行の比較。修正前は持ち上げ中に箱が傾き、爪から抜け落ちる。本物の修正後は同じ瞬間でも水平のまま持ち上がり、獲れる。
握力を上げると、獲得率がかえって下がる区間がありました(握力0.6で93%、0.8で77%)。画像のとおり、しっかり挟んだはずの箱が、持ち上げる途中でじわじわ傾いて抜け落ちます。これは以前に一度直した不具合で、直す前の版を、履歴を消した写しで渡しています。
本物の修正は、設定1行でした。物理エンジンが1回の小さな計算の中で、接触と摩擦の力を「解き直す」回数を、既定の1回から4回にしたのです。少ないと、強く挟んだ景品の摩擦が解き切れず、止まっているはずの面がじわじわ滑ります。
採点には、この修正と一緒に足した試験2本を使いました。「握力を上げるほど獲得数は減らない」「強く挟んだ景品は持ち上げ中に爪からずり落ちない」の2本で、AI は見ていません。作業が終わった後に上書きして走らせ、2本とも通れば合格です。
不合格の7回の多くは、同じ見立てに落ち着きました。「爪を吊る軸が伸び縮みしない棒なので、握る力が頭を押して傾け、景品の中心を外して挟んでいる」というものです。筋は通っていて、実物のクレーンも軸は伸縮します。相談役付きの3回は、3回ともこの直し方でした。
合格した2回は違う道を通りました。Opus 単独の3回目は「接触の解き直し4回」を足して、本物の修正とほぼ同じところに着きました。Fable の3回目は、軸の伸縮に加えて左右の爪をつなぐばねを握力に比例させ、本物とは別の直し方で試験2本を通しています。
ただ、不合格だった側の報告にも目を向けてください。不合格の7回も、全部が自分の計測では「直った」と書いていたのです。 相談役付きの1回目は「握力0.8で獲得率97〜99%」と書いてきましたが、見ていない試験は1本落ちました。
課題2: 寝かせたクマが、落ちる途中で「札」だけ取り残される
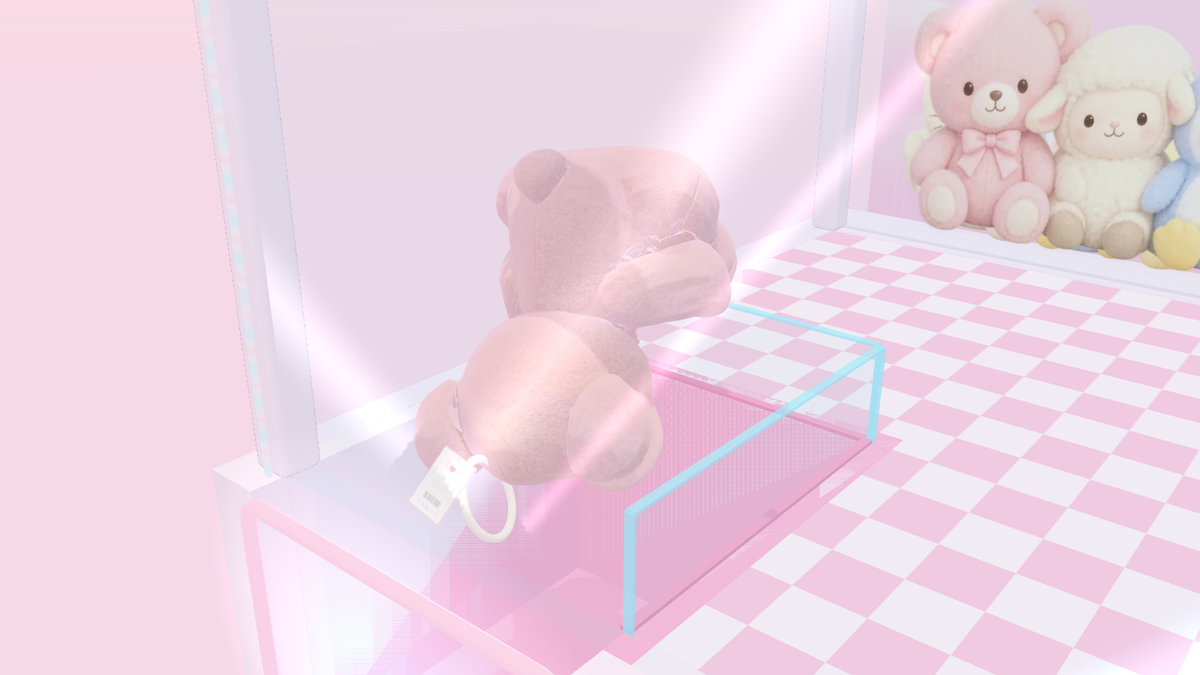
獲れたクマが落とし口へ落ちていく瞬間。このあと、頭に付いた札が壁に当たる。
ぬいぐるみ景品のクマを寝かせて置くと、部位をつなぐ関節が最大12.7mm離れ、手足や頭が一瞬伸びて見えました。獲得率をなるべく変えずに、これを5mm未満にするのが課題です。こちらは出題した時点で、わたしも答えを知りませんでした。
採点は、問題文と別の乱数の種で測りました。うつ伏せ・仰向け・座りの3姿勢×握力3段×各48回です。うつ伏せと仰向けの最大の離れが全部5mm未満で、獲得率が修正前とほぼ同じなら合格にしました。
報告を残した6回(打ち切り以外)は、全部が本当の原因を当てています。離れていたのは手足や頭ではなく、頭に付いた下げ札(タグ)とその輪でした。獲れたクマが落とし口へ落ちる途中、軽い札が壁や縁に当たった1刻み(1/240秒)だけ止められ、重い本体は落ち続けるので継ぎ目が開いていたのです。
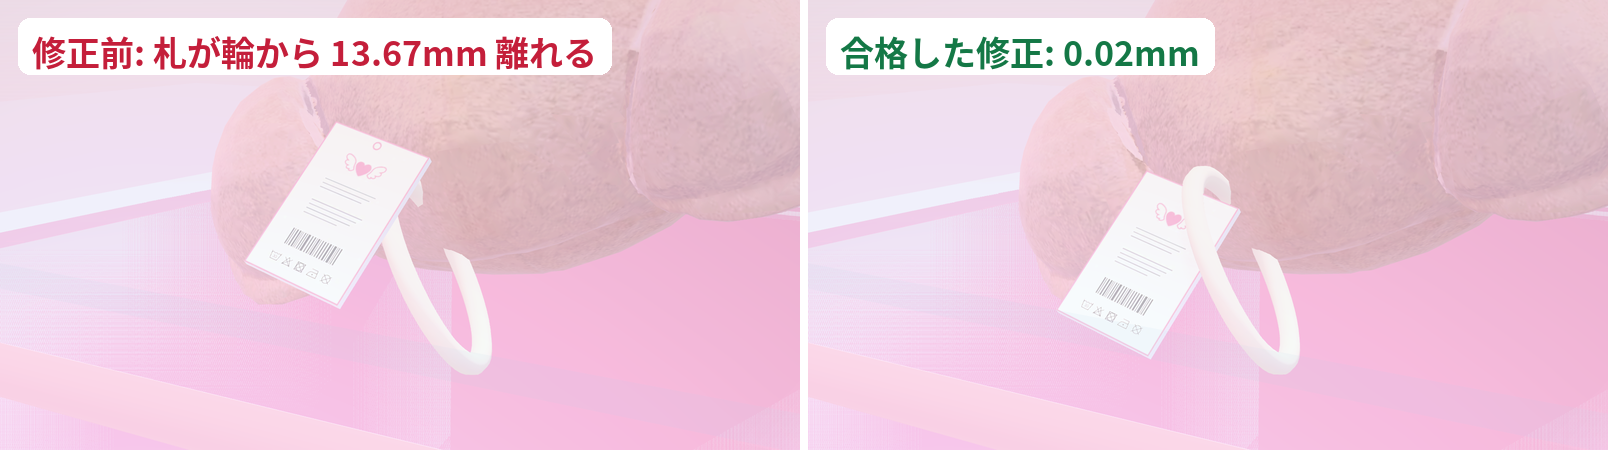
同じ試行・同じ瞬間の拡大。左が修正前(札が輪から外れて 13.67mm 離れる)、右が合格した修正(Fable 5.2 low の3回目・0.02mm)。
差が付いたのは、直し方と確かめ方でした。合格した3回のうち、Opus 単独の1回目は衝突の先読み(すり抜け防止)の計算を1刻みに2回へ分け、最大1.66mmに。Fable の2回は、1刻みごとに離れた関節を引き戻す補正を入れ、3.0mmと1mm未満に抑えました。
一方、Opus 単独の2回目と Fable の2回目は、すり抜け防止の解き直しを増やす方向で止まりました。Opus は自分の計測で「うつ伏せ1.7mm・仰向け3.9mm」と報告しましたが、別の種で測るとうつ伏せ9.3mmで不合格でした。この2回は、採点の数字まで同じでした。
相談役付きは、もっと手前でつまずきました。1回目は「離れているのは札で、手足と頭は0.3mm未満」と原因を正しく突き止めたのに、試した4つの案がどれも5mmを割らなかったとして、全部元に戻して断念しています。2回目と3回目は90分の上限で打ち切りです。2回目は途中の変更が残っていて、仰向けの離れがかえって13.0mmに増えていました。
費用は安くなったか → 約2.9倍に増えた(×)
| 条件 | 課題1(3回・ドル) | 課題2(3回・ドル) | 平均 |
|---|---|---|---|
| A Opus medium | 1.98 / 1.05 / 2.15 | 4.78 / 2.09 / 4.51 | $2.76 |
| B +相談役 Fable | 6.70 / 5.38 / 7.64 | 11.06 / 10.89 / 6.11 | $7.96 |
| C Fable low | 3.23 / 3.55 / 4.87 | 3.56 / 5.12 / 4.93 | $4.21 |
1回あたりの費用は、Claude Code が結果に書く金額です。打ち切りの3回は結果が出ないので、作業記録のトークントークンAI が文章を読み書きする時の、文字を細かく区切った単位。料金もこの数で決まる。詳しく →数(AI が読み書きした量)に APIAPIプログラムから別のサービスの機能を呼び出すための窓口。AI モデルでは、アプリを通さずに自分のプログラムから直接使う入り口を指す。詳しく → の単価を掛けて数えました。同じ数え方を完了した15回に当てると、記録の金額と1セント未満まで一致しています。
相談役付きは1回あたり平均 $7.96 で、Opus 単独($2.76)の約2.9倍でした。安くするつもりで付けた相談役で、Fable を本体にした場合($4.21)よりも約1.9倍高くなっています。ただ、ここで比べた Fable は effort low なので、公式の「強いモデルを最初から最後まで」とは前提が少し違います。
相談役付きの費用 $47.78 のうち、相談役(Fable 5.2)の分は $26.60 で、全体の約56%でした。呼んだのは6回の合計で21回、1回の作業で2〜5回です。回数のわりに高いのは、相談役が呼ばれるたびに会話全体を読み直し、その読み込みにはキャッシュ(前に読んだ分の割引)が効かないからです。公式ドキュメントにもそう書かれていて、今回の記録でも Fable 側のキャッシュ読み取りは0でした。課題2の1回目は、相談役5回で入力が約55万トークンに達しています。
合格1回あたりで見ると、また違う姿が見えます。Opus 単独は6回の合計 $16.56 で2回合格なので約 $8.3、Fable low は $25.26 で3回合格なので約 $8.4 と、ほぼ同じでした。1回が安い Opus は外れも多く、1回が高めの Fable は当たりが多い。相談役付きは合格0回なので、この計算すらできません。
かかった時間は、3回ずつ同時に走らせて手元のパソコンが混んでいたので、あくまで参考値です。課題1は Opus 単独が15〜24分、相談役付きが36〜54分、Fable が13〜44分。課題2は Opus 単独が40〜90分、相談役付きが70分と打ち切り2回、Fable が35〜50分でした。
相談役が何を言ったのかは、読めなかった
相談役が失敗の原因だったのか、本体が助言を生かせなかったのか。そこを確かめたかったのですが、助言の本文は作業記録の中で暗号化されていて読めませんでした。分かるのは、21回の呼び出しのうち18回は助言が返り、3回は相談役の処理時間の上限で失敗した、ということまでです。
以前(2026年7月)は、Fable を相談役にすると、道具を1回でも使った後の呼び出しがほぼ必ず失敗する既知の不具合がありました。今回はそれは起きていません。少なくとも「相談役が黙っていたから負けた」わけではなさそうです。
最終結論: 詰まったら、相談役より先に本体を替える
バグは直せたか、は×。費用は安くなったか、も×。Opus 5.5 medium に Fable 5.2 の相談役を付けた組み合わせは、この2問では、品質と費用の両方で本体だけの構成に負けました。
この2問から言えるのは、次の3つです。
- Opus で詰まったら、相談役を足す前に、本体を Fable(effort low)にして試す。 この2問では、そちらの方が安く、当たりも多くありました。
- 相談役は、呼ぶたびに会話全体を割引なしで読み直す。 作業が長くなるほど1回の相談が高くなります。長い調べものの途中で何度も呼ぶ使い方は、費用が膨らみやすいです。
- どの設定でも、AI の「直った」は自分で確かめる。 今回は課題1の不合格7回すべてと、課題2の2回が、自分の計測で直ったと報告しました。AI が見ていない試験か、別の条件で測り直すのがいちばん確かです。
もちろん、課題は2問、各6回だけです。相談役が得意な課題の形(たとえば方針を決める場面が多い作業)もあるはずで、今回それを測れたわけではありません。それでも、「上位モデルを相談役に付ければ、本体を上げるより安く同じ結果になる」とは、少なくとも物理のバグ探しでは言えませんでした。普段どおり Fable 5.2 の effort low で作っていた判断は、結果的にいちばん釣り合いのよい選択でした。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
META-MARK × AI
AI モデル選びの次は、動かす場所です。
エージェントや自作ツールを止めずに動かすなら、常時稼働できる置き場所が要ります。手元の GPU で動かす場合の必要スペックも確認できます。


関連記事
Claude Code advisorを同一課題で実測:effort連動は約1.3倍だった
Claude Code の advisor はメインの effort を引き継ぐのか、xhigh 固定なのか。公式ドキュメントの確認、実ログ2,483回の集計、同じモデルを effort 別に直接動かした物差しとの対照実験40回で、advisor の思考量を推定しました。

effort を途中で変えるとキャッシュはどうなる? Fable 5.1 と Opus 5 で実測した
Fable 5.1 の値下げはキャッシュ読みだけ。Claude Code が TTL を決める仕組み、キャッシュを壊す操作と壊さない操作、effort 切替時の再書き込みを Fable 5.1 と Opus 5 の usage で実測しました。
Sonnet 5.5 xhighは買いか、Claude Opus 5.5 mediumが得か
Claude Sonnet 5.5のeffort別実測と公式指針を整理。Sonnet 5からの破壊的変更、Opus 5.5との費用差、mediumの使いどころを解説します。

Anthropicリーク2連発:Claude MythosとClaude Code流出で見えたKAIROS、BUDDY、Undercover Modeの正体
Anthropicの2週間で2回のリークを整理。Claude Mythosの位置づけ、Claude Code流出の中身、KAIROS/BUDDY/Undercover Modeの意味を分けて読む。