Claude Code advisorを同一課題で実測:effort連動は約1.3倍だった
Claude Code の advisor はメインの effort を引き継ぐのか、xhigh 固定なのか。公式ドキュメントの確認、実ログ2,483回の集計、同じモデルを effort 別に直接動かした物差しとの対照実験40回で、advisor の思考量を推定しました。
こんにちは。秋の夜長は、気になっていたことをじっくり確かめるのにちょうどいいですね。今回は、Claude Code の advisor(作業の要所で、より強いモデルに相談できる機能)が、どのくらい深く考えているのかを測った話です。
私が引っかかっていたのは、メインの effort(AI にどれだけ考えさせるかの設定)を low や medium に下げたら、相談役の advisor まで浅くなるのか、それとも Plan 用のサブエージェントのように xhigh のような深い設定で固定されているのか、という点でした。測ってみると、答えはそのどちらでもありませんでした。advisor の effort を個別に決める方法はなく、選べるのはモデルだけです。そのうえで、advisor はメインの effort に少しだけ引きずられ、low から xhigh に上げると出力は約1.3倍になりました。同じモデルを直接動かしたときの約3.7倍と比べると、ごく弱い連動です。考える量は、直接動かしたときの medium〜high 相当でした。メインを xhigh にしても、advisor が xhigh 並みに考えることはありません。
公式ドキュメントにも検索にも答えが無かったので、実ログ2,483回の集計と、条件をそろえた実験の二段構えで確かめました。途中で一度、実ログだけを見て「まったく連動しない」と結論しかけています。なぜそう見えたのかも含めて、順に書いていきます。
advisor で選べるのはモデルだけ
advisor は、メインのモデルが作業の要所で「より強いモデル」に相談する仕組みです。公式ドキュメントでは、方針を決める前・同じエラーが続いたとき・完了を宣言する前などに呼ばれると説明されています。advisor は会話の全体(ツールの呼び出しと結果を含む)を読み、助言だけを返します。advisor が考えた中身はメイン側に渡る前に捨てられ、届くのは助言の文章だけです。
設定は3通りあり、どれもモデルを選ぶためのものです。
/advisorコマンド(セッション中に切り替え。既定値として保存される)- 設定ファイルの
advisorModel(例:"advisorModel": "opus") - 起動オプション
--advisor <モデル>(そのセッションだけ)
公式ドキュメントには、引き継ぐとも固定とも書いていない
Claude Code の advisor のページと、その土台になっている Claude API の advisor tool のページを、effort・thinking・inherit などの語で読み込みました。
| 項目 | 記載 |
|---|---|
advisor のモデル選択(advisorModel / /advisor / --advisor) | あり |
| advisor 専用の effort 設定キー | なし |
| advisor の effort を変える環境変数 | なし(advisor を丸ごと無効化する CLAUDE_CODE_DISABLE_ADVISOR_TOOL だけ) |
| API の advisor tool の設定項目 | model・max_uses・max_tokens(思考込みの出力上限)・caching など。effort は無い |
| effort と advisor の組み合わせ | 「Sonnet の executor(メイン側)を medium にして Opus を advisor にすると…」というメイン側の effort の話だけ |
| advisor の出力量の目安 | 「本文 400〜700 トークン、思考込みで 1,400〜1,800 トークン程度」 |
メインの effort は effortLevel や modelSettings で設定できますが、これはメインモデルのための設定で、advisor に効くとはどこにも書かれていません。引き継ぐのか、固定なのか、どちらの記述も見当たりませんでした。メイン側の effort の段階(low〜max)そのものは、Claude Code の新effortモード徹底解説で整理しています。
検索でも、同じ疑問に答えたものは見つかりませんでした。見つかったのは主に3種類です。effort 全般の解説記事は、low〜max の違いやモデルごとの保存方法が中心で、advisor にはほとんど触れていません。GitHub の Issue には「/effort や /advisor の選択がそのまま既定値として保存されてしまう」「特定の組み合わせで advisor が unavailable になる」といった要望や不具合の報告はありましたが、effort を継承するかを確かめたものはありませんでした。
いちばん紛らわしかったのは、「frontmatter に effort: xhigh と書けば advisor もその深さになる」という要約です。これはサブエージェント(.claude/agents/*.md で定義する委託先)の仕組みで、advisor とは別物です。Plan 用などのサブエージェントを xhigh にしていても、それが advisor に効くという根拠はありません。一次情報が無い以上、自分で測るしかありませんでした。
実ログを集計すると「連動しない」ように見えた
Claude Code は会話の記録を JSONL 形式(1行に1件ずつ書く記録の形式)でローカルに保存しています。advisor を呼ぶと、その応答の usage.iterations[] に type: "advisor_message" という項目が増え、advisor のモデル名と入出力トークン数が記録されます。同じ行には、そのターンのメインの effort(perTurnEffort)も残っています。
私の約1か月分(2026-08-28〜09-28)のログから advisor の呼び出し 2,483 回を抜き出し、メインの effort 別に advisor の出力トークン数(思考込み)の中央値を出しました。
| advisor のモデル | メインの effort | 回数 | advisor 出力の中央値 |
|---|---|---|---|
| Fable 5.1 | low | 314 | 6,108 |
| Fable 5.1 | medium | 1,377 | 4,487 |
| Fable 5.1 | high | 40 | 5,545 |
| Opus 5 | low | 344 | 4,863 |
| Opus 5 | high | 5 | 8,353 |
| Opus 5 | xhigh | 56 | 3,789 |
| Opus 5.5 | medium | 347 | 6,745 |
比べるために同じログのメインモデル(Fable 5.1)を見ると、low 493 → high 857 と effort に応じてはっきり増えていました。ところが advisor は、むしろ low がいちばん多いくらいで、effort に沿った増減が見えません。
ここで一度「advisor はメインの effort とは連動しない」と結論しかけました。でも、この集計は毎回ちがう作業・ちがう長さの会話をまとめて比べているものです。相談の中身によって advisor の考える量は大きく変わるので、30% 程度の差なら簡単に埋もれてしまいます。high や xhigh のデータは数セッション分しかありません。実ログの数字だけで判断するのは早いと思い直して、条件をそろえて測り直しました。
条件をそろえると、advisor は弱く連動していた
同じ課題を、物差しと advisor の両方に解かせる
やり方は3段階です。
- 同じ課題を用意する。 架空の作業記録を1つ作りました(月末だけ売上集計がずれるバグの調査途中で、直し方が2案あって迷っている、という内容)。
- 物差しを作る。 advisor と同じ Opus 5.5 を、
claude -p --effort <値>で low / medium / high / xhigh / max の5段階で直接動かしました。「助言役として、この作業記録に次の方針を助言してください」と頼み、各5回ずつ出力トークン数と思考トークン数を記録しました。この回は advisor を無効にしています。 - advisor を測る。 メインも Opus 5.5 にし、advisor に Opus 5.5 を付けて、メインの effort を low / high / xhigh に切り替えました。「答える前に必ず advisor に一度相談して」と指示して各5回実行し、
advisor_messageの出力トークン数を記録しました。advisor に渡る入力はどの回も約23,000トークンで、ほぼ同じです。
low から xhigh で、advisor の出力は約1.3倍
| メインの effort | advisor 出力(5回) | 中央値 |
|---|---|---|
| low | 1,244 / 1,306 / 1,622 / 1,866 / 1,989 | 1,622 |
| high | 1,564 / 1,740 / 1,771 / 1,864 / 2,498 | 1,771 |
| xhigh | 2,025 / 2,061 / 2,102 / 2,513 / 2,808 | 2,102 |
low と high はほとんど重なっていますが、xhigh の5回はすべて low の5回より多くなりました(並べ替え検定で片側 p≈0.024。偶然でこれだけ分かれる確率はかなり低い、という意味です)。メインの effort は、advisor にもある程度は伝わっていると考えるのが自然です。
ただ、その幅は小さなものでした。物差し側(同じモデルを直接動かした場合)は low → xhigh で出力が約3.7倍になったのに対し、advisor は約1.3倍です。実ログで差が埋もれて見えたのも、この弱さなら無理はないと思います。
考える量は medium〜high 相当で、xhigh 固定ではない
物差し側の結果はこうなりました。
| effort | 出力の中央値 | うち思考 | うち本文 |
|---|---|---|---|
| low | 1,231 | 351 | 945 |
| medium | 1,715 | 780 | 948 |
| high | 2,248 | 1,172 | 1,110 |
| xhigh | 4,602 | 3,481 | 1,235 |
| max | 28,682 | 27,384 | 1,379 |
advisor は短く助言するよう作られているので、出力の合計をそのまま比べると不公平です。そこで思考の量で比べることにしました。advisor の思考トークンは記録に出ないため、「advisor の出力 − 助言本文」で逆算しています。助言本文は、公式の目安(400〜700トークン)と、物差し側の本文と同じくらい(約950トークン)の両方を仮定しました。
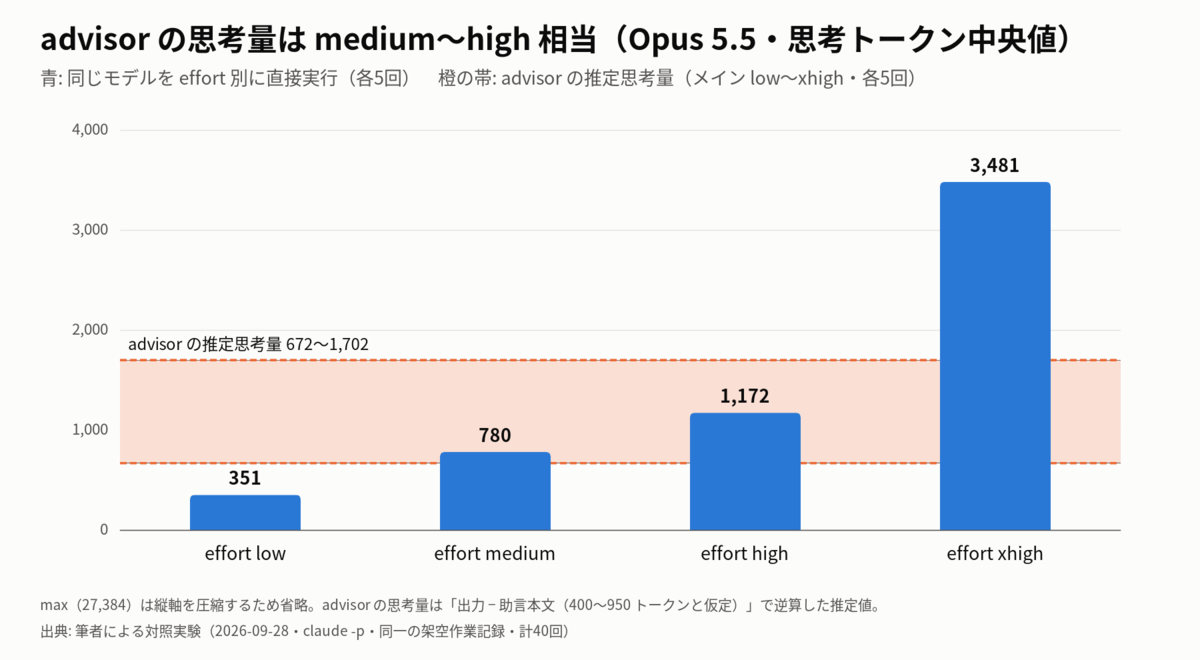
逆算した advisor の思考量は、どの仮定・どのメイン effort でも 672〜1,702 トークンに収まりました。物差しの medium(780)〜 high(1,172)のあたりで、上限でも xhigh(3,481)の半分に届きません。max(27,384)とは桁が違います。
「advisor は xhigh 固定では」という私の予想は、少なくともこの実験では外れました。Plan 用のサブエージェントを xhigh にしていても、advisor はそれとは別の、もっと控えめな深さで考えているようです。
この実験で断定できないこと
結果を使う前に、言い切れない点も置いておきます。
- advisor が内部でどの effort 値を使っているかは断定できません。advisor には専用の指示文があり、物差しとまったく同じ条件にはならないからです。
- 実験は1つの課題・1つのモデル(Opus 5.5)・各5回だけです。Fable など他のモデルや、長い実作業の会話では違う結果になるかもしれません。
- advisor は実験的な機能なので、今後の更新で挙動が変わる可能性があります。
実務では、メインの effort はコストと速さで決めてよい
ここまでの結果を、普段の設定に落とすとこうなります。
- メインの effort は、コストと速さで決めてよい。 メインを下げると advisor も少し控えめになりますが、その差は小さいものです。
- advisor に xhigh 並みの深さは期待しない。 advisor は要所で方針を確かめる相談役です。本当に深く考えさせたい設計判断は、effort を上げたメインか、xhigh のサブエージェントに任せるほうが確実です。
- advisor を強くしたいときは、モデルを変える。 確実に効く指定は
/advisorやadvisorModelでのモデル選択だけです。 - サブエージェントの effort と混同しない。
effort: xhighはサブエージェント定義の話で、advisor には効きません。 - ログの集計だけで判断しない。 実運用ログは条件がばらばらなので、小さな差は見えなくなります。確かめたいときは、同じ課題で条件をそろえて比べるのが近道です。
この結果が役に立つのは、メインの effort を下げてコストを抑えつつ、要所の確認だけは強いモデルに任せたい人です。「advisor は xhigh で考えているはず」と思い込んで設定を組んでいた人も、一度見直してみてください。逆に、短い作業が中心の人はあまり気にしなくて大丈夫です。公式ドキュメントも、計画することが少ない短い作業では advisor の効果は小さいとしています。毎ターン最も深い思考が要る作業をしている人も、advisor に頼るより、メインのモデルや effort を上げるほうが確実です。
自分の環境で確かめる手順
今回の実験は、claude -p(画面を開かずにコマンド1行で動かす非対話モード)だけで再現できます。自分の使い方でも同じになるか確かめたいときは、次の順で試してみてください。
- 物差しを取る。 advisor を切った状態で、同じ課題を effort だけ変えて直接実行します。環境変数
CLAUDE_CODE_DISABLE_ADVISOR_TOOL=1を付けると、advisor を確実に外せます。例:claude -p --effort high "(課題文)" - advisor を測る。 同じ課題に「答える前に必ず advisor に一度相談して」と書き添え、
--advisor opusを付けて、メインの effort だけを変えて実行します。advisor を呼ぶかどうかはモデルが決めるので、相談を明示的に頼むのがこつです。例:claude -p --effort low --advisor opus "(課題文)" - 記録を読む。 Claude Code がローカルに保存する会話記録(JSONL)で、
usage.iterations[]のうちtype: "advisor_message"の項目を探し、その出力トークン数を比べます。 - 条件をそろえる。 課題文・モデル・回数(今回は各5回)を固定し、変えるのは effort だけにします。1回ずつのばらつきが大きいので、中央値で比べるのがおすすめです。
advisor の深さを変えたいなら、effort をいじるより、モデルを選び直すのが確実な道です。
出典
- Escalate hard decisions with the advisor tool - Claude Code Docs
- Advisor tool - Claude Platform Docs
- Effort - Claude Platform Docs
- anthropics/claude-code Issue #78329(
/effortと/advisorの選択が既定値として保存される件)
検証日・環境
- 検証日: 2026-09-28
- Claude Code v2.1.283(Linux)
- 実ログ集計: 筆者の Claude Code 実ログ(2026-08-28〜2026-09-28)・advisor 呼び出し 2,483 回(Fable 5.1 / Opus 5 / Opus 5.5)
- 対照実験:
claude -p・メイン Opus 5.5・advisor Opus 5.5・同一の架空作業記録・物差し25回+advisor 15回(ネットワークエラーと advisor の混入で取り直した分を除く)
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
META-MARK × AI
AI モデル選びの次は、動かす場所です。
エージェントや自作ツールを止めずに動かすなら、常時稼働できる置き場所が要ります。手元の GPU で動かす場合の必要スペックも確認できます。


関連記事
Claude Codeを週間枠到達後に実測:advisorは日別73〜105回動いた
最上位モデルの週間枠が尽きた後、メインを一段下げて advisor だけ最上位に残す構成を、セッションログの日別集計で検証した実測記録。

effort を途中で変えるとキャッシュはどうなる? Fable 5.1 と Opus 5 で実測した
Fable 5.1 の値下げはキャッシュ読みだけ。Claude Code が TTL を決める仕組み、キャッシュを壊す操作と壊さない操作、effort 切替時の再書き込みを Fable 5.1 と Opus 5 の usage で実測しました。

Fable 5.1 は『low で旧 max 超え』なのか|公式グラフ5枚をベンチ別に正直に読む
Claude Fable 5.1 の公式グラフ5枚をベンチ別に読み、low が旧 Fable 5 の max を超えたベンチと超えなかったベンチを表にしました。常用 effort の決め方と Pro/Max の課金条件も整理します。

Claude Fable 5.2はLowでも旧版の最高点超え、費用は約3割|Opus+相談役よりLowで直接使う方が安かった
11月9日に出た Claude Fable 5.2 を、Artificial Analysis の指数と1問あたり費用で Fable 5.1・Opus 5.5 と比べました。Opus を本体に Fable を相談役(advisor)にする構成が得かどうかも、Anthropic の社内計測で確かめます。