Claude Codeを週間枠到達後に実測:advisorは日別73〜105回動いた
最上位モデルの週間枠が尽きた後、メインを一段下げて advisor だけ最上位に残す構成を、セッションログの日別集計で検証した実測記録。
こんにちは。もうすぐ秋分の日、昼と夜の長さがそろう頃ですね。今回は逆に、同じモデルの呼び出しが片方だけ止まり、もう片方は止まらなかった話です。
週の半ばで、一番賢いモデルの週間枠が尽きました。そこで「メインは一段下げて、advisor だけ最上位モデルのまま残す」構成に組み替えたところ、これはかなり良い選択肢でした。最上位モデルのメイン利用は枠到達の翌日からゼロになったのに、同じモデルの advisor 呼び出しは日別 73〜105 回で止まらなかったのです。ただし、良い理由は多くの人が思っているのとは少し違うところにあって、そこを誤解したまま使うと後で痛い目を見ます。
Claude Code を本気で回していると、枠切れはわりと普通に起きます。困るのは、リセットまでの数日間です。素直に一段下のモデルへ落とすと、体感でわかるくらい判断が雑になる。かといって、その数日のために上位プランへ乗り換えるのも大袈裟です。本稿では最上位を Fable 5.1、一段下を Opus 5 として扱いますが、話の骨格はモデル名によらず同じです。effort(思考の深さ)を途中で変えたときのキャッシュの話は effort を途中で変えるとキャッシュはどうなる? Fable 5.1 と Opus 5 で実測した に書いたので、あわせて読むとつながりが見えやすいと思います。
測り方と、この記事で言えないこと
数字に入る前に、測り方を置いておきます。
- 検証日: 2026-09-16
- 環境: Linux 上の Claude Code v2.1.273、サブスクリプションプラン、advisor モデルを設定ファイルで常時指定(メインは Opus 5・思考の深さは中程度)
- 手法: ローカルのセッションログ(JSONL=1行に1件ずつ記録が並ぶ形式)を日別に集計し、応答データの usage 内の
iterations配列から advisor 呼び出しのモデル名とトークン数を抽出しました。使用率は公式の使用量取得経路から取得した値を前後で比較しています - 期間: 枠到達の前日から4日後までの計6日分
- 一次情報: 課金・キャッシュ・レート制限の記述は Claude Code 公式ドキュメントの advisor ページ を参照しました
これは単一環境・単一アカウントの観測(n=1)で、プラン種別や時期によって挙動は変わりえます。とくに「advisor 分が全体の利用上限に乗っているかどうか」は、実測では判別できませんでした。週間メーターは1%刻みで、1回の呼び出しでは検出限界を下回るためです。判別できなかったことを「乗っていない」と読み替えないでください。
advisor は「節目だけ相談する相手」
Claude Code の advisor(アドバイザー)は、メインのモデルが作業を進める裏で、節目だけ別の(より賢い)モデルに相談する機能です。設定で相談相手のモデルを指定しておくと、メインのモデルが「方針を決める前」「同じエラーで詰まった時」「完了を宣言する前」といったタイミングで自発的に呼び出します。
呼ぶかどうかを決めるのはメインのモデル自身です。人間が「ここで相談しろ」と指示することもできますが、既定では完全にモデル任せ。この性質が、後で効いてきます。
公式ドキュメントも、この機能の狙いを「速いメインモデルと強いアドバイザーを組み合わせたほうが、強いモデルを最初から最後まで走らせるより安く済むことが多い」と説明しています。今回の構成は、製品が想定している使い方そのもので、奇策ではありません。
枠が尽きても、advisor 経由の呼び出しは止まらなかった
手元のセッションログから、最上位モデルが「メインとして」呼ばれた回数と、「アドバイザーとして」呼ばれた回数を日別に数えました。
| 日 | メインとしての呼び出し | アドバイザーとしての呼び出し |
|---|---|---|
| 枠到達の前日 | 744 回 | 28 回 |
| 枠到達の当日 | 118 回 | 100 回 |
| 枠到達の翌日 | 0 回 | 73 回 |
| その2日後 | 0 回 | 85 回 |
| その3日後 | 0 回 | 105 回 |
| その4日後 | 0 回 | 99 回 |
きれいに分かれました。メインとしての利用は枠に到達した時点で完全に途絶し、一段下のモデルへ退避しています。ところがアドバイザーとしての呼び出しは一度も止まらず、到達前と同等以上の頻度で動き続けていました(呼び出しが多い日は、単にメインで長時間作業した日です)。
これは表示上の話ではありません。枠が満杯の状態で、サーバーが実際にその呼び出しを通したということです。アドバイザー経由の呼び出しは、そのモデル専用の週間枠のゲート(関所)を通っていない、と言えます。
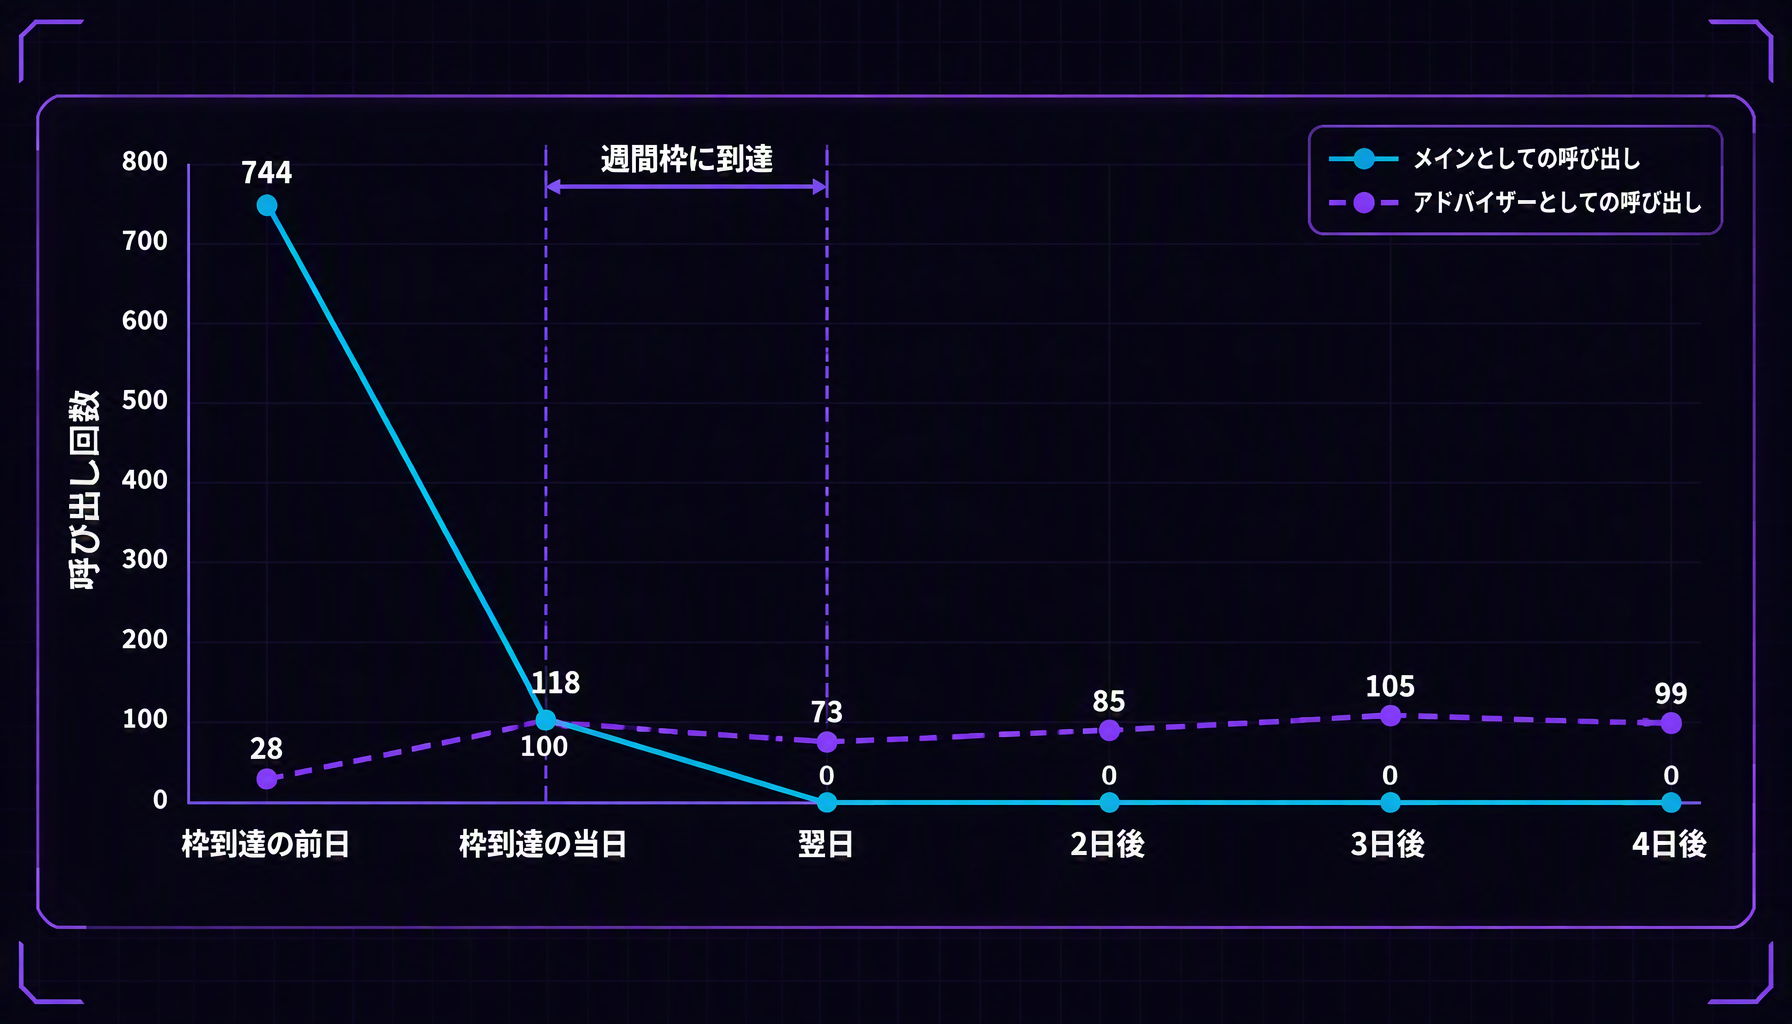
同じモデルなのに、片方だけが止まった。止まらなかったほうが advisor 経由
advisor のトークンは合計欄に出てこない
ついでに使用量の内訳も見たところ、アドバイザーのトークンは応答データの表向きの集計欄には現れず、一段深い場所にだけ記録されていました。日別表の6日分とは別に7日分で足すと、アドバイザー側の入力は1億トークンを超えているのに、その数字は表向きのどの欄にも合流していません。メイン側はキャッシュ読み込みとして別欄に数十億トークンが記録されているので、「メインが小さい」という意味ではなく、あくまでアドバイザー分がどこにも足されていないという話です。
使用量を自前で集計しているツールがあるなら、ここを読み落としている可能性が高いです。私のツールがまさにそれで、慌てて直しました。
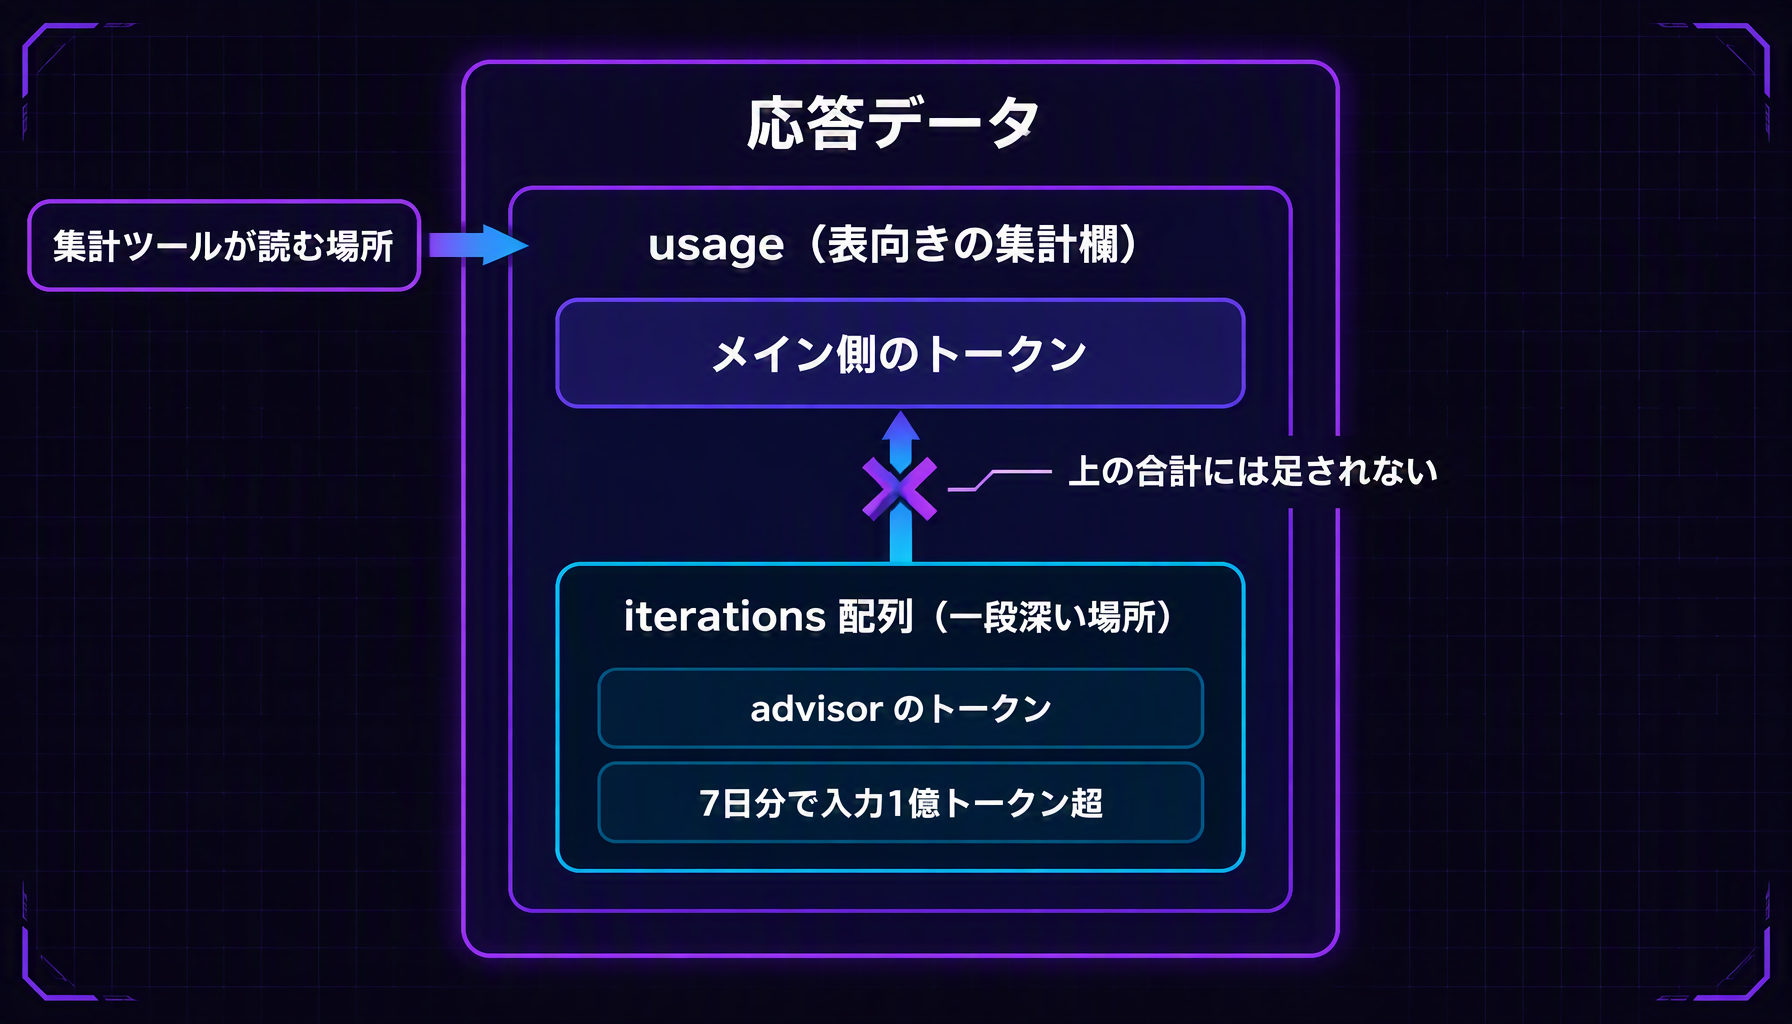
合計欄を読むだけの集計ツールは、advisor 分をまるごと取りこぼす
それでも「実質タダ」ではない
ここで「アドバイザーは枠外なんだから使い放題では?」と考えたくなります。私も一瞬そう思いました。でも、そう結論づけるのは危険です。
公式ドキュメントの課金セクションには、こう書いてあります。
Subscription plans: advisor usage counts toward your plan's usage limits, except that a Fable advisor bills to usage credits on plans where Fable usage does (サブスクリプションプランでは、アドバイザーの利用はプランの利用上限にカウントされる。ただし Fable をアドバイザーにした場合、Fable の利用がクレジット課金になるプランでは、アドバイザー分もクレジットに課金される)
後半の例外は、「Fable アドバイザーはクレジット課金だから、そもそも枠に乗らないのでは?」と読める箇所です。ただ、今回の環境にこの例外は当てはまらないと考えています。理由は2つあります。この環境の Fable は実際に週間メーターで管理されていた(だから枠に到達した)こと、そしてアカウント側のクレジットが無効・残高ゼロの状態だったことです。クレジットが使えない状態で、枠到達の翌日からの4日間だけでも362回の呼び出しが通っている以上、それがクレジットから引かれたとは考えにくい。例外ではなく一般則のほうが効いている、というのが私の読みです。ここはプラン区分についての推測で、ドキュメントに書いてある事実ではありません。
同じページには「アドバイザーの利用は /usage が表示するセッション合計にもカウントされる」とも明記されています。規定上は、カウントされるのが正しい挙動です。メーターに出ていないのは、表示の不具合である可能性が高い。実際、この食い違いを指摘した Issue が公式リポジトリに上がっていて、起票から10日ほど経った時点でまだ開発側からの回答はありません。
念のため自分でも測りました。8万トークンほどのアドバイザー呼び出しを1回挟んで前後の使用率を比べたところ、動いたのは1ポイント程度で、その分は自分の通常のやり取りで説明がつく範囲でした。週間側のメーターは動かず。ただしこれは判定できなかったというだけで、乗っていないことの証明にはなりません。週間メーターは1%刻みで、1回の呼び出しでは検出限界を下回ります。
現時点での正直な整理はこうです。そのモデル専用の枠のゲート外にあることは実証済み。全体の利用上限に乗っているかどうかは実測では判別不能で、公式が「乗る」と言っている以上、乗っている前提で運用するのが安全。
フル稼働の代わりにはならない理由が3つある
コストの話を脇に置いても、「メイン降格+アドバイザー据え置き」は最上位モデルをフルで回すのと同等にはなりません。
1つめ。アドバイザーはキャッシュが効きません。 公式ドキュメントにも「アドバイザー自身の読み込みはキャッシュされない。呼び出しのたびに会話全体を新規に処理し、呼び出し間での再利用はない」と明記されています。手元のログでも、キャッシュ読み込みは常にゼロでした。メイン側が巨大な文脈を1/10の割引価格で読み直しているのに対し、アドバイザーは毎回8万〜18万トークンを定価で送り直している。1回あたりの単価としては、むしろ最も高い経路です。
2つめ。呼ぶタイミングを決めるのはメインのモデルです。 一段下げたモデルが、賢い相談相手を「正しい場面で」呼んでくれるとは限りません。特に思考の深さを浅く設定している場合、確認を省いて記憶で答えてしまう傾向があります。強い相談相手を用意しても、呼ばれなければ意味がない。プロンプトで「進める前にアドバイザーに相談して」と明示的に頼めるので、重要な局面では言葉で促すほうが確実です。
3つめ。アドバイザーは見るだけで、手を動かしません。 会話の全履歴は読めますが、ツールを実行したりファイルを編集したりはできない。レビュアーであって、実装者ではありません。「設計の筋を正す」「見落としを指摘する」には効きますが、「難しい実装を最後までやり切る」用途では代わりになりません。
地味なところでは、アドバイザー側にも独立したレート制限(短時間に呼べる回数の上限)があります。混雑時には弾かれる呼び出しが実際に出ていました。無制限ではありません。
枠が尽きたときの組み方
実測を踏まえて、私の運用はこうなりました。
枠が尽きたら、メインを一段下げてアドバイザーは最上位のまま据え置く。 これは正しい判断です。製品が想定している使い方で、細工でもなんでもありません。枠切れ後の数日間、判断の要所だけ最上位の目が入るので、丸ごと降格させるのに比べて劣化がはっきり小さくなります。
ただし「枠外だからタダ」という前提で回数を増やすのはやめる。 規定上はカウントされることになっている以上、これは表示の不具合が直らないほうに賭ける行為です。直った日に、遡ってまとめて跳ね返ってきます。しかもアドバイザーは1回あたりが最も高い経路なので、増やした分の反動も大きい。
思考の深さの設定を確認する。 メインを下げるとき、モデルだけでなく思考の深さも一緒に下がっていないか見ておくといいです。私の環境では、メインの Opus 5 は中程度に設定されていました。なお、モデルごとの思考の深さの設定がアドバイザー呼び出し側にも及ぶかは、公式ドキュメントに記載が見当たりません。設定ファイルを開いて実際の値を確認してからでないと、「下げたつもりが二重に下がっていた」ということが起こります。
節目では言葉で相談を促す。 モデル任せにせず、「方針を決める前に相談して」と書くだけで、強い相談相手が実際に使われる確率が上がります。
枠切れは、しばらく付き合うことになる制約だと思います。上位プランへ飛びつく前に、この組み替えを一度試してみる価値はあります。
出典
- Claude Code 公式ドキュメント「Escalate hard decisions with the advisor tool」 — 課金・キャッシュ・モデル対応表の記述
- Claude Code 公式ドキュメント「Model configuration」 — モデル設定と Fable のクレジット課金
- Issue #92437「Fable used as the advisor does not appear on the Fable weekly usage meter (Max 5x)」 — 2026-09-06 起票。本稿執筆時点(2026-09-16)で open かつメンテナ未回答
検証日は 2026-09-16、Claude Code v2.1.273、サブスクリプションプラン、単一環境の観測(n=1)です。プラン種別や時期によって挙動が異なる可能性があります。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
META-MARK × AI
AI モデル選びの次は、動かす場所です。
エージェントや自作ツールを止めずに動かすなら、常時稼働できる置き場所が要ります。手元の GPU で動かす場合の必要スペックも確認できます。


関連記事

Anthropicリーク2連発:Claude MythosとClaude Code流出で見えたKAIROS、BUDDY、Undercover Modeの正体
Anthropicの2週間で2回のリークを整理。Claude Mythosの位置づけ、Claude Code流出の中身、KAIROS/BUDDY/Undercover Modeの意味を分けて読む。

Claude Fable 5 vs Sonnet 5:料金5倍・知能+7点の実測使い分けガイド
Fable 5とSonnet 5をArtificial Analysisの知能指数・タスク単価・出力量で比較。料金5倍の差を実務の判断材料に落とし込みます。

Claude Fable 5.2はLowでも旧版の最高点超え、費用は約3割|Opus+相談役よりLowで直接使う方が安かった
11月9日に出た Claude Fable 5.2 を、Artificial Analysis の指数と1問あたり費用で Fable 5.1・Opus 5.5 と比べました。Opus を本体に Fable を相談役(advisor)にする構成が得かどうかも、Anthropic の社内計測で確かめます。
Sonnet 5.5 xhighは買いか、Claude Opus 5.5 mediumが得か
Claude Sonnet 5.5のeffort別実測と公式指針を整理。Sonnet 5からの破壊的変更、Opus 5.5との費用差、mediumの使いどころを解説します。