Claude Fable 5 vs Sonnet 5:料金5倍・知能+7点の実測使い分けガイド
Fable 5とSonnet 5をArtificial Analysisの知能指数・タスク単価・出力量で比較。料金5倍の差を実務の判断材料に落とし込みます。
こんにちは。Claude の新しい名前がいくつも並んで、夏に向けてどれを手元の相棒にするか迷いやすい時期ですね。
Claude Fable 5 の入力・出力の単価は、Sonnet 5 のちょうど5倍です。値札だけ見ると Sonnet 5 はかなり妥協した廉価版に見えますが、Artificial Analysis(AI モデルを同じ試験で採点して公開している第三者のサイト)の実測では、知能指数は60対53で差は7点、1タスクあたりの費用は$2.75対$1.53でした。単価表の5倍差は、実際の仕事に直すと約1.8倍差まで縮みます。Sonnet 5 は安い代わりに、たくさん書き出すからです。
この数字に照らすと、Claude Code や API の日常的な処理をすべて Fable 5 に寄せるより、Sonnet 5 を標準にして、失敗したときの損が大きい設計や難問だけを Fable 5 に渡すほうが合理的だと、私は考えています。
目次
- Claude Fable 5とSonnet 5は単価表で5倍、タスク単価で1.8倍
- 知能指数はFable 5が60、Sonnet 5が53
- Sonnet 5は安いのに出力トークンを使いすぎる
- Opus 4.8が中間に入ることで選択肢が変わる
- Claudeモデルは失敗コストで切り替える
- Fable 5を使う理由は知能指数ではなく手戻り回避
- Artificial Analysisの計測条件と出典
- この記事を書いた人
Claude Fable 5とSonnet 5は単価表で5倍、タスク単価で1.8倍
Artificial Analysis が2026年7月11日に保存したモデルページでは、Claude Fable 5 の単価は100万トークン(トークンは AI が文章を数える単位)あたり入力$10.00、出力$50.00です。Sonnet 5 は入力$2.00、出力$10.00で、どちらも Fable 5 の5分の1。ここまでは、公式の価格表を見たときの印象どおりです。
ところが同じページの「Cost per Task」は、Fable 5 が$2.75、Sonnet 5 が$1.53でした。Cost per Task は、Intelligence Index(複数の試験をまとめた総合点)の評価タスクを処理するのに実際にかかった費用の加重平均です。Sonnet 5 は Fable 5 より44%安く、裏返せば Fable 5 は Sonnet 5 の約1.8倍のタスク単価、ということになります。
| モデル | Intelligence Index | 入力 / 出力単価(100万トークン) | Cost per Task |
|---|---|---|---|
| Claude Fable 5 | 60 | $10.00 / $50.00 | $2.75 |
| Claude Opus 4.8 | 56 | $5.00 / $25.00 | $1.80 |
| Claude Sonnet 5 | 53 | $2.00 / $10.00 | $1.53 |
一つ断っておくと、Cost per Task は「同じ質問を1回投げたときの決まった料金」ではありません。評価タスクごとの出力の長さや処理の中身を含んだ平均なので、短い質問を数回投げる場合と、コードベース全体を調べさせる場合とでは、手元の請求額は変わります。それでも、単価表だけでは見えない「そのモデルがどれだけ仕事をしたか」まで含めて比べられる点に意味があります。
同じ散布図(横軸がタスク単価、縦軸が Intelligence Index)で3モデルの位置を並べると、価格帯の広がりが目で追えます。
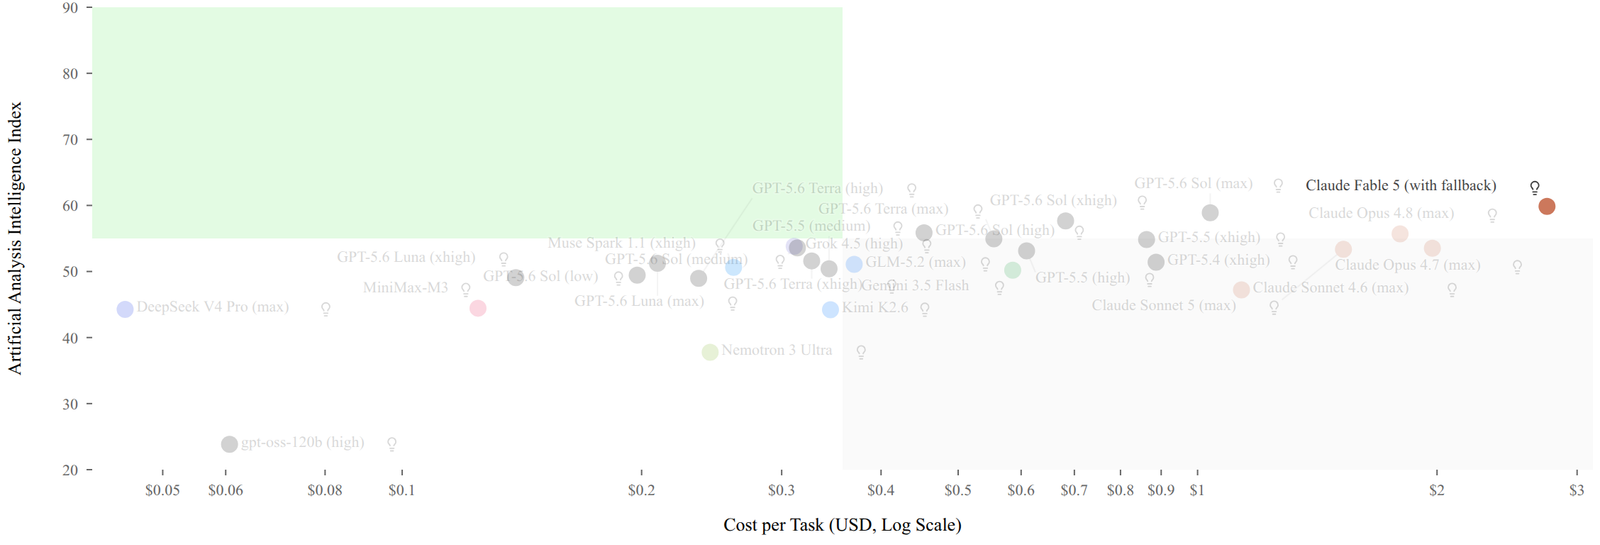 散布図の最右端、Intelligence Index 60の頂点に立つのがFable 5。タスク単価は2.75ドルと比較対象の中で最も高い(出典: Artificial Analysis https://artificialanalysis.ai/models/claude-fable-5)
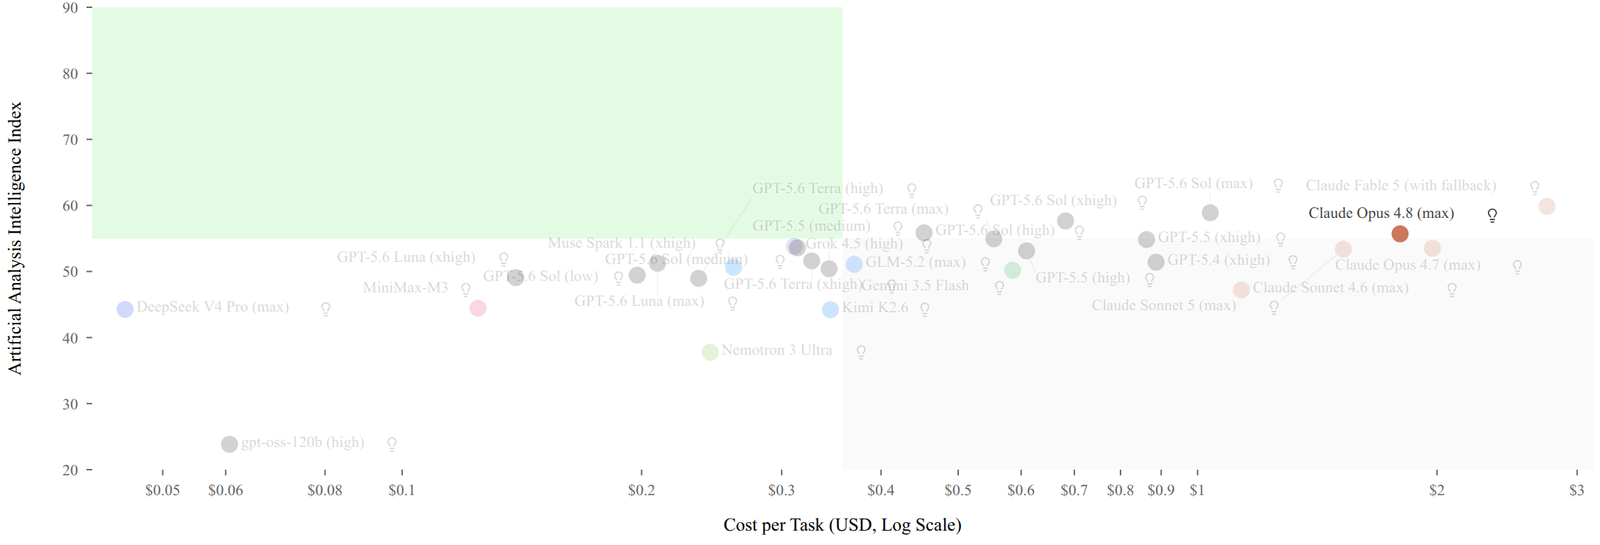 FableとSonnetのちょうど間に入るのがOpus 4.8。Intelligence Index 56をタスク単価1.80ドルで実現する中間解です(出典: Artificial Analysis https://artificialanalysis.ai/models/claude-opus-4-8)
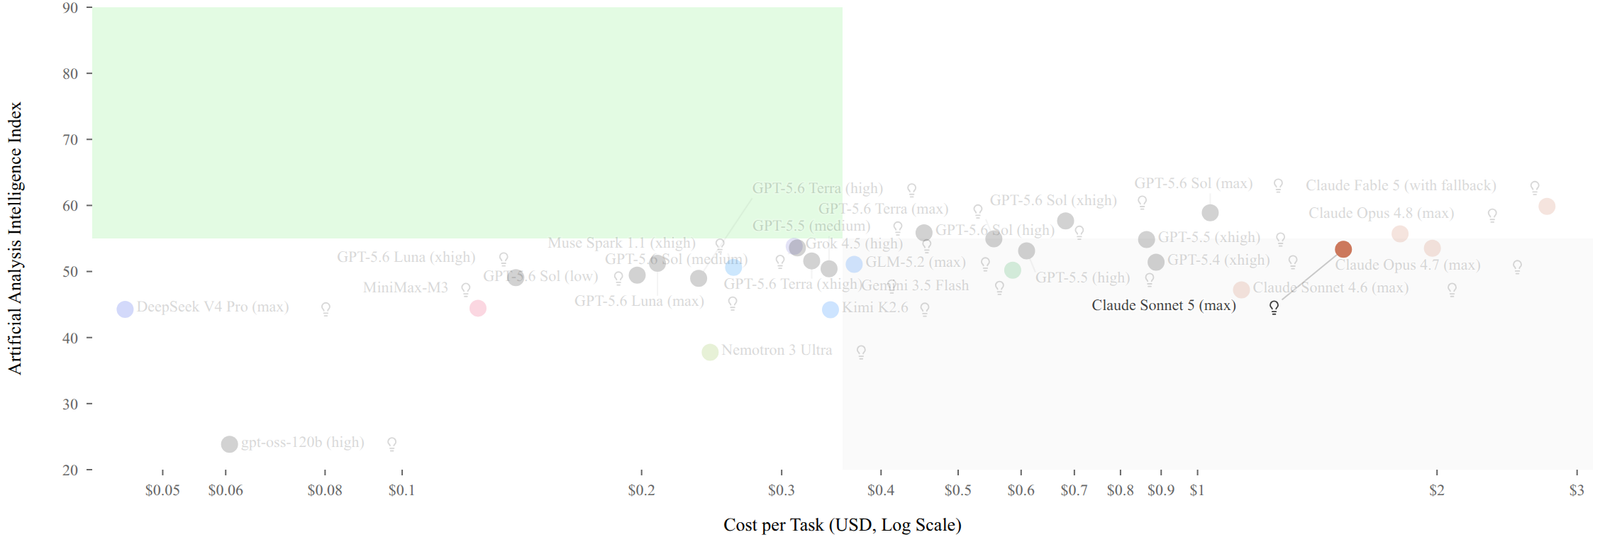 Sonnet 5のタスク単価は1.53ドル。Fableの56%のコストでIntelligence Index 53(Fable比88%)まで届く(出典: Artificial Analysis https://artificialanalysis.ai/models/claude-sonnet-5)
迷うとしたら、たぶん「5倍安い Sonnet 5 で足りるのか、それとも1.8倍の追加費用を払って Fable 5 で手戻りを避けるのか」という一点だと思います。そこで比べるべき数字は、トークン単価だけではありません。
知能指数はFable 5が60、Sonnet 5が53
Intelligence Index では Fable 5 が60で、比較対象188モデル中の1位でした。Opus 4.8 は56で5位、Sonnet 5 は53で11位です。最上位の Fable 5 と Sonnet 5 の差は7点で、単純な比率にすると Sonnet 5 は Fable 5 の約88%に当たります。
この7点の差は、どの作業にも同じように表れるわけではありません。文章の要約、既存コードの小さな修正、決まった形のテスト追加なら、差がそのまま目に見える品質の差になるとは限りません。一方で、複数のファイルにまたがる設計変更や、曖昧な要件から実装の方針を決める作業、失敗の原因を切り分ける作業では、最初の見立てが外れたときの手戻りが膨らみます。
数字の出どころも押さえておきたいところです。これは Anthropic の公式発表ではなく、Artificial Analysis が独自に計測して載せている第三者のデータです。Intelligence Index の順位を、そのまま自分のリポジトリでの成功率や開発の速さに読み替えることもできません。比較の材料として使い、最後は自分のタスクで確かめる必要があります。
もう一つの引っかかりが、Fable 5 の計測条件です。そこには「Adaptive Reasoning, Max Effort, Opus 4.8 Fallback」が含まれていて、モデル名だけでなく、考える深さの設定と、Opus 4.8 へのフォールバック(うまくいかないときの切り替え先)まで込みの数字になっています。この条件を外した Fable 5 が同じ60を出すとは限りません。ここを見落とすと、API で再現しようとしたときに数字と体感がずれます。
Sonnet 5は安いのに出力トークンを使いすぎる
タスク単価の差が5倍から1.8倍まで縮む主な理由は、Sonnet 5 の出力トークンの多さです。Intelligence Index の評価中に書き出した量は、Fable 5 が87Mトークン、Opus 4.8 が120Mトークン、Sonnet 5 が300Mトークンでした。比較モデルの中央値は60Mトークンなので、Sonnet 5 は中央値の5倍に達しています。
単価が安くても、出力が長ければ請求額は積み上がります。Sonnet 5 の出力単価は Fable 5 の5分の1ですが、評価中の出力量は Fable 5 の約3.4倍。安い単価を、大量に書くことで打ち消している構図です。
実際の作業でも、Sonnet 5 が毎回長い計画を書いてからコードに取りかかるなら、安さは見かけほど大きくありません。ログや調査メモ、修正案をすべて書き出させる使い方では、トークン単価より「1つの作業を終えるまでに何トークン使ったか」を見たほうがいいと思います。
とはいえ、長く書くことが常に悪いわけではありません。調べた過程を残したいときや、レビューで判断の理由を確かめたいときは、その冗長さが役に立つ場面もあります。困るのは、短い修正で済む作業にまで同じ書き癖が出ることです。
Opus 4.8が中間に入ることで選択肢が変わる
Claude の兄弟を Fable 5 と Sonnet 5 だけで見ると、「高い最上位か、安い主力か」の二択になります。そこに Opus 4.8 を入れると、間に実測の裏付けがある選択肢が現れます。
Opus 4.8 の Intelligence Index は56で、Fable 5 の60に4点届きません。Cost per Task は$1.80で、Sonnet 5 の$1.53より$0.27高く、Fable 5 の$2.75より$0.95安い位置です。出力トークンも120Mで、Sonnet 5 の300Mほどは膨らんでいません。
出力の速さは、Sonnet 5 が79.0 tokens/s、Fable 5 と Opus 4.8 が57.7 tokens/sでした。Fable 5 と Opus 4.8 が同じ値なのは、Fable 5 の計測条件に Opus 4.8 Fallback が含まれていることと話が合います。ただ、速さの数字だけで待ち時間を決めつけることはできません。入力の長さ、考えている間の待ち、ツール呼び出し、やり直しが、実際の体感を左右するからです。
Opus 4.8 は、Sonnet 5 だと調査や設計の詰めが甘くなりがちだけれど、Fable 5 ほどの最上位の費用は避けたい、という作業に置きやすいモデルです。Fable 5 の代わりと決めつけるより、三段階の振り分けの真ん中として見るほうが、実測値には忠実です。
なお、Claude Haiku 4.5 は Intelligence Index 24、入力$1.00・出力$5.00ですが、こちらは Non-reasoning(深く考えない設定)での計測です。今回の Fable 5、Opus 4.8、Sonnet 5 は Adaptive Reasoning の Max Effort 条件でそろえてあるため、Haiku 4.5 を同じ散布図の上の安い比較相手として扱うことはできません。
Claudeモデルは失敗コストで切り替える
日常の実装、既存コードの説明、単純なリファクタリング(動きを変えずにコードを整理すること)、テストのたたき台なら、Sonnet 5 を標準にするのが合理的です。タスク単価が3モデルで最も低く、出力の速さも79.0 tokens/sで、Fable 5 と Opus 4.8 の57.7 tokens/sを上回っています。多少長く書いても、さっと確かめて次へ進める作業なら、その差は吸収できます。
ただし、Sonnet 5 に長い調査をさせてから人が手直しする運用だと、出力トークンとレビューの時間の両方が増えるかもしれません。特に、変更の範囲を誤るとデータの移行や公開している API に響く作業では、モデル料金の差より、手戻りにかかる人の時間のほうが大きくなります。
作業の入口では、次のように分けると回しやすくなります。
- 定型修正や調査の初動はSonnet 5で処理する。
- 設計判断が必要になったらOpus 4.8へ引き上げる。
- 失敗時の復旧費用が高い変更や、複数の制約を同時に満たす難問だけFable 5へ渡す。
最初からモデルを決め打ちするのではなく、作業の途中で「ここにどれだけの賢さが要るか」を見直す考え方です。Claude Code なら、リポジトリ全体の理解を毎回 Fable 5 に任せるより、調査と実装の境目や、レビュー前の最終確認のような失敗の損が大きい地点に上位モデルを置くほうが、請求額を管理しやすくなります。
GPT-5.6 についても、effort別の実測やタスク単価の読み方を別の記事で扱っています。表示価格ではなく、1つの作業を終えるまでの推論の量を見る、という考え方は Claude の比較にもそのまま使えます。
Fable 5を使う理由は知能指数ではなく手戻り回避
私が Fable 5 を常用するとしても、「Intelligence Index が1位だから」を理由にはしません。60と53の7点差が、毎回の小さなコード修正で7点分の価値になるとは限らないからです。
Fable 5 に追加で払う意味が出るのは、設計を一度外すと、その後の修正案やテストまで芋づる式に作り直しになる場面です。出力を読み直し、間違った前提を取り除き、別の方針で実装し直す時間まで含めると、タスク単価の$1.22差は判断材料の一部にすぎません。逆に、失敗しても数分で戻せる作業なら、Fable 5 の追加料金を払う理由は薄くなります。
私なら、まず Sonnet 5 で処理して、次のどれかが起きた時点で Opus 4.8 か Fable 5 へ切り替えます。要求の解釈が複数に割れる、変更の範囲が広がる、同じエラーを2回以上繰り返す、またはレビューで設計の根拠を説明できない。この基準なら、モデルの格ではなく、失敗の兆しを合図にできます。
Fable 5 は「何でも5倍払うモデル」ではありません。単価表の差が大きいからこそ、使う場所を絞ったときに価値が見えてきます。日常の作業は Sonnet 5、判断の重い中くらいの作業は Opus 4.8、手戻りが許されない難問は Fable 5。これが、今回の第三者の実測から導ける現実的な配置です。
Artificial Analysisの計測条件と出典
この記事の数値は、2026年7月11日に確認した Artificial Analysis の保存ページにある、HTML のテキストと数値ラベルから取っています。散布図はモデル同士の位置関係を確かめる補助として扱い、本文で言い切った数値は、ページ内のテキストで確認できた値に限りました。
- Claude Fable 5 — Artificial Analysis
- Claude Opus 4.8 — Artificial Analysis
- Claude Sonnet 5 — Artificial Analysis
- Claude Haiku 4.5 — Artificial Analysis
比較の条件を見返すときの要点は次のとおりです。
- Fable 5はAdaptive Reasoning、Max Effort、Opus 4.8 Fallback付き。
- Opus 4.8とSonnet 5も各ページのmax条件を参照。
- Intelligence IndexとCost per TaskはいずれもArtificial Analysisの第三者計測値であり、Anthropic公式発表値ではない。
自分の環境で請求額を確かめるなら、同じタスクを各モデルで何回か走らせ、入力トークン、出力トークン、ツール呼び出しの回数、やり直しの回数を分けて記録してみてください。1回だけの成功例では、Sonnet 5 の冗長さも、Fable 5 が手戻りを防ぐ効果も見えてきません。
表示単価ではなく、作業が終わるまでに何を使ったかを測る。それが、5倍の差を正しく読み替える近道です。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事

Anthropicリーク2連発:Claude MythosとClaude Code流出で見えたKAIROS、BUDDY、Undercover Modeの正体
Anthropicの2週間で2回のリークを整理。Claude Mythosの位置づけ、Claude Code流出の中身、KAIROS/BUDDY/Undercover Modeの意味を分けて読む。
Claude Code の新effortモード徹底解説|max・ultracode・autoと『呪文ultrathink』の正体
Claude Code の /effort に増えた max・ultracode・auto と、プロンプトに紛れ込ませる呪文 ultrathink を、公式が明言した『ultracode は API の effort レベルではない』を起点に解剖。overthinking・自律ワークフロー・永続性と優先順位の罠まで、誤解されやすい論点を一次情報で正します。
Claude Code の /effort 完全ガイド|low〜maxの使い分けと『コストが増える本当の理由』
Claude Code の /effort(low〜max・ultracode・auto)は「賢さ」ではなく「トークンの気前よさ」のレバー。モデル別の推奨スタートと、Opus 4.8 でコストが増えた気がする原因を『トークナイザ』と『effort』の2軸に切り分ける考え方を、公式一次情報と v2.1.156 の実機確認で解説します。
Sonnet 5.5 xhighは買いか、Claude Opus 5.5 mediumが得か
Claude Sonnet 5.5のeffort別実測と公式指針を整理。Sonnet 5からの破壊的変更、Opus 5.5との費用差、mediumの使いどころを解説します。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:開発環境・キャリアまわりのサービス
 シンVPSを見る
 XServer VPSを見る
 strategy career の転職支援を見る