Sonnet 5.5 xhighは買いか、Claude Opus 5.5 mediumが得か
Claude Sonnet 5.5のeffort別実測と公式指針を整理。Sonnet 5からの破壊的変更、Opus 5.5との費用差、mediumの使いどころを解説します。
こんにちは。そろそろ衣替えを考え始める頃になりましたね。そんな季節の変わり目に、Claude の中くらいのモデル Sonnet 5.5 が出ました。
先に答えを書いておきます。会話・分類・取り次ぎのような短い判断をたくさん回すなら、Sonnet 5.5 は effort(どれだけ考えさせるかの設定)を medium にするのが最初の候補です。一方で、xhigh まで上げるなら、同じ Claude の上位モデル Opus 5.5 を medium で使うほうが、評価の費用はほぼ半分で済みました。賢さはほとんど同じなのに、です。
数字は、AI モデルを横並びで採点しているサイト Artificial Analysis(以下 AA)の2026年9月30日時点のデータと、Anthropic 公式のプロンプト指針を突き合わせたものです。Sonnet 5 から移すときに壊れる設定も、後半でまとめています。
medium は取り次ぎ役に向く。成果物を直す仕事には固定しない
medium を推す理由は、賢さと待ち時間の両方です。AA の知能指数(AA が出している賢さの総合点)は medium で 40.7。前の世代 Sonnet 5 のいちばん上の設定 max が 38.2 なので、新しい medium はもう旧世代の最上段を超えています。しかも、最初の文字が返ってくるまでが 0.81 秒と速い。
ただ、ここは正直に分けておきます。これは「medium にしたら実際の仕事の質が上がった」という実測ではありません。私は Codex(OpenAI のコーディング AI)へ仕事を渡す取り次ぎ役のサブエージェント(親の AI から仕事を任される子の AI)3体に medium を適用しましたが、適用前後の完了率・停止率・確認漏れは測っていません。
反対に、コードの広い範囲を変える仕事、複数箇所にまたがるテスト失敗の原因を追う仕事、個人情報の検出のように、出来上がったものの正確さがそのまま問われる仕事では、medium 固定を前提にしません。途中で止まったり確認が漏れたりするなら high へ上げ、それでも xhigh 相当の判断が要るなら、Sonnet 5.5 xhigh だけでなく Opus 5.5 medium も同じ課題で比べます。
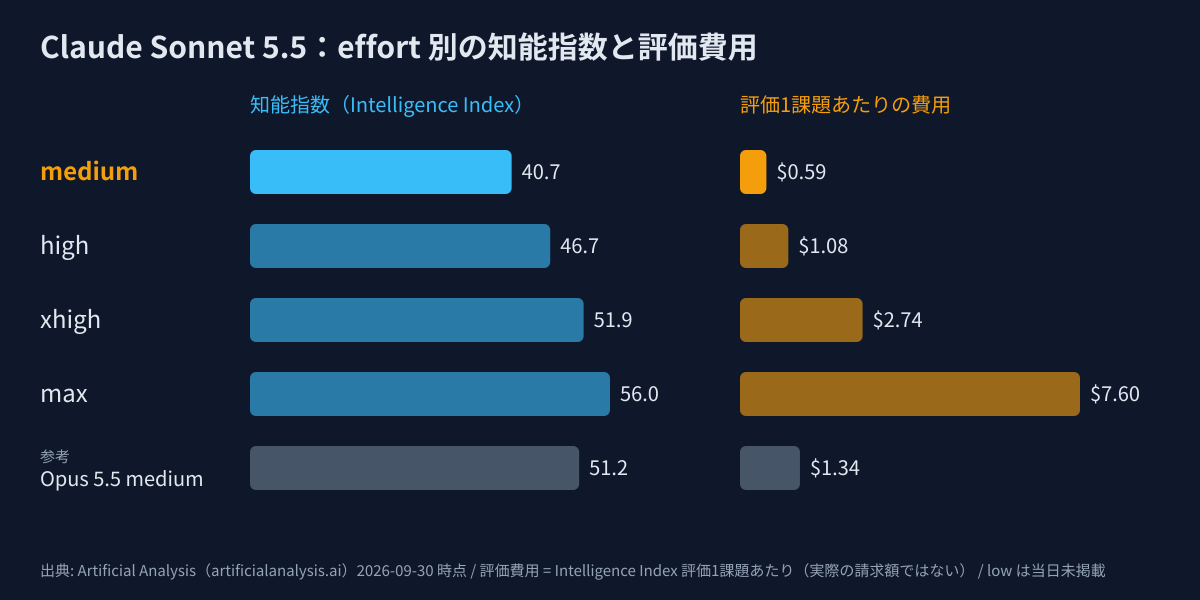
迷うとしたら、たぶんこの「xhigh まで上げるか、Opus に替えるか」の境目だと思います。xhigh の知能指数は 51.9 で、Opus 5.5 medium の 51.2 とほぼ並びます。それなのに AA の評価1課題あたりの費用は 2.74 ドル対 1.34 ドルでした。難しい処理を引き上げたい場面では、同じ Claude の中なら Opus 5.5 medium のほうが、費用も待ち時間も読みやすい場合があります。
後で見返す用に、判断を短く並べておきます。
- 会話・分類・取り次ぎ:まずSonnet 5.5 medium
- 途中停止や確認漏れがある処理:highで再測定
- xhigh相当の品質が必要:Sonnet 5.5 xhighとOpus 5.5 mediumを同じ課題で比較
- 広範囲のコード修正や検出精度が重要な処理:mediumのAA値だけで採用を決めない
この判断の土台は、AA の公開値、公式指針、そして私の環境での設定変更の3つです。自作のスクリーンショット個人情報隠しツールに公式指針の一文を足した前後の比較は、2026年9月30日時点ではまだやっていません。
Sonnet 5.5 は、medium を基準に測り直すモデル
Sonnet 5.5 は2026年9月28日に公開され、モデル ID はclaude-sonnet-5-5です。公式の位置づけは「速さと賢さの組み合わせ」を狙ったモデル。料金は入力が100万トークン(トークン=AI が文章を区切って数える単位)あたり2ドル、出力が10ドルで、Sonnet 5 と同じです。トークナイザ(文章をトークンに切り分ける仕組み)も Sonnet 5 と同じなので、同じ文章を渡せば同じトークン数になります。
ただし、考える深さの設定は旧モデルのものをそのまま持ち込めません。適応型思考(必要に応じてモデルが自分で考える量を変える仕組み)が既定で有効になり、effort が思考量を決めます。Claude API の既定値は high ですが、公式指針は Sonnet 5 の設定を持ち込まず、Sonnet 5.5 で改めて測るよう求めています。
この測り直しが大事なのは、medium がもう「軽いだけの設定」ではないからです。AA の知能指数は medium が 40.7、high が 46.7、xhigh が 51.9、max が 56.0 でした。Sonnet 5 の max は 38.2 なので、Sonnet 5.5 の medium は前世代の最上段を超えています。
速さのほうは少しややこしいです。出力速度は medium が 88.2 tokens/s、high が 105.6 tokens/s、xhigh が 109.7 tokens/s、max が 145.3 tokens/s で、数字だけなら max がいちばん速く見えます。ところが最初の文字が出るまでの時間は、medium の 0.81 秒から、high の 7.65 秒、xhigh の 15.04 秒、max の 308.29 秒へと伸びていきます。会話の取り次ぎで効いてくるのは、文字が流れる速さより、返事が始まるまでの待ち時間のほうです。
数字の出どころも書いておきます。どれも2026年9月30日にAAから取得した値です。知能指数・最初のトークンまでの時間・出力速度は AA の無料 API(プログラムからデータを取り出す窓口)から、評価1課題あたりの費用と評価で使った出力トークンは各モデルのページから記録しました。AA は Sonnet 5.5 の各行に「Default Fallback」という条件を付けて載せています。
気をつけたいのは、AA の知能指数が特定の実務を直接測るものではないことです。40.7 と 38.2 の差はモデル選びの入り口にはなりますが、途中で止まる率や確認漏れ、直すのにかかる時間までは保証しません。実務では、同じ課題を medium と high で複数回通し、失敗を直す手間まで含めて判断します。
出典: Artificial Analysis。数値は2026年9月30日に取得した同サイトのデータです。
effort を上げるほど賢くなる。そのぶん費用と待ち時間も増える
medium から high へ上げると、知能指数は 6.0 伸びます。high から xhigh では 5.2、xhigh から max では 4.1。段を上げるごとに伸びは少しずつ小さくなります。ところが AA の評価1課題あたりの費用は、medium の 0.59 ドル、high の 1.08 ドル、xhigh の 2.74 ドル、max の 7.60 ドルと、逆にどんどん膨らみました。
特に max は、xhigh より知能指数が 4.1 高いかわりに、評価費用は約2.8倍、最初の文字までの時間は約20倍です。max を選べばいつも得をする、という形にはなっていません。品質の差が実際の失敗を減らすことにつながる作業だけで使う設定です。
ここでの「評価1課題あたり費用」と「評価で使った出力トークン」は、AA の Intelligence Index(知能指数)を出すための評価での値で、読者の API 請求額そのものではありません。Sonnet 5.5 では、medium が 29M、high が 50M、xhigh が 100M、max が 410M の出力トークンを評価で使っています。考えた分も出力トークンとして数えられるので、effort を上げると、単価は同じでも評価費用が膨らむわけです。
low だけは前日の値です。2026年9月30日の AA の表示に low の知能指数が載っていなかったためで、当日の値を推し量って埋めたのではなく、2026年9月29日の 35.8 を参考値として扱っています。low を含む比較だけはほかの effort と同じ日付にならないので、medium 以上より確かさが一段落ちます。
計測条件は次のとおりです。
- 基準日:2026年9月30日
- 条件:AAの「Default Fallback」表示付きデータ
- low:当日未掲載のため、前日の35.8を2026年9月29日の値として記載
- 記録項目:知能指数、最初のトークンまでの時間、出力速度、評価1課題あたりの費用、評価で使った出力トークン
私が実務で測るなら、まず同じ課題を medium と high で3回ずつ通し、最後まで終わったか・途中で止まったか・確認が漏れたか・頼んでいない作業を足したかを記録します。たとえば「medium で3回中1回が確認待ちで止まった」なら、知能指数の差よりも high へ上げる理由を説明しやすくなります。
ただし、この3回ずつの比較は、この記事で実施済みの実測ではありません。実際に終わっているのは、AA の effort 別データの確認と、サブエージェント3体への medium 適用です。medium と high の同じ課題での比較はまだなので、停止率や実務品質の差は測れていません。
出典: Artificial Analysis。
Sonnet 5.5 xhigh と Opus 5.5 medium は、賢さが並んで費用は約2倍の差
Sonnet 5.5 xhigh の知能指数は 51.9。同じ Claude の Opus 5.5 medium は 51.2 で、評価上の賢さはほぼ同じ位置にいます。ところが評価1課題あたりの費用は、Sonnet 5.5 xhigh が 2.74 ドル、Opus 5.5 medium が 1.34 ドルでした。xhigh まで上げた Sonnet 5.5 は、評価コストで見ると Opus 5.5 medium の約2倍です。
待ち時間も Opus のほうが短く、最初の文字まで Opus 5.5 medium が 12.75 秒、Sonnet 5.5 xhigh が 15.04 秒。AA の評価で使った出力トークンも、Opus 5.5 medium の 38M に対して Sonnet 5.5 xhigh は 100M でした。
ここが少し意外なところです。Opus 5.5 の入力・出力の単価は、Sonnet 5.5 の2倍あります。それでも、同じくらいの評価結果を狙って Sonnet の考える量を増やすと、使うトークンが増えて単価の差が縮まり、今回のデータでは逆転しました。安いモデルを高い effort で回せば必ず安い、とは限らないんですよね。
なので、速さと費用を重く見るなら、Sonnet 5.5 は low から high の帯で比べ、xhigh 相当の品質が要るとなった時点で Opus 5.5 medium も同じ課題にかけるのが現実的です。
とはいえ、AA の比較だけで Opus への切り替えを決めるのは早いです。評価課題の中身、実際のプロンプト、ツールを呼ぶ回数によって、出力トークンも請求額も変わります。今回の数字は「xhigh まで考える量を増やしても、Opus medium より有利とは限らない」という比較の材料として使うのがちょうどいいと思います。
出典: Artificial Analysis。Opus 5.5 mediumの値は知能指数51.2、評価1課題あたり1.34ドル、最初のトークンまで12.75秒、出力トークン38Mです。
公式指針は「思考量・途中で止まる・見直しすぎ」の3つで読む
公式のプロンプト指針は項目が多く見えますが、Sonnet 5.5 を動かすうえで直接効くのは3つに絞れます。
1つ目は、考える量をプロンプトでごまかさず、effort で決めることです。「短く考えて」と書いても、思考トークンが確実に減るわけではありません。待ち時間や費用を下げたいなら low か medium へ下げ、品質が要るなら high 以上へ上げて比べます。
2つ目は、low と medium が途中で止まりやすいことです。公式指針によると、low は確認やテストを省きがちで、low と medium は長いエージェント作業(AI が自分で手順を進める作業)の途中で止まって、ユーザーに確認を求めがちです。対処として、依頼がはっきりしていても最後まで作業を続けること、依頼どおりか確かめてから終えることを、2段落で明示します。
私は2026年9月29日、Codex へ仕事を渡す取り次ぎ役のサブエージェント3体を Sonnet 5.5 medium で動かし、この2段落を日本語にして定義へ足しました。ただ、これは定義を変えたという事実であって、品質や停止率が良くなったと測った結果ではありません。medium を適用したことは確かめられますが、品質の改善効果はまだ測っていません。
3つ目は、xhigh と max の見直しすぎです。高い effort では、モデルが頼まれてもいない追加のレビューやサブエージェントを自分から始めることがあります。公式のテストでは、「頼まれた作業と検査が終わったら報告して止まる」という一文を足しただけで、max のコーディング課題にかかったセッション費用が約3分の1減り、品質は変わりませんでした。
まとめると、low と medium には「最後まで運ぶ」、xhigh と max には「終わったら止まる」を足します。同じプロンプトを全部の effort に配るのではなく、症状に合わせて足す文を変えるのがコツです。
構造化出力では、effort を上げる前に一文を足してみる
JSON(決まった形でデータを返す書式)のような構造化出力で、何段か考えないと解けない課題では、low や medium が考えずに答えてしまうことがあります。公式指針は、system メッセージ(AI への前提の指示)の末尾に「Think the problem through before you answer.」を足す方法を示しています。high では、この一文で xhigh に近い精度になったというテスト結果も出ています。
ただし、stop_reasonがmax_tokensになった応答は、JSON として読めそうに見えても失敗扱いにして、やり直します。Sonnet 5.5 ではmax_tokensに考えた分も含まれるので、出力だけを見て上限を判断すると、途中で切れた応答を通してしまいます。
⚠️ 構造化出力をJSONとしてパースできても、
stop_reason: "max_tokens"なら成功扱いにしないでください。再試行時はmax_tokensを増やすかeffortを下げ、直前の不完全なJSONを成果物として保存しない実装へ戻します。
私はスクリーンショットの個人情報を隠す自作ツールで、Sonnet 5.5 を構造化出力で使っています。この一文を足すかどうかは合成画像で比べる予定ですが、2026年9月30日時点ではまだやっていません。ここは結果が出るまで保留です。
検索ツールを使う処理にも注意が要ります。Sonnet 5.5 は、検索する手段を持っていても、学習したときの知識だけで答えることがあります。許可や料金のように変わりうる情報では、検索を控えさせる文を消し、必要な事実は検索するよう明示します。とはいえ毎回検索させればよいわけではなく、変わりうる事実に絞るのが扱いやすい線です。
⚠️ 検索ツールを渡しただけでは、最新情報を参照する保証になりません。料金・許可・仕様のように変わる事実を扱う処理では、検索対象を明示し、検索結果がない場合は回答を確定しない分岐へ戻します。
まだ分からないこと
構造化出力に公式の一文を足す効果は、自作の個人情報隠しツールではまだ確かめていません。比べるための合成画像のテストをまだやっていないからです。
effort を上げると待ち時間と費用が増えることは数字で確かめられます。でも、どの種類の失敗がどれだけ減るのかは、今回のデータだけでは分かりません。AA の知能指数を、そのまま自分のコード修正の成功率や個人情報の検出率に読み替えられないのは、正直もどかしいところです。
取り次ぎ役の3体に medium を適用したものの、前後の停止率や完了率を測っていない点も残っています。「medium が使いやすそう」という判断と、「medium で品質が良くなった」という結論は、分けて扱う必要があります。
Sonnet 5 から移す前に、壊れる設定を確かめる
Sonnet 5.5 には、今の Claude Code 連携や自作ハーネス(AI に決まった手順で仕事をさせる自前の仕組み)の設定がそのままでは通らない変更があります。移す前に、次の6点を確かめます。
⚠️
thinking: {"type": "disabled"}は使えません。思考をツール間だけに制限する場合はthinking: {"type": "between_tools"}を使います。ただし、between_toolsはlow、medium、highでのみ受け付けられ、xhighとmaxでは400エラーになります。xhighやmaxで400エラーが出たら、between_toolsを外して設定を戻してください。
ツールを無理やり呼ばせる指定も変わりました。tool_choiceのanyとtoolは400エラーになり、使えるのはautoとnoneです。決まった形どおりの入力を強制したい処理では、strict tool use か構造化出力へ移す必要があります。
⚠️ 既存設定の
tool_choice: "any"または"tool"を残すと400エラーになります。移行直後にエラーが出たら、まずautoへ戻して動作を確認し、強制が必要な箇所だけstrict tool useまたは構造化出力へ置き換えます。
考えた中身(思考ブロック)は、モデルと会話に結びつくようになりました。2026年8月31日以降に作られたアカウントでは、会話の途中で system、tools、過去のメッセージを書き換えると400エラーになる場合があります。会話は、書き換えずに後ろへ足していく形で運ぶ設計に変える必要があります。
⚠️ 会話途中のsystem、tools、過去メッセージの編集で400エラーが出る場合は、メッセージをその場で書き換える方式をやめ、同じ会話へ追記するか、新しい会話として最初から再送する方式へ戻します。
Claude API と Google Cloud では、旧computer_20251124は使えなくなり、computer_toolset_20260801へ移ります。
⚠️
computer_20251124を残したままモデル名だけを変更しないでください。computerツールのエラーが出た場合は、旧ツール指定へ戻すのではなく、computer_toolset_20260801への移行漏れを確認します。
advisor ツール(別のモデルに助言を求める機能)では、Opus 4.8、Opus 4.7、Sonnet 5 を助言役に指定できなくなりました。移すときはモデル名だけを差し替えるのではなく、エラーになる設定を先に洗い出してください。
⚠️ advisorの指定モデルで400エラーが出たら、使用不可のモデル名を以前の設定へ戻すのではなく、許可されている助言役へ差し替えるか、advisor呼び出し自体を外して通常の処理へ戻します。
最後の1点は、エラーにはならないものの見た目が変わる話です。ツールを呼ぶ合間に返ってくる文章のうち、1〜2文より長いものはthinkingブロックに入り、既定のdisplay: "omitted"では中身が空になります。text だけを画面に出すアプリだと、モデルが黙り込んだように見えるかもしれません。サーバー側で、返ってきたブロックの種類を確かめる実装が必要です。
⚠️ textブロックだけを画面へ出す実装では、
thinkingブロックへ移った文章を「応答なし」と誤認します。表示が空になったら、まずレスポンス全体のブロック種別をログで確認し、必要ならdisplay設定と表示処理を旧実装へ戻して切り分けます。
私の使い分け: medium は取り次ぎ役、成果物を直す仕事は別に測る
私の判断では、Sonnet 5.5 medium は「答えを仕上げる主役」より、「依頼を仕分けて、合う処理へ渡し、結果を短く確かめる役」に置くと、数字と役割がかみ合います。0.81 秒で返事が始まり、知能指数は 40.7。会話や仕分けのたびに high を待つ理由は薄いと思います。
一方、コードの変更範囲が広い仕事や、テスト失敗の原因を何か所も追う仕事では medium に固定しません。まず medium で最後まで進むかを見て、途中で止まったり確認が漏れたりするなら high へ上げます。それでも xhigh 相当の判断が要るなら、Sonnet 5.5 xhigh だけでなく Opus 5.5 medium も同じ課題で比べます。
私の環境では、Claude Code のメインは Opus 5.5 の effort medium です。Sonnet 5.5 に全部を移したわけではなく、Codex へ仕事を渡す取り次ぎ役の3体だけを Sonnet 5.5 medium にしています。どちらのモデルが上かを決めたのではなく、契約と役割で分けた結果です。
今の設定を見直すときは、前の世代の effort 名を信じるより、同じ課題を medium と high で3回ずつ通して、止まった回数・確認漏れ・頼んでいない作業を記録してみてください。差が小さいのに費用だけ増えるなら effort を下げ、失敗を直す手間が大きいなら上げる。この順番のほうが、ベンチマークの順位を眺めるより実務に近い判断になります。
改めて線を引いておくと、この記事で実施済みと言えるのは、AA の effort 別データの確認と、2026年9月29日に取り次ぎ役のサブエージェント3体へ medium を適用した設定変更の2つです。medium と high の同じ課題での比較、自作ツールの合成画像での比較、停止率の集計はまだなので、そこから先の優劣は推測として読んでください。
medium から始めて、xhigh では Opus 5.5 と並べて測る
Sonnet 5.5 は、medium の知能指数 40.7 で Sonnet 5 max の 38.2 を超えました。最初の文字までは 0.81 秒で、料金も Sonnet 5 と同じです。会話、分類、取り次ぎの出発点として medium を置く根拠はあります。
ただ、effort を上げるほど得とは限りません。xhigh は 51.9 で Opus 5.5 medium の 51.2 に並ぶ一方、AA の評価費用は 2.74 ドル対 1.34 ドル。max は 56.0 まで伸びますが、最初の文字まで 308.29 秒、評価費用は 7.60 ドルでした。
移すときに先にやるのは、モデル名の置き換えではなく、6つの API の変更点と表示の確認です。そのうえで medium には「最後まで運んで確かめる」2段落を足し、xhigh や max には「終わったら止まる」一文を足します。Sonnet 5.5 は、設定を上げ切って使うモデルではなく、役割ごとに effort を切り分けて使うモデルだと思います。
前の世代の設定の違いはClaude Sonnet 5のeffort・コンテキスト解説、Opusとの比較はClaude Opus 5.5のeffort実測、ほかのモデルとの比較はGPT-6.1 Solとの比較にまとめています。
参考リンク
- Prompting Claude Sonnet 5.5(公式プロンプト指針)
- What's new in Claude Sonnet 5.5(公式・新機能と破壊的変更)
- Artificial Analysis(2026年9月30日取得)
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
META-MARK × AI
AI モデル選びの次は、動かす場所です。
エージェントや自作ツールを止めずに動かすなら、常時稼働できる置き場所が要ります。手元の GPU で動かす場合の必要スペックも確認できます。


関連記事

Anthropicリーク2連発:Claude MythosとClaude Code流出で見えたKAIROS、BUDDY、Undercover Modeの正体
Anthropicの2週間で2回のリークを整理。Claude Mythosの位置づけ、Claude Code流出の中身、KAIROS/BUDDY/Undercover Modeの意味を分けて読む。

Claude Fable 5.2はLowでも旧版の最高点超え、費用は約3割|Opus+相談役よりLowで直接使う方が安かった
11月9日に出た Claude Fable 5.2 を、Artificial Analysis の指数と1問あたり費用で Fable 5.1・Opus 5.5 と比べました。Opus を本体に Fable を相談役(advisor)にする構成が得かどうかも、Anthropic の社内計測で確かめます。

effort を途中で変えるとキャッシュはどうなる? Fable 5.1 と Opus 5 で実測した
Fable 5.1 の値下げはキャッシュ読みだけ。Claude Code が TTL を決める仕組み、キャッシュを壊す操作と壊さない操作、effort 切替時の再書き込みを Fable 5.1 と Opus 5 の usage で実測しました。

Fable 5.1 は『low で旧 max 超え』なのか|公式グラフ5枚をベンチ別に正直に読む
Claude Fable 5.1 の公式グラフ5枚をベンチ別に読み、low が旧 Fable 5 の max を超えたベンチと超えなかったベンチを表にしました。常用 effort の決め方と Pro/Max の課金条件も整理します。
AI年表で詳しく見る
📅Claude Sonnet 5.5
Claude Sonnet 5.5——料金は Sonnet 5 のまま、「速さと賢さの最良の組み合わせ」をうたう中位モデル