MiniMax H3、画風検証は後回しでいい?速度差より広告の崩れに注目
RTX 4070 Ti 12GB で MiniMax H3 を使い、同じ構図の架空ビール CM を 3 画風×4 設定=12 本生成した比較。画風が変わっても生成時間はほぼ同じ、仕上がりは 3D アニメが最も安定。文字のないラベルに偽の文字が生える落とし穴と、音の指示の勘所まで。
こんにちは、META-MARK 管理人です。
前回の記事(Part1)では、MiniMax H3 を RTX 4070 Ti(VRAM 12GB)で動かしました。Fused Turbo と SLA を組み合わせることで、音声付きの 5 秒動画が 1 本 35 秒前後で作れることを確かめています。
Part1 の題材は、喫茶店のロボット店員 1 種類だけでした。そこで今回は「画風が変わっても同じように動くのか」を確かめます。お題は 実在しないビールの CM です。同じ構図・同じ動きの指示で、フォトリアル・3D アニメ・2D アニメの 3 画風を作り、それぞれ Part1 と同じ 4 つの設定で生成しました。I2V は合計 12 本です。
結論から言うと、12GB のローカル環境で CM の絵コンテや短い試作を作りたい人には向いています。 まず試すなら SLA あり・4 steps、細部を確認したい場合は高解像度の設定が候補です。一方、完成広告をそのまま出したい人には過剰な期待は禁物です。ラベルに偽文字が出たり小物が増えたりするため、目視確認と手直しが前提になります。今回もっとも安定していた画風は 3D アニメでした。
12GB で H3 が動いた次に気になるのは、「画風によって速度や破綻の度合いが変わるのか」「CM のように商品が映る用途で何が起きるのか」だと思います。同じ構図・同じ seed で画風だけを変えて確かめました。
計測は各画風・各設定につき 1 回だけです。seed 42 でそろえていますが、複数回のばらつきや標準偏差は取っていません。以下の速度差や画風の評価は、今回の出力で見られた傾向として読んでください。
検証の組み立て:同じ構図を 3 つの画風で
まず、動画の元になる静止画を画像生成 AI で 3 枚用意しました。場面はどれも同じで、夏の夕方のルーフトップテラスです。30 代の男女がテーブルにつき、女性が瓶からグラスへビールを注いでいます。
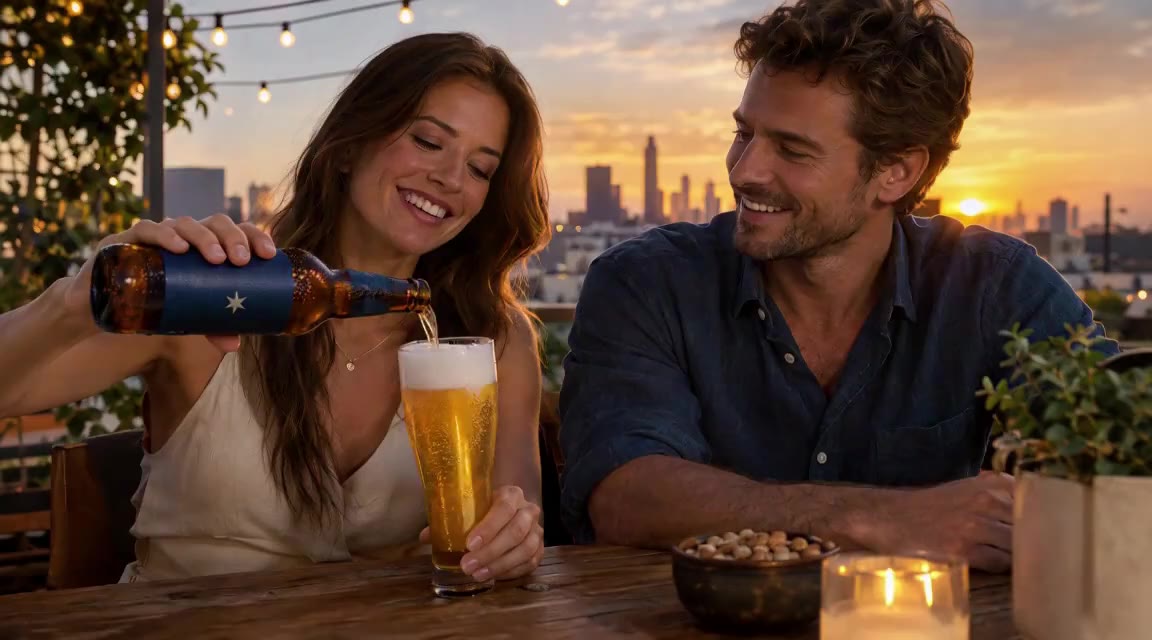
フォトリアルの元静止画(架空の銘柄・文字なしラベル)
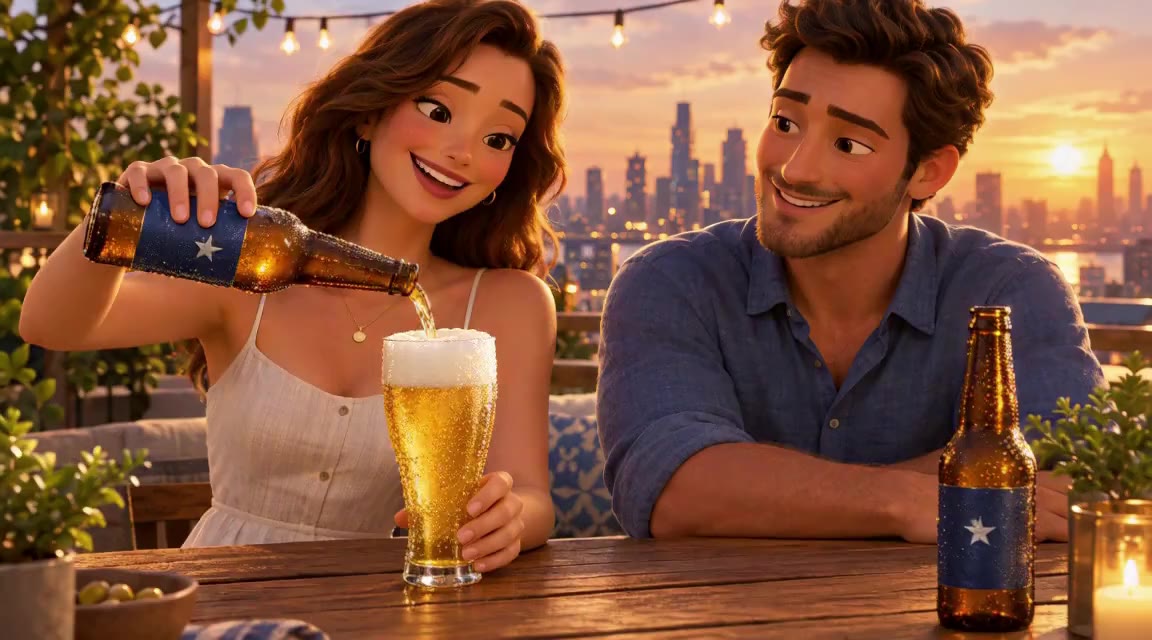
3D アニメの元静止画(架空の銘柄・文字なしラベル)
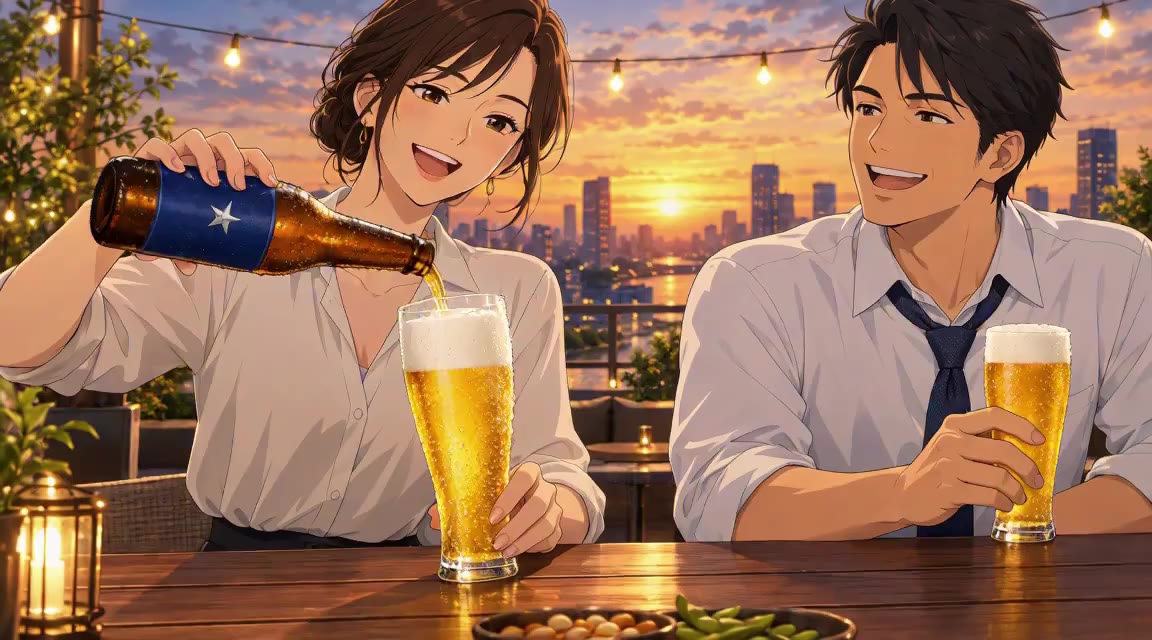
2D アニメの元静止画(架空の銘柄・文字なしラベル)
作るときに、次の 3 点に気をつけました。
- 架空の銘柄にする:実在の商標とかぶらないよう、瓶のラベルは紺地に銀の星マークだけにし、文字は一切入れませんでした
- 登場人物は明確に大人にする:お酒の表現なので、アニメ調でも幼く見えないよう、成人らしい顔立ちと体つきを指定しました
- 音は穏やかなものを指定する:別の題材で「群衆の歓声」を指示したところ、音声が破綻したことがあります。今回は「ビールを注ぐ音と泡の音、グラスが当たる乾杯の音、短いアコースティックギターのジングル。セリフなし」と指示しました
動きの指示は 3 画風とも共通で、「注ぎ終わって泡がグラスの縁まで上がる。女性がほほえんでグラスを持ち上げ、男性もグラスを上げて乾杯する。結露がしたたり、電球が瞬き、カメラがゆっくり寄る」としました。seed は 42 に固定し、画風ごとに 1 本空打ちしてから計測しています。
所要時間:画風が変わっても速さはほぼ同じ
| 画風 | A:SLA なし・4 steps | B:SLA あり・4 steps | C:SLA あり・6 steps | D:SLA あり・1152×640 |
|---|---|---|---|---|
| フォトリアル | 58.5 秒 | 34.2 秒 | 46.7 秒 | 66.5 秒 |
| 3D アニメ | 57.6 秒 | 34.5 秒 | 47.0 秒 | 61.5 秒 |
| 2D アニメ | 57.7 秒 | 34.6 秒 | 46.9 秒 | 61.8 秒 |
A〜C は 960×544 です。結果は Part1 のロボット店員(57.7 / 34.5 / 47.0 / 64.8 秒)とほぼ同じでした。今回の 3 画風では、960×544・SLA あり・4 steps の計測値は 34.2〜34.6 秒でした。 SLA で約 1.7 倍速くなる比率も同様に見られました。どの条件でもメモリ不足によるエラーは出ず、映像と音声の両方が出力されています。
今回の結果からは、画面に何が映っているかより、解像度・フレーム数・steps・SLA の有無が生成時間に影響していると考えられます。少なくともこの構成では、画風を変えても見積もり時間は大きく変わりませんでした。
T2Vも確認:速度は近いが、人物の固定にはI2Vが有利
静止画を使わず、指示文だけから作る T2V も補足で測りました。3 画風とも、1152×640 では 55.4〜55.9 秒、960×544・SLA あり・4 steps では 31.8〜31.9 秒でした。1152×640 の内訳は、フォトリアル 55.8 秒・3D アニメ 55.9 秒・2D アニメ 55.4 秒です。今回の計測では I2V より約 1 割速い結果でしたが、T2V はこの 2 条件のみの確認で、I2V と同じ 3 画風×4 設定の比較ではありません。
ラベルに偽の文字は出にくかった一方、3D アニメでは女性がやや幼く見える出力がありました。お酒の題材では幼く見える人物を使えないため、人物の見た目を元画像で固定したいなら I2V、指示文から場面を手早く作りたいなら T2V、という使い分けが現実的です。
⚠️ T2V の注意点と戻し方:今回の T2V は I2V と全条件をそろえた比較ではなく、人物が幼く見える出力もありました。人物の年齢感や見た目を固定したい場合は、元画像で人物を指定できる I2V に戻してください。この記事で見せる動画も、人物を静止画で固定できる I2V だけにしています。
4 つの設定の違いを画風ごとに並べたものです(音声なし)。
フォトリアルの 4 設定比較
3D アニメの 4 設定比較
2D アニメの 4 設定比較
画風ごとの仕上がり:3D アニメが最も安定
どの画風でも、「注ぐ → 泡が立つ → グラスを持ち上げて乾杯」という一連の流れは最後まで破綻しませんでした。そのうえで、画風ごとに次のような差がありました(いずれも 1152×640・SLA ありの出力です)。
3 画風の仕上がりを、音声付きで横に並べた動画です。
- フォトリアル:肌や髪の質感、夕日の逆光はかなりそれらしく出ます。ただし後半、無地だったラベルに読めない英字風の文字が現れました
- 3D アニメ:顔立ちも画風も最後まで崩れず、3 つの中で最も安定していました。ラベルの星マークもほぼ保たれています
- 2D アニメ:線と塗りのアニメ調はよく保たれます。ただし後半に、テーブルの瓶が 1 本増え、そのラベルにも偽の文字が出ました
今回も残った不満は、商品ラベルや小物を狙いどおり最後まで保てなかったことです。動きや画風がまとまっていても、広告素材として使うなら、商品まわりの確認と手直しは省けません。
今回、常用候補から外したのは C(SLA あり・6 steps)です。 4 steps から増やしても見た目に分かる改善が小さく、生成時間は約 35 秒から約 47 秒に延びました。試作は B(約 35 秒)、仕上げ候補は D(約 60〜66 秒)という使い分けが現実的です。ただし、これは今回の出力 1 回ずつに基づく判断です。別の題材でも 6 steps が不要だとは断定できません。
⚠️ SLA の注意点と戻し方:今回の比較では SLA ありの出力に大きな破綻は見られませんでしたが、別のプロンプトやモデル構成で画質が保たれる保証はありません。SLA を有効にした出力で形が崩れたり、気になる差が出たりしたら、同じ条件で SLA なしの A(4 steps)を作り直して見比べてください。高解像度の D が遅すぎる場合は、まず B(960×544・SLA あり・4 steps)に戻すと、今回の計測では約 35 秒で試作できます。速度優先の出力と品質確認用の出力を分けるのが安全です。
音声を周波数の図(スペクトログラム)で見ると、3 画風とも同じ構成でした。冒頭の約 1.5 秒は、注ぐ音や泡の音のような幅広い帯域のざわめきです。その後は、弦をはじいたような音程のある音が、減衰しながらいくつも並んでいます。指示した「注ぐ音」と「ギターのジングル」に近い構成です。音量の上限を超える音割れも、3 画風とも出ていません。ただ、画風や設定による音の違いは、管理人の耳では正直ほとんど聞き分けられませんでした。
上から、フォトリアル・3D アニメ・2D アニメ(いずれも 1152×640・SLA あり)の音声です。
広告用途で気をつけたい 2 つの落とし穴
今回いちばんの発見は、文字を入れなかったラベルに、モデルが勝手に「それらしい文字」を描き足すことでした。「ビールの CM」という文脈から、商品ラベルらしさを補ってしまうのだと思われます。読めない文字列なので、今回は実害はありません。しかし、偶然どこかの実在ロゴに似てしまう可能性はゼロではありません。広告のように商品が大きく映る用途では、次の対策をおすすめします。
- 生成後に、ラベルの部分を必ず目視で確認する
- 架空ブランドをはっきり見せたい場合は、後処理でラベルを差し替える前提にする
- ラベルが画面の大部分を占める構図は、そもそも避ける
⚠️ MiniMax H3 の注意点と戻し方:生成後にラベルの形や瓶の数が崩れていたら、そのまま採用しないでください。ラベルを後処理で差し替えるか、元の静止画から構図を調整して I2V をやり直すのが現実的です。T2V では偽文字が出にくかったものの、今回の結果だけで「文字が出ない」とは言えません。完成品ではなく、手直し前提の素材として扱うのが無難です。
もう 1 つは 音の指示 です。別の題材で「観客が歓声を上げる」と指示したところ、クラウドの A100 で生成しても、ローカルで生成しても、音声が砂嵐のような雑音や不自然な音に崩れました。今回のように「注ぐ音」「グラスの音」「短いジングル」といった具体的で穏やかな音を指示すると、きれいに出ます。大勢の歓声が必要な場面では、H3 の音声は使わず、あとから BGM や効果音に差し替える前提で作るほうが確実です。
⚠️ 音声の注意点と戻し方:聞き取りにくい音や不自然な音が出たら、映像と音声を無理に一体で使わず、音声をミュートして外部の BGM・効果音に置き換えてください。今回うまくいったのは穏やかな音の指示で、歓声のような複雑な音まで安定して出せるとは確認できていません。
まとめ:12GB でも画風を選ばず使える、ただし最後は人の目で
- 画風を変えても、今回の生成時間はほぼ一定でした。960×544・SLA あり・4 steps は約 35 秒、1152×640 は約 60〜66 秒が目安です。ただし計測は各条件 1 回なので、数値は参考値です
- 仕上がりが最も安定していたのは 3D アニメです。フォトリアルと 2D アニメも試作に使えますが、後半の細部(ラベル・小物)には注意が必要です
- まず試すなら B(SLA あり・4 steps)、仕上げ候補は D(1152×640)。C(6 steps)は今回、見た目の改善に対して時間が延びたため常用候補から外しました
- T2V は今回の 2 条件では I2V より速い結果でしたが、I2V と全条件をそろえた比較ではありません。人物の見た目を固定したい場合は I2V が扱いやすい結果でした
- 広告用途では、ラベルに生える偽文字と音の指示の 2 点を確認してください。12GB のローカル環境でも CM の絵コンテを動画にする用途には役立ちますが、完成広告として出す前には人の目で確認し、必要なら映像や音声を差し替える必要があります
なお、MiniMax H3 のライセンスは利用可能地域から EU・英国・韓国・米国を除外しています。実際の広告に使う場合は、配信先の地域も確認してください(詳しくは Part1 に書きました)。
この記事の動画・静止画は、すべて AI で生成したものです(動画は MiniMax H3、元の静止画は画像生成 AI)。登場する銘柄・人物は架空です。Powered by MiniMax H3.
検証日・環境
- 検証日:2026-09-23
- GPU:NVIDIA GeForce RTX 4070 Ti(12GB)/メインメモリ 32GB+スワップ 8GB/Ubuntu 24.04
- ComfyUI 0.37.0/PyTorch 2.14.0+cu130
- モデル:Fused Turbo int8(MATLOWAI)+ Qwen3-VL-32B nvfp4 テキストエンコーダ+映像 VAE int8+音声 VAE fp32
- SLA:H3 SLA Attention ノード(sparsity 0.90・block 64)
- 元の静止画:画像生成 AI で作成(架空の銘柄・人物)
- I2V 生成条件:5.17 秒(124 フレーム・24fps)・seed 42・画風ごとに空打ち後に計測
- I2V の計測用生成は各設定 1 回。誤差範囲・標準偏差は算出していません
- T2V は 1152×640 と 960×544・SLA あり・4 steps の 2 条件を確認。I2V と同じ 3 画風×4 設定の全条件比較ではありません
出典
- モデル本体の配布元:MiniMaxAI/MiniMax-H3(Hugging Face)
- 実測で使った Fused Turbo int8 の配布元:MATLOWAI/minimax-h3-fused-turbo-int8-convrot(Hugging Face)
- 実測で使った SLA Attention ノード:PlagueKind/ComfyUI-PlagueKind-Nodes(H3 SLA Attention)。設定は sparsity 0.90・block 64 です
- 利用地域を確認する際に参照したライセンス:MiniMax H3 Community License。EU・英国・韓国・米国向けの利用は対象外として扱っています
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事

ComfyUI + FLUX.1-devでローカル画像生成——ノードエディタは難しいのか検証
RTX 4070 Ti(12GB)にComfyUI v0.12.3 + FLUX.1-dev fp8を入れて実際に画像生成。VRAM実測6.9GB、ノードエディタの構造、fp8量子化の選び方まで正直に記録。

RTX 4070 Ti 自宅サーバーに Qwen3-TTS を入れた実録 — API変更で3回詰まった話
自宅の RTX 4070 Ti に Qwen3-TTS をデプロイした記録。クラス名・メソッド名・戻り値の形式が全部変わっていて3回詰まった。同じ罠に落ちる人が減るよう全部書く。

MiniMax H3はつなぎ目が飛ぶのに直せる——同seedで構図維持
RTX 4070 Ti 12GB で MiniMax H3 の動画を 40 秒まで延ばした実測。1 本の上限 15 秒を続きを生成する追加ノードでつなぎ、つなぎ目の構図飛びは同じ seed のまま指示文 2 行で解消、スワップ枯渇は区間を分けて回避した。
RTX 4070 Tiで72秒の紹介動画を自作:クラウド代は声の約3円だけ
RTX 4070 Ti(VRAM 12GB)の自宅 PC で、複製した自分の声と MiniMax H3・WhisperX・ACE-Step・Remotion を順に回し、72秒の紹介動画を作った実践記録。工程ごとの所要時間と費用(クラウド代は声の約3円)、字幕を誤字ゼロにする方法、書き出しが止まる罠、映像が暗いなど一発出しで残った課題まで。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:GPU・キャリアまわりのサービス
 OZ GAMINGの構成を見る
 strategy career の転職支援を見る