RTX 4070 Ti 12GBでMiniMax H3を実測:5秒動画は34.5秒
VRAM 12GB の RTX 4070 Ti で MiniMax H3 の音声付き動画をローカル生成した実測。Fused Turbo int8+SLA+nvfp4 エンコーダで 5 秒動画が 34.5 秒。SLA あり/なし・steps・解像度を同じ seed で切り分けた表と、初回計測の罠・ComfyUI 更新後の起動ループまで。
こんにちは、META-MARK 管理人です。
前日、MiniMax H3 をクラウド GPU(A100 40GB)を借りて動かし、5 秒の音声付き動画を 14 本作りました。1 本あたり約 7 分、費用は合計で約 1 ドル。十分に安いのですが、「12GB の GPU でも H3 が動く」という話題を見かけて、手元の RTX 4070 Ti(VRAM 12GB・メモリ 32GB)で試してみることにしました。
正直に書くと、最初の見立ては「無理」でした。公式のモデル一式は約 55GB、フル精度で動かすと VRAM のピークは約 32GB。12GB+32GB ではどう足しても載らない、と。結論から言うと、この判断は間違っていました。
12GB で動かす鍵は fp8 ではなかった
「12GB なら fp8 版を使えばいいのでは」と考える方は多いと思います。私もそうでした。ところが公式配布の fp8 版は、本体だけで約 21GB あります。int8 版とほぼ同じサイズで、しかも海外の実測記事では int8 より遅いと報告されています。
では何が鍵かというと、次の 2 つです。
- ComfyUI の動的オフロード:本体をすべて VRAM に載せる必要はありません。メインメモリから必要な分だけ GPU へ流し込みます。テキストエンコーダ、本体、VAE も順番に使われるので、同時に全部が載る必要はありません
- GGUF 量子化:有志による Q3(約 9GB)〜 Q4(約 11.5GB)の版もあります
今回は 1 を採用しました。容量を足し算して可否を決めるのではなく、同じクラスの GPU の実測報告を探すべきでした。RTX 3060 12GB での完走報告がすでに出ていたのです。
Turbo・Fused Turbo・SLA の役割を整理する
H3 の高速化まわりは名前が似ていて混乱しやすいので、整理しておきます。
- Turbo(lightx2v):蒸留 LoRA です。生成の繰り返し回数(steps)を約 20 回から 4〜8 回に減らします。名前は「4step」ですが、作者の推奨は 6〜8 回です
- Fused Turbo(MATLOWAI):本体に Turbo LoRA と動きを滑らかにする LoRA を焼き込み、int8 に量子化した 1 ファイル(約 21GB)です。ここが重要なポイントで、LoRA を後から積むと、ComfyUI は元の重みの退避コピーを保持します。int8 本体なら約 21GB 余計にメモリを食う計算です。焼き込み済みなら、この退避が不要になります
- SLA(Sparse-Linear Attention):アテンション計算のうち重要なブロックだけを計算する仕組みで、専用の ComfyUI ノードで有効にします。よく見る「2.5 倍速」はマルチ GPU 構成の数字です。ノード作者によれば、単体 GPU では 1.4〜1.75 倍が目安とのことです
テキストエンコーダには nvfp4 版(約 15.7GB)を使いました。nvfp4 は RTX 50 系向けの形式ですが、RTX 40 系でも読み込んで動かせます(速くはなりません)。
構築:40GB が 72 秒、そして思わぬ落とし穴
モデルは本体、テキストエンコーダ、映像 VAE(int8)、音声 VAE の 4 ファイルで約 40GB です。Hugging Face の CLI で 3 並列ダウンロードしたところ、なんと 72 秒 で終わりました。クラウドで単一接続のダウンロードをしたときは、55GB に約 40 分かかっていたので、桁が違います。
SLA ノードは、第三者が作ったプログラムを入れることになります。そこで、コミットを固定して取得し、外部通信・プロセス起動・環境変数の読み取りといった危険なパターンがないことを確認してから導入しました。
ところが、ComfyUI を起動すると即座に落ちます。ログを追うと、前日に ComfyUI を 0.37.0 へ更新して以来、起動と停止を 1,187 回繰り返していた ことが分かりました。原因は、更新で入った高速化カーネル(comfy-kitchen 0.2.35)が、古い PyTorch 2.6 と噛み合わないことでした。ComfyUI の README には、RTX 20 系以降では cu130 以上の PyTorch が必須とはっきり書かれています。PyTorch を 2.14.0+cu130 に更新して、ようやく起動しました。
「更新した=動いている」ではない、という当たり前の教訓です。更新後はログと HTTP の応答で、本当に起動しているかを確認するようにしましょう。
実測結果:SLA で約 1.7 倍、1152×640 でも 65 秒
題材は、この記事のために画像生成 AI で用意したオリジナルの静止画です。雨の夕方、喫茶店のロボット店員がコーヒーカップを持っています。ここから 5 秒(124 フレーム・24fps)の音声付き動画を作る I2V で測りました。動きの指示は「カップを持ち上げ、首をかしげて目を細める。湯気が立ち、窓に雨が流れ、カメラがゆっくり寄る」です。比較が公平になるように seed は 42 に固定し、1 本空打ちしてモデルを温めてから測っています。
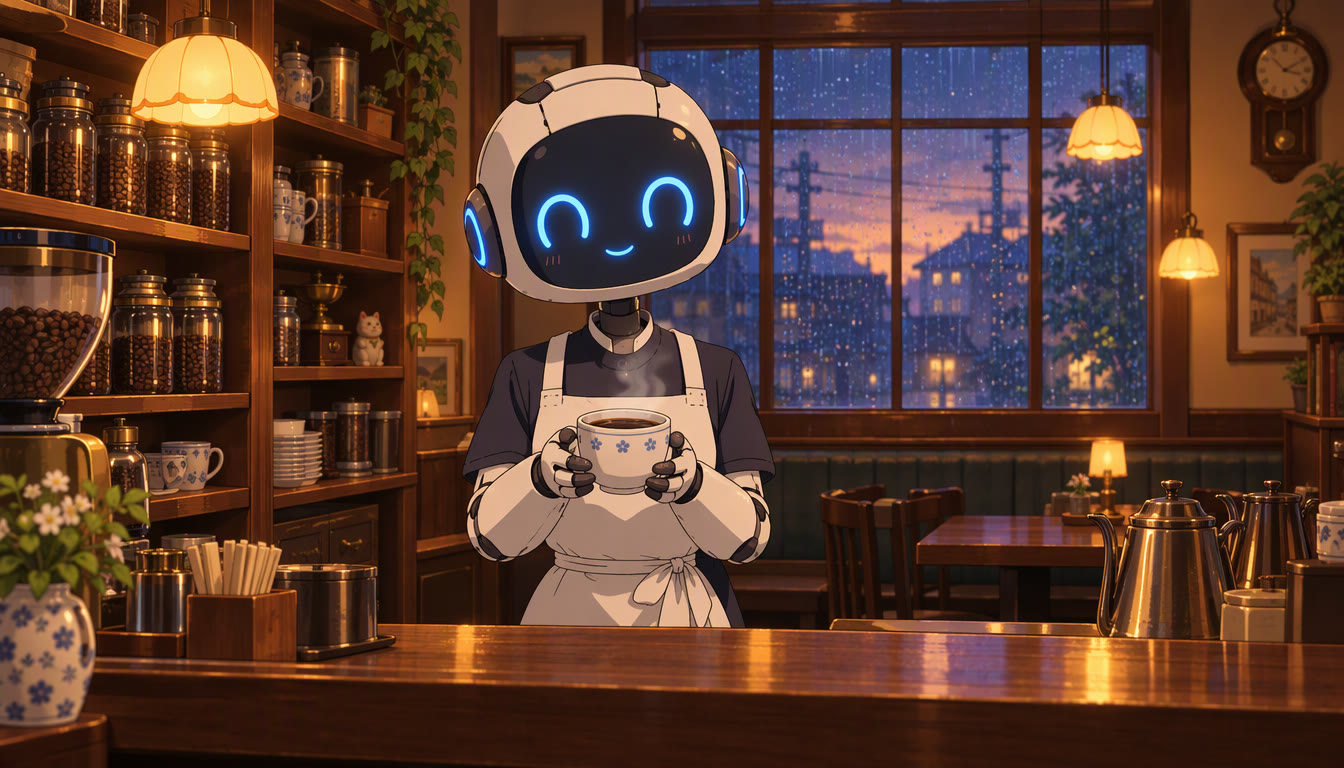
I2V の元にしたオリジナル静止画(1344×768)
| 条件 | 解像度 | steps | SLA | 所要時間 |
|---|---|---|---|---|
| A | 960×544 | 4 | なし | 57.7 秒 |
| B | 960×544 | 4 | あり | 34.5 秒 |
| C | 960×544 | 6 | あり | 47.0 秒 |
| D | 1152×640 | 4 | あり | 64.8 秒 |
表の 4 条件で作った動画を、音声付きで 1 画面に並べました。
- VRAM のピークはどの条件でも約 11.8GB でした。12GB をほぼ使い切りますが、メモリ不足によるエラーは一度も出ていません
- すべての条件で、映像と音声(AAC 32kHz ステレオ)の両方が出力されました
- SLA ありは、なしより 約 1.7 倍速い です。別の題材(キャラクターが機材を操作するカット)でも 57.2 秒 → 34.0 秒で、ほぼ同じ比率が再現しました
- 画質は、今回の題材ではどの条件でもアニメ調と構図が保たれました。別の題材では、SLA なしの後半でカメラが大きく回り込み、存在しない尻尾や機材が生えるという崩れが出ました。SLA の方が常に安定するとまでは言えませんが、少なくとも SLA で画質が落ちた例はありませんでした
- steps を 4 から 6 に増やしても、見た目の差は小さめです
- 1152×640 は細部の保持が最もよく、12GB での実用上限だと感じました
- メインメモリは空きが最小 0.25GB、スワップは 5GB 使用とぎりぎりですが、特別な起動オプションなしで完走しています
動画を再生できない環境向けに、同じ 4 本からコマを抜き出したものも置いておきます。
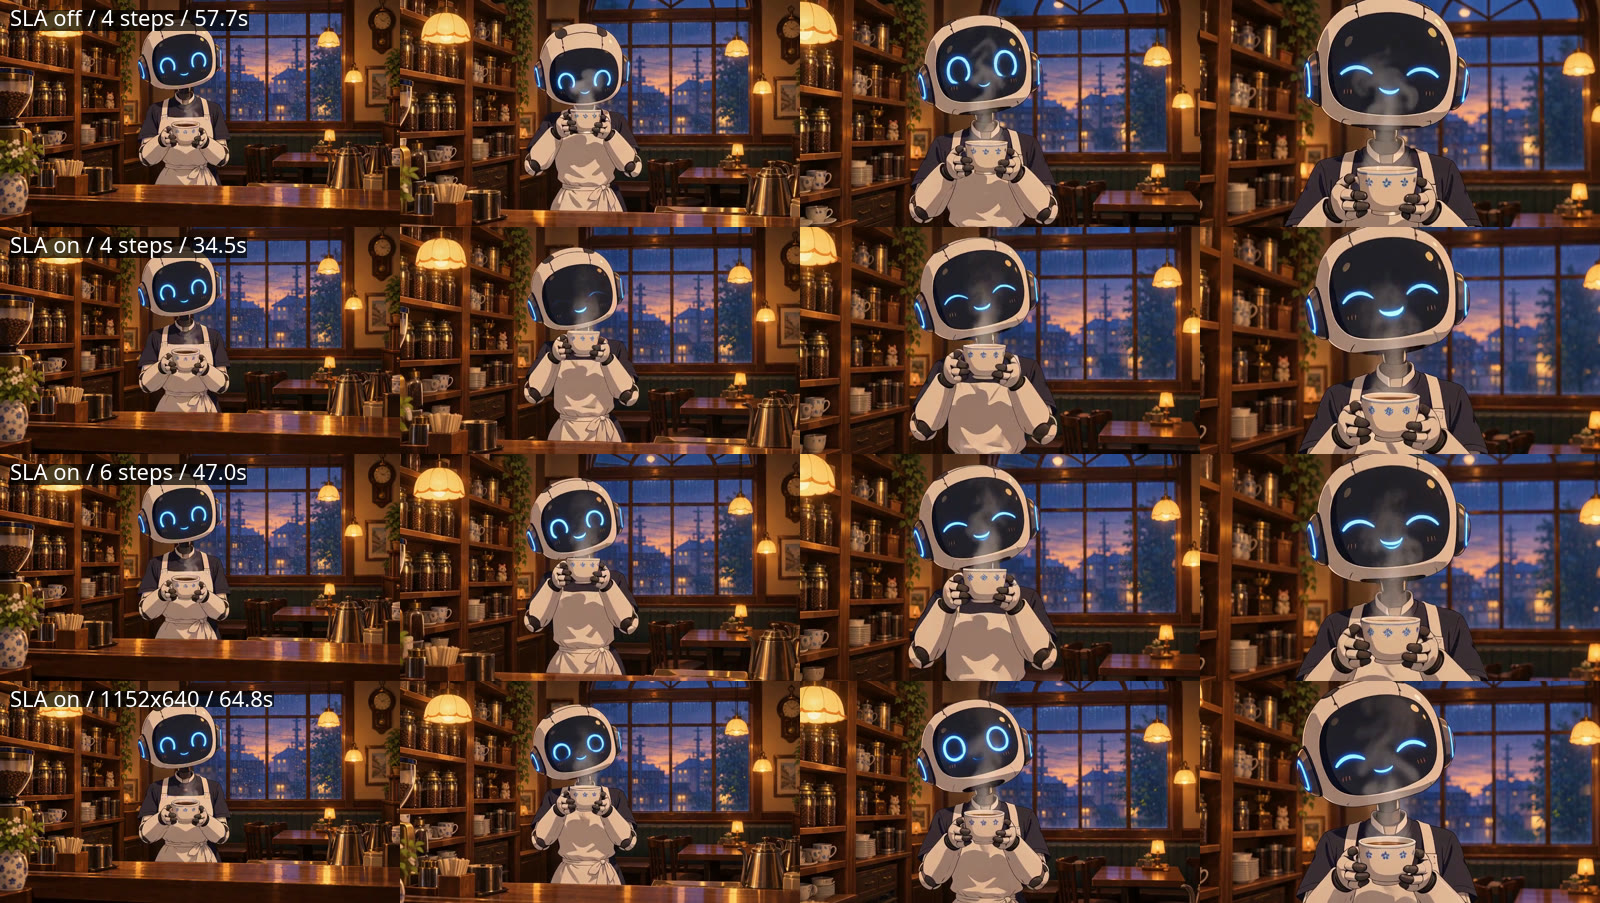
同じ seed で条件だけを変えた 4 本。左から約 1.7 秒間隔のコマ
最も細部が残った条件 D は、1 秒ごとに見るとこうなります。
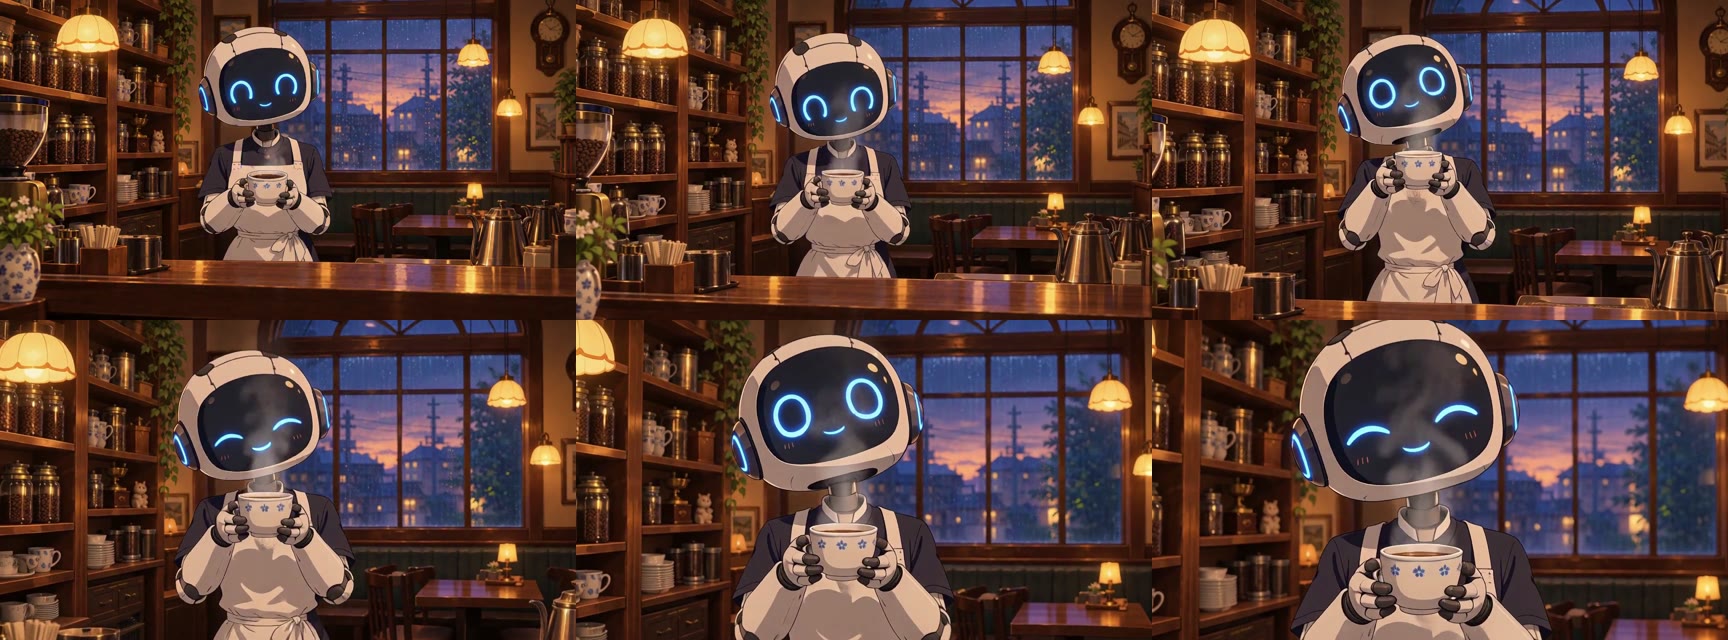
条件 D(1152×640・4 steps・SLA)の 1 秒ごとのコマ。所要 64.8 秒
ひとつ罠がありました。最初の 1 本は 77.6 秒かかり、2 本目(SLA あり)は 36 秒でした。これを見て「SLA で 2 倍」と書きかけたのですが、初回はモデルの読み込みとテキストエンコードが含まれています。そのうえ seed も違っていました。速度比較は、1 本空打ちしてから seed を固定して行うのが鉄則です。
クラウド A100 との比較と使い分け
前日のクラウド版は 20 steps・1344×768 で、1 本約 7 分でした。同じ静止画から作った別題材のカットで見比べると、アニメ調の一貫性はクラウド版の方が上でした。ローカル版は Turbo と、焼き込まれた動き用 LoRA の影響か、キャラクターの毛並みがやや写実寄りに振れました。
一方で、ローカルは 1 本 35〜65 秒・課金ゼロ です。プロンプトや seed を変えて何十本も試す「当たり付け」には圧倒的に向いています。私の結論は、試作とリテイクの見極めはローカル、仕上げの本番はクラウド という二段構えです。
仕上げ側のクラウド GPU は、前日の A100 も含めて Vast.ai で借りました。出品されている GPU を価格や性能で選び、時間単位で借りられるので、今回のように「数時間だけ大きい GPU が欲しい」用途に合います。起動の手間を減らしたい場合は、テンプレートから GPU マシンを立ち上げられる RunPod も選択肢です(H3 は RunPod では試していません)。
上記は紹介リンク(アフィリエイト)です。
最後にライセンスについて。MiniMax H3 Community License では、利用可能地域から EU・英国・韓国・米国が除外されています。生成物をそれらの地域で使うことも認められていません。日本での利用と商用利用は可能です(年商 2,000 万ドル超は事前許可が必要)。案件で使う場合は、納品先の地域まで確認しておくと安心です。
この記事の動画は、すべて MiniMax H3 で AI 生成したものです(元の静止画も画像生成 AI で作ったオリジナルです)。Powered by MiniMax H3.
検証日・環境
- 検証日:2026-09-23
- GPU:NVIDIA GeForce RTX 4070 Ti(12GB)/メインメモリ 32GB+スワップ 8GB/Ubuntu 24.04
- ComfyUI 0.37.0/PyTorch 2.14.0+cu130
- モデル:Fused Turbo int8(MATLOWAI)+ Qwen3-VL-32B nvfp4 テキストエンコーダ+映像 VAE int8+音声 VAE fp32
- SLA:H3 SLA Attention ノード(sparsity 0.90・block 64)
出典
- MATLOWAI/minimax-h3-fused-turbo-int8-convrot(Hugging Face)
- lightx2v/Minimax-h3-Turbo(Hugging Face)
- lightx2v/Minimax-h3-Turbo-SLA(Hugging Face)
- PlagueKind/ComfyUI-PlagueKind-Nodes(H3 SLA Attention)
- Comfy-Org/MiniMax-H3(Hugging Face)
- unsloth/MiniMax-H3-GGUF(Hugging Face)
- MiniMax H3 on RTX 3060(smeltcore)
- MiniMax H3 Requirements: INT8 vs FP8(wan2-7.io)
- MiniMax H3 Community License
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事

ComfyUI + FLUX.1-devでローカル画像生成——ノードエディタは難しいのか検証
RTX 4070 Ti(12GB)にComfyUI v0.12.3 + FLUX.1-dev fp8を入れて実際に画像生成。VRAM実測6.9GB、ノードエディタの構造、fp8量子化の選び方まで正直に記録。

RTX 4070 Ti 自宅サーバーに Qwen3-TTS を入れた実録 — API変更で3回詰まった話
自宅の RTX 4070 Ti に Qwen3-TTS をデプロイした記録。クラス名・メソッド名・戻り値の形式が全部変わっていて3回詰まった。同じ罠に落ちる人が減るよう全部書く。

ローカルAI vs クラウドAI、2026年の今どちらが本命なのかを正直に語る
2026年のAI環境の中で、ローカルAIとクラウドAIのメリット・デメリットを徹底比較。コスト、プライバシー、性能、手軽さを管理人の視点で解説します。
MiniMax H3、画風検証は後回しでいい?速度差より広告の崩れに注目
RTX 4070 Ti 12GB で MiniMax H3 を使い、同じ構図の架空ビール CM を 3 画風×4 設定=12 本生成した比較。画風が変わっても生成時間はほぼ同じ、仕上がりは 3D アニメが最も安定。文字のないラベルに偽の文字が生える落とし穴と、音の指示の勘所まで。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:GPU・キャリアまわりのサービス
 OZ GAMINGの構成を見る
 strategy career の転職支援を見る