ComfyUI + FLUX.1-devでローカル画像生成——ノードエディタは難しいのか検証
RTX 4070 Ti(12GB)にComfyUI v0.12.3 + FLUX.1-dev fp8を入れて実際に画像生成。VRAM実測6.9GB、ノードエディタの構造、fp8量子化の選び方まで正直に記録。
RTX 4070 Ti(12GB VRAMVRAMグラフィックボードに載っている、GPU 専用の高速なメモリ。詳しく →)に ComfyUI v0.12.3 + FLUX.1-dev fp8 を入れて動かした記録。VRAM実測 6,892MiB、生成は512×512で1分以内。ノードエディタは思ったより難しくなかった。
関連記事としては gemma4 12BはどのGPUで動く?実測3点+主要18枚の速度早見表【VRAM 8GBは崖の縁】 もあわせて読むと、今回の論点とのつながりを把握しやすくなります。
| 項目 | 値 |
|---|---|
| GPU | RTX 4070 Ti 12GB |
| モデル | FLUX.1-dev fp8 |
| VRAM使用量 | 約6.9GB |
| 解像度/steps | 512×512 / steps=15 |
| 難易度 | セットアップさえ通れば普通 |
目次
- FLUX.1-devを選んだ理由 {#flux1-dev}
- ComfyUI v0.12.3 の新しいUIについて {#ui}
- ノードエディタの実態 {#node}
- RTX 4070 Ti 12GBでの実測 {#vram}
- 気になった点 {#cons}
- よくある質問 {#faq}
- まとめ {#summary}
- この記事を書いた人
FLUX.1-devを選んだ理由 {#flux1-dev}
Flux.1を試したらStable Diffusion 1.5に戻れなくなった件でも書いたとおり、今さらSD1.5に戻る気はない。FLUX.1系のモデルが出てから、それ以前の生成物を見るのがしんどくなってしまった。
問題はVRAMです。FLUX.1は重い。fp16フルモデルで20GB以上使うため、RTX 4090でなければ素直に動かせない。ここで登場するのがfp8量子化版。精度を落として軽量化したモデルで、RTX 4070 Ti(12GB)でも約6.9GBで動作します。
今回使ったのは flux1-dev-fp8.safetensors(FLUX.1-dev fp8 — Hugging Face)。生成テスト(512×512 / steps=15 / euler sampler)は特に詰まることなく完了しました。
ComfyUI v0.12.3 の新しいUIについて {#ui}
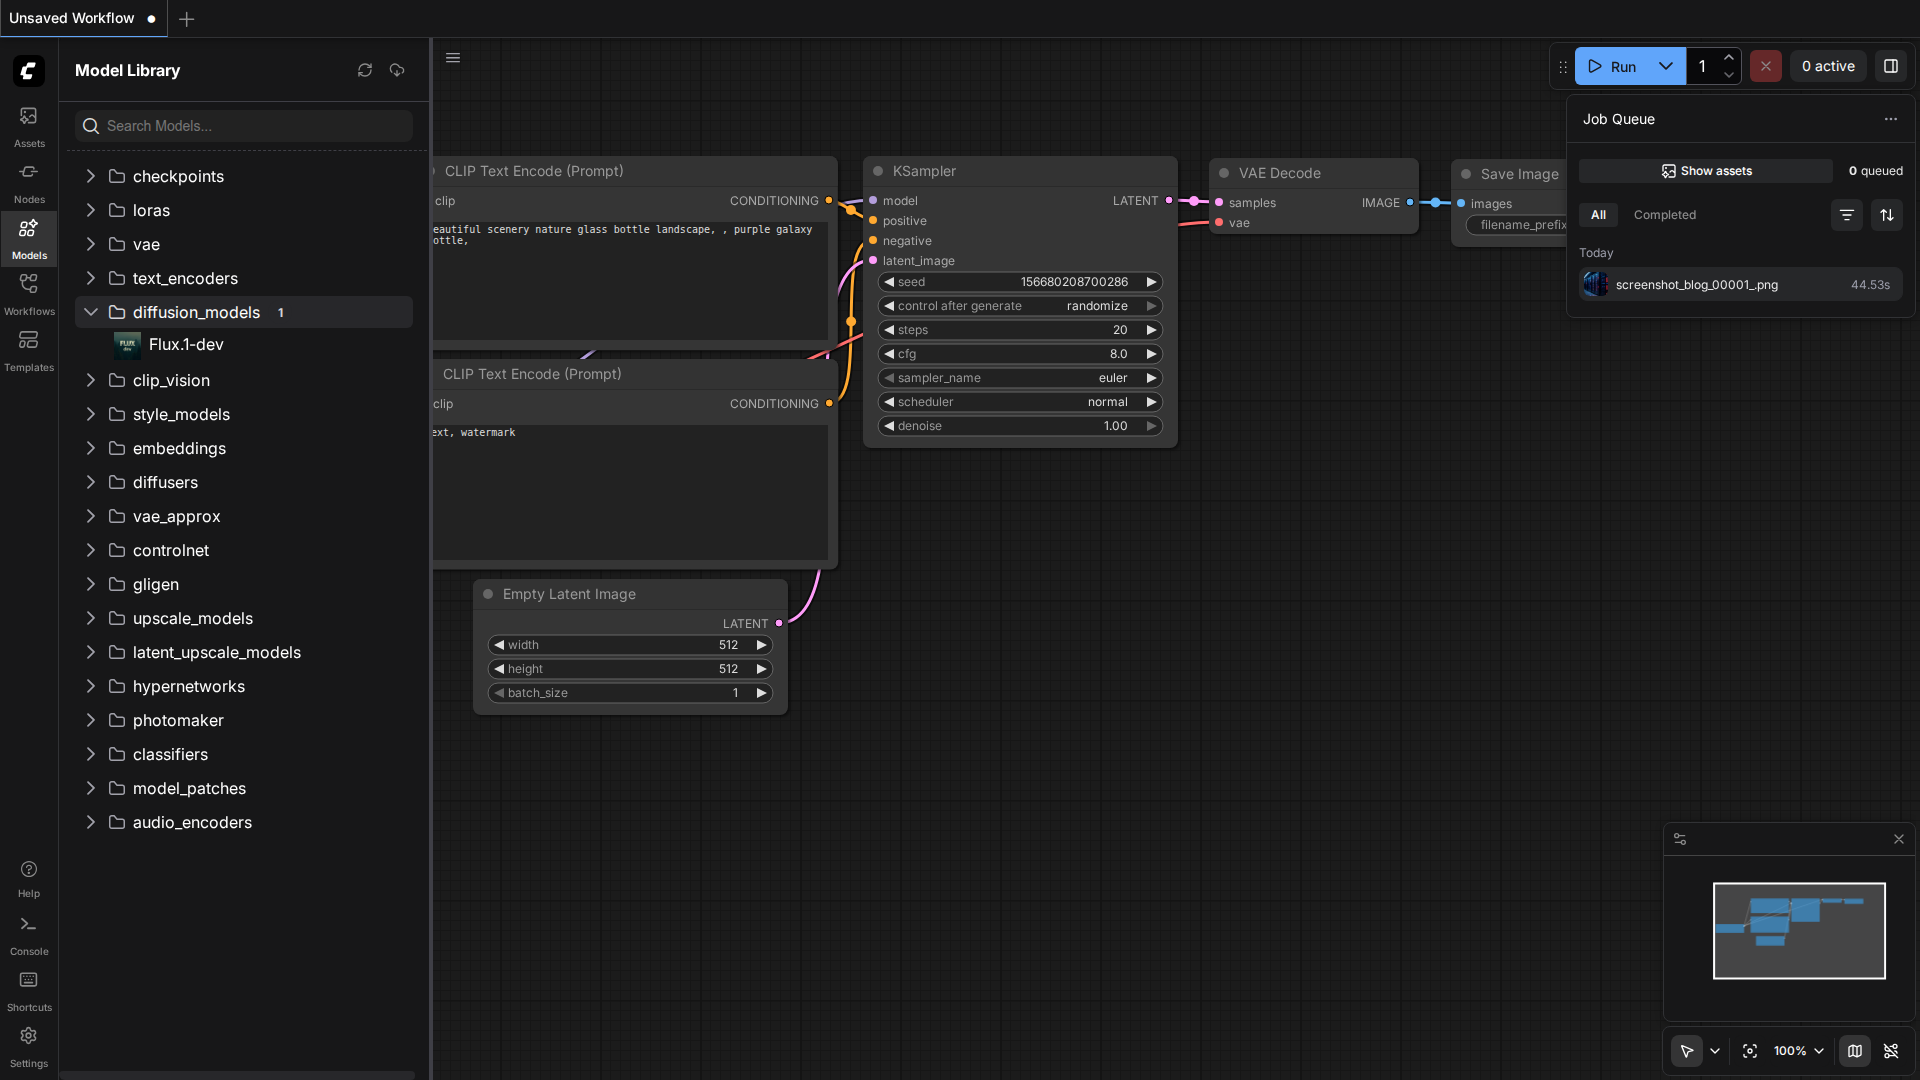
最近のComfyUIはバージョン0.12.x以降でインターフェースが大きく変わっている。新しい左サイドバーが追加され、モデル管理とワークフロー管理が整理された。
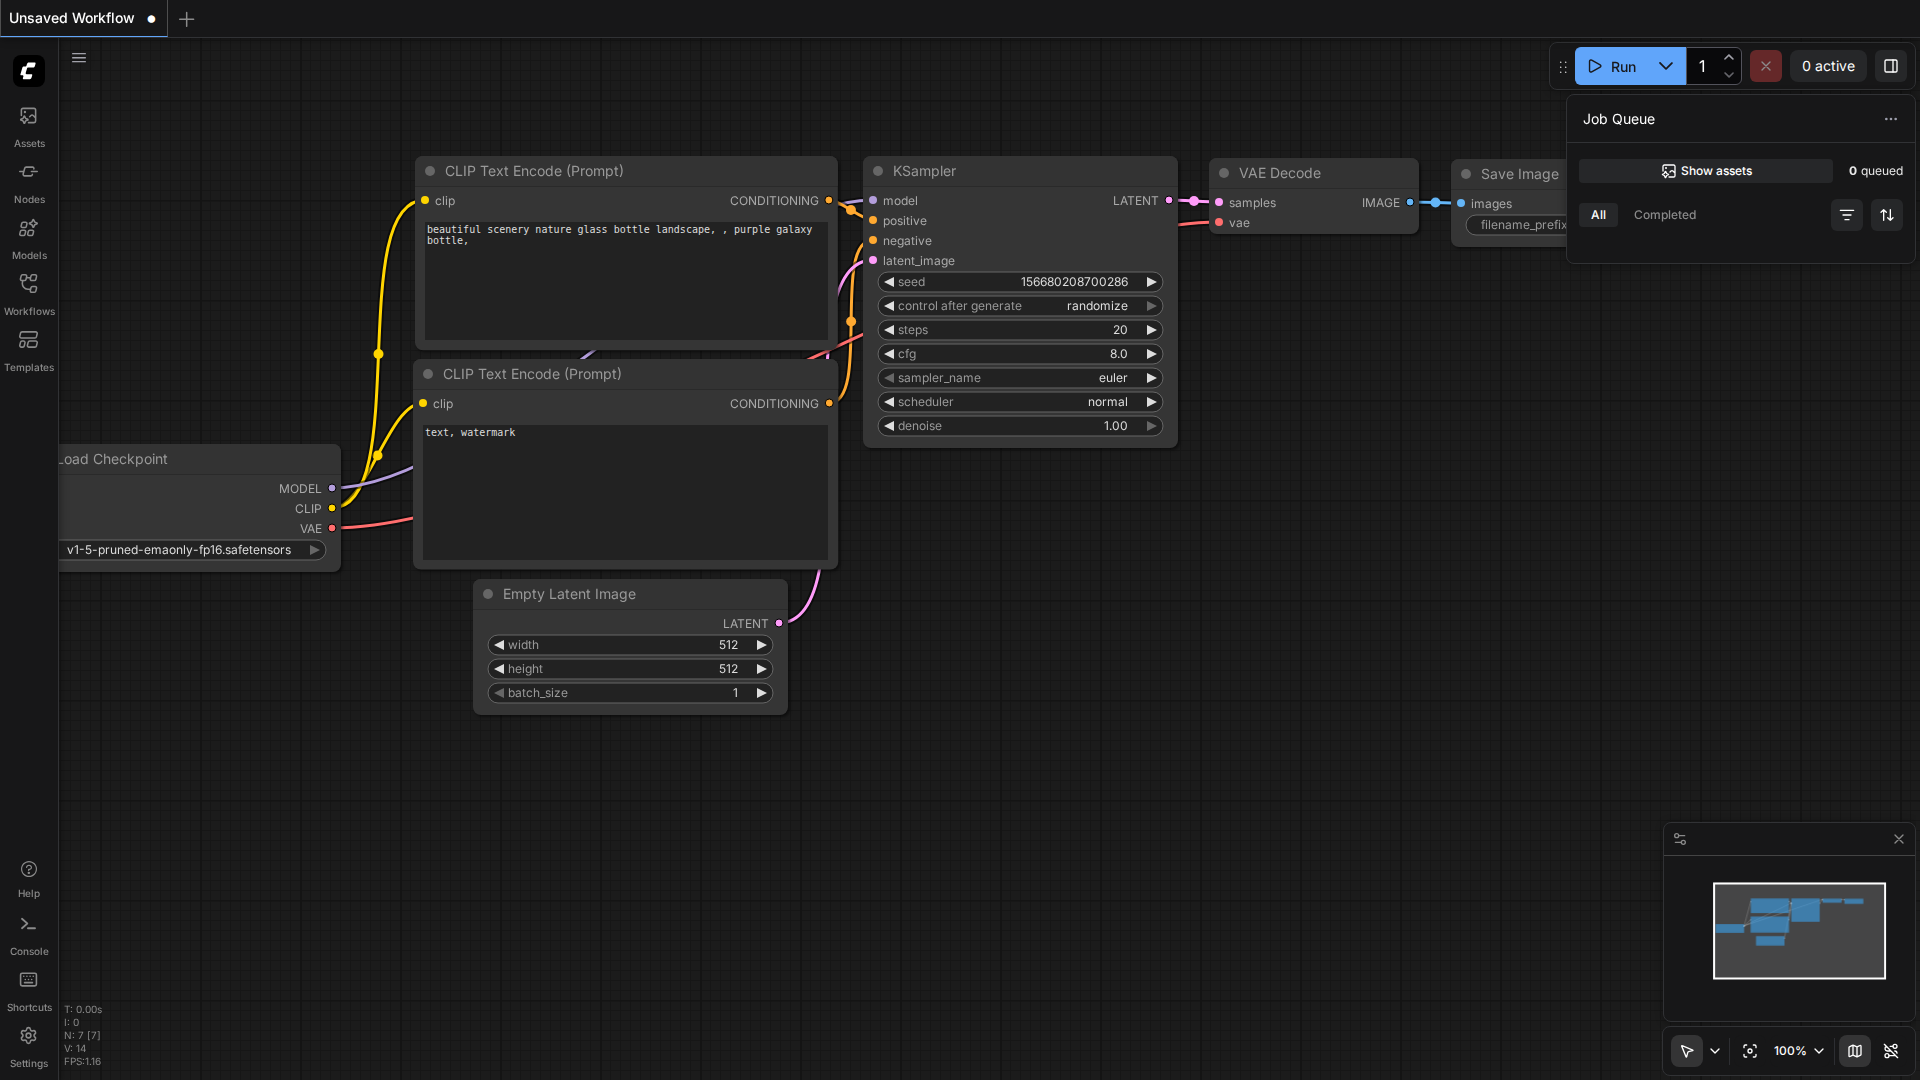
従来の「画面中央に浮かぶUIウィンドウ」から、IDEに近いレイアウトへの変化。Model Libraryパネルからは checkpoints/、loras/、diffusion_models/ といったフォルダが一望でき、モデルの切り替えが以前より格段に楽になった。
ComfyUI vs AUTOMATIC1111の比較記事でも触れたが、ComfyUIの本質はワークフローの自由度にある。何をやっているかが視覚的に見える構造は、慣れると「ブラックボックスで動くWebUI」より信頼できる感覚がある。
ノードエディタの実態 {#node}
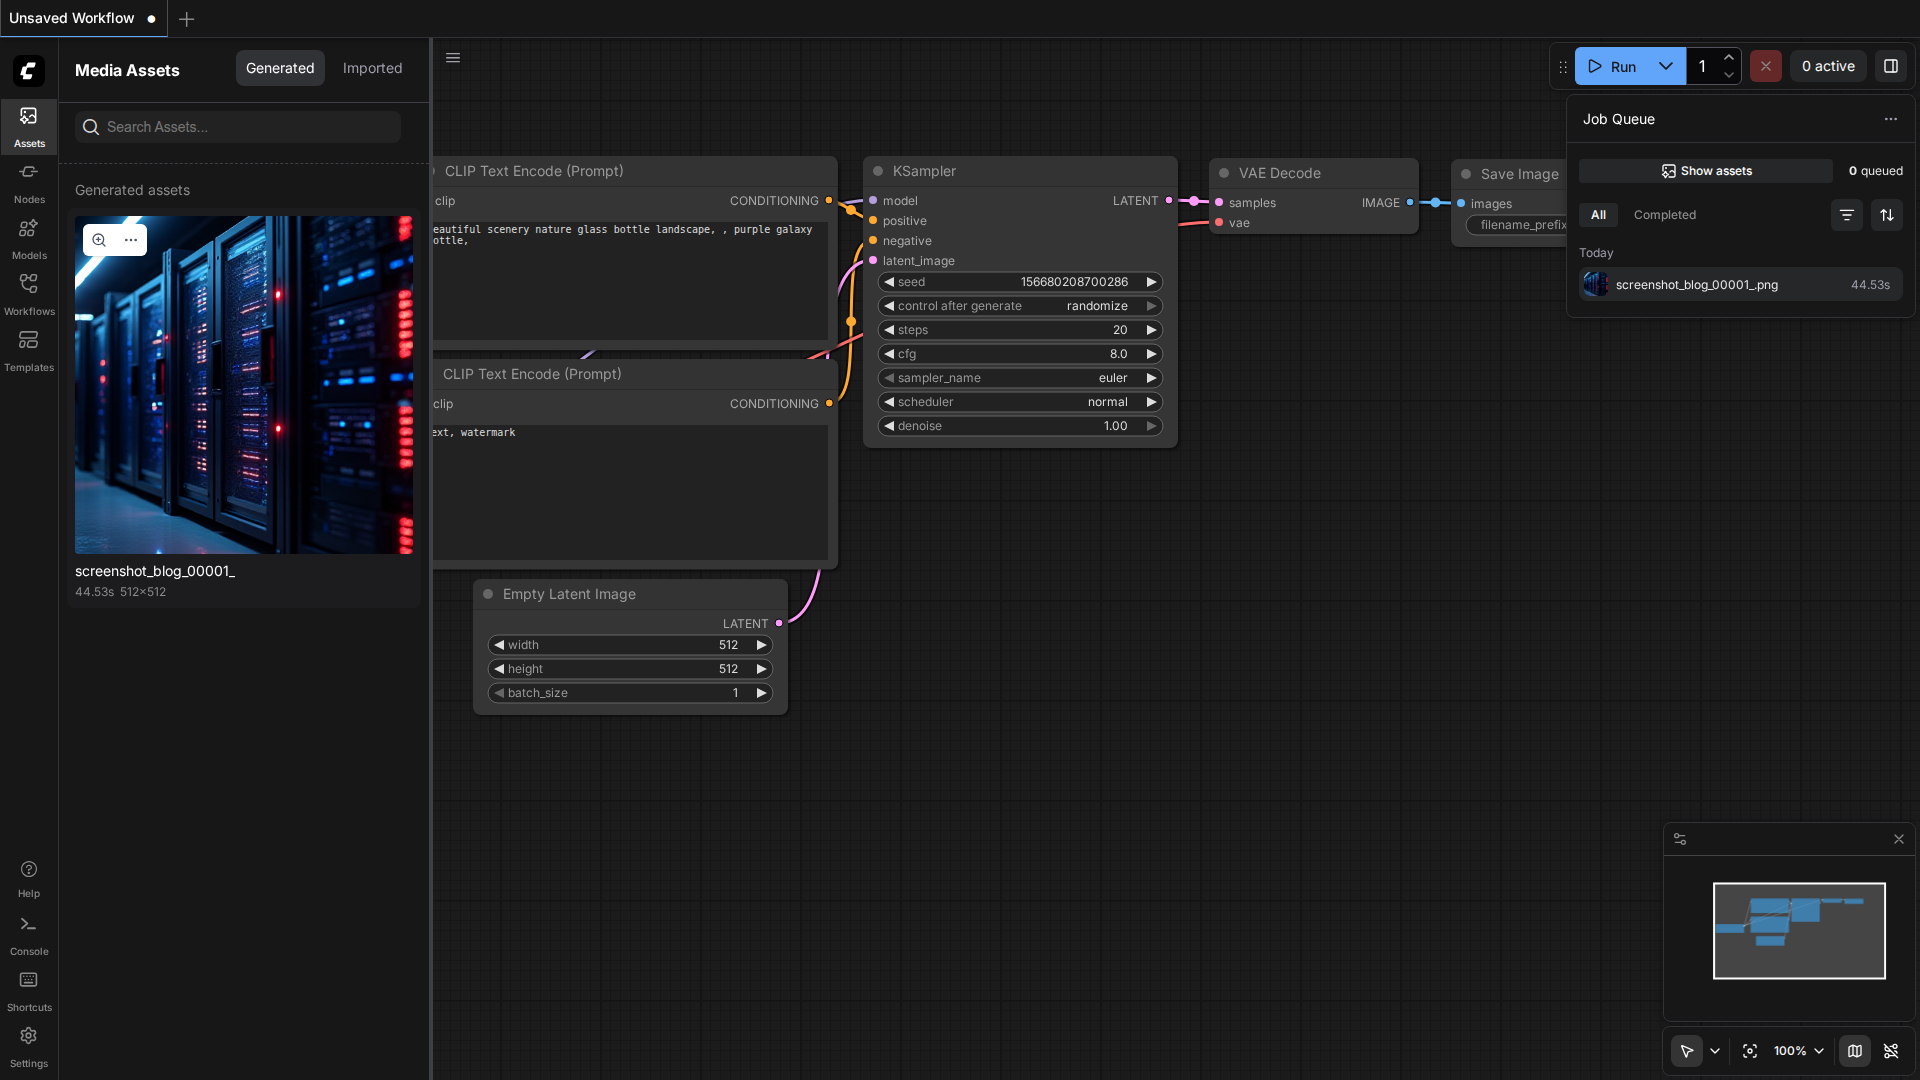
初見だと確かに圧倒される。でも基本的な画像生成ワークフローは、以下のノードで完結します。
- CLIP Text Encode — プロンプト入力
- KSampler — 推論エンジン
- VAE Decode — 潜在空間→画像変換
- Save Image — 出力
これらが線で繋がっているだけ。「CLIPでプロンプトを解釈 → KSamplerで画像の潜在表現を生成 → VAEで画像に変換」という処理の流れが、そのまま目に見える形になっている。
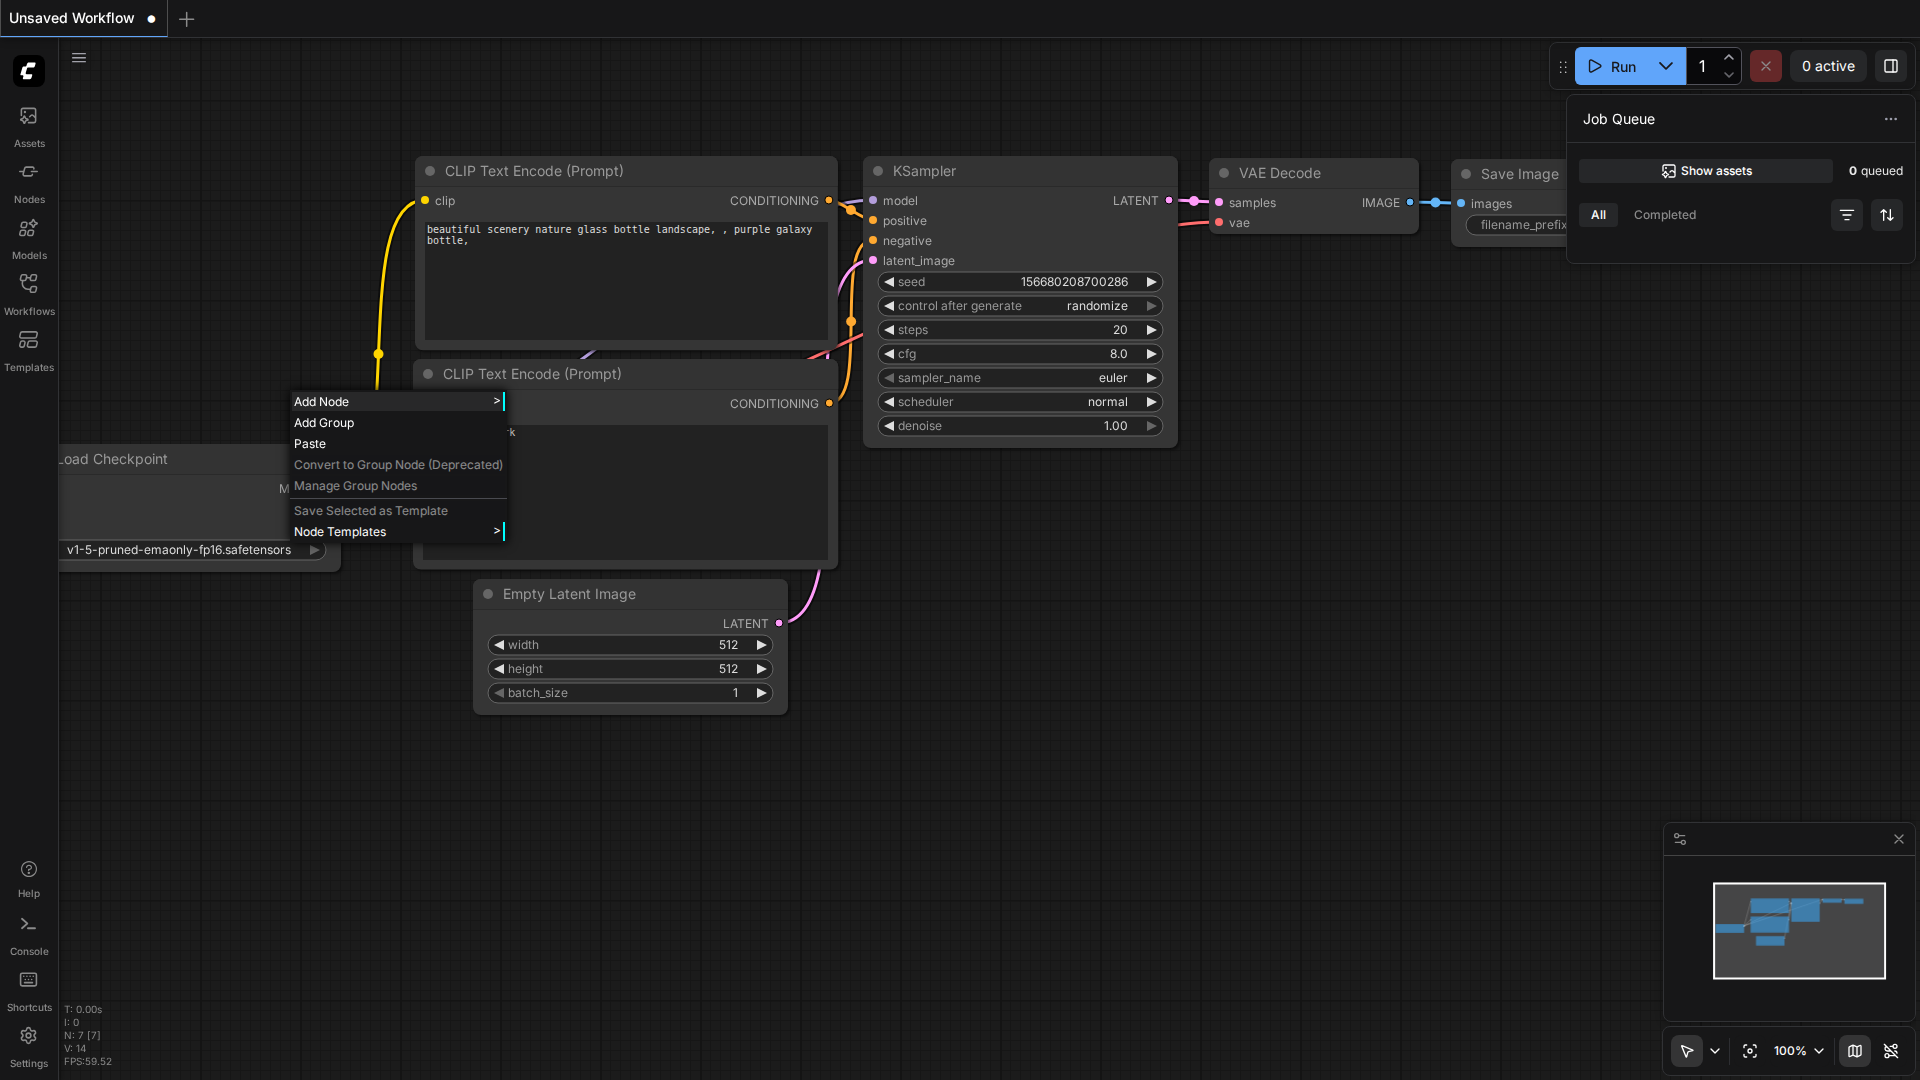
右クリックでノードを追加でき、種類も豊富です。LoRALoRA(低ランク適応)大きな AI モデルの本体はそのままに、小さな追加部品だけを学習させて調整する手法。詳しく →適用、アップスケール、インペイント——それぞれが独立したノードとして存在し、繋ぎ方次第で挙動が変わる。最初は「どこを変えると何が変わるの?」と思いながら動かしていたが、変えた部分だけ結果に反映されるのがわかってくると面白くなってくる。
RTX 4070 Ti 12GBでの実測 {#vram}
nvidia-smiで確認したVRAM使用量は 6,892MiB(12GBのうち約6.9GB)。
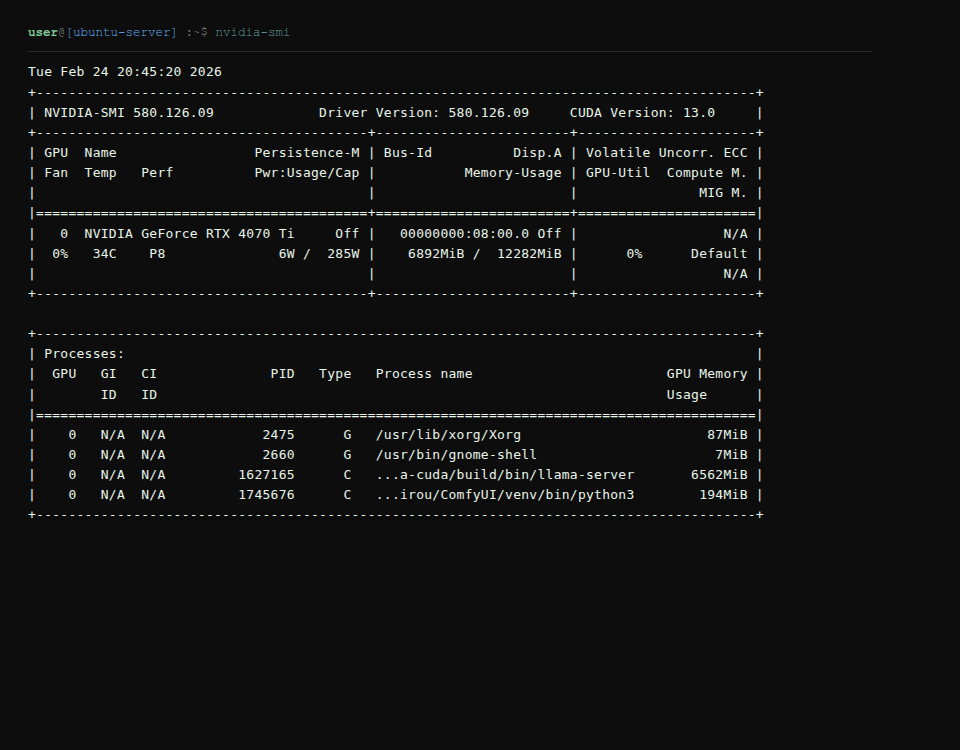
FLUX.1-dev fp8は想定通りの消費量で、残り約5GBの余裕がある。512×512でsteps=15、euler samplerなら1分かからず生成が終わります。
Stable Diffusion VRAMガイドにも書いたとおり、FLUX.1系を快適に動かすには8GB以上が現実的な最低ライン。fp8量子化のおかげでRTX 4060(8GB)から動くが、512×512を超える解像度を扱うなら12GB以上のほうが余裕があります。VRAMが足りるかどうかの判断は GPUランキング のスペック欄が参考になります。
気になった点 {#cons}
ポートが8188固定。Linuxサーバーで他のサービスと共存させる場合、環境変数 COMFYUI_PORT で変えるかNginxでリバースプロキシを噛ませる必要がある。細かい話ではあるが、複数のAIサービスを同居させていると最初に詰まるポイントです。
起動が遅い。モデルをロードして最初のリクエストに応答できる状態になるまで30〜60秒かかる。常時起動前提なら問題ないが、オンデマンドで起動する構成は向いていない。
日本語プロンプトは厳しい。FLUX.1自体が英語プロンプトで訓練されているため、日本語で入れると精度が落ちる。英語で書くか、翻訳を間に挟む運用が基本になります。
よくある質問 {#faq}
RTX 3060(8GB)でも動きますか? FLUX.1-dev fp8は最小8GBから動作します。ただし512×512が実用的な上限で、768×768以上だとVRAM不足でクラッシュする可能性があります。余裕を持って動かすなら12GB以上を推奨します。
SD XLとFLUX.1-dev、どちらが重いですか? FLUX.1-dev fp8(約6.9GB)とSD XL(約6-7GB)はほぼ同等です。ただしFLUX.1はsteps数を減らしても品質が落ちにくいため、生成時間はむしろ短縮できます。
ComfyUIとAUTOMATIC1111はどちらが初心者向けですか? 操作の分かりやすさならA1111ですが、設定の細かい制御はComfyUIが上。最初の画像を出すだけならA1111から入るのも選択肢です。
LoRAは使えますか? 使えます。Model LibraryにLoRAフォルダが表示されており、LoRA Loaderノードを追加して繋げるだけです。
まとめ {#summary}
ComfyUIは「難しいツール」というより「自分でワークフローを設計するツール」だった。最初のセットアップさえ通れば、基本的な画像生成はすんなり動く。FLUX.1-dev fp8なら12GBのGPUで十分実用になります。
解像度を上げたり、LoRAを重ねたりし始めると話は変わってくるが、入門としては悪くない組み合わせだと思う。
ノードエディタの自由度に慣れると、WebUIに戻りづらくなる。処理の全体像が見えている安心感は、使い込むほど効いてくる。AIツールの世界は「便利に隠す方向」と「透明に見せる方向」に分かれていて、ComfyUIは明らかに後者だ。どちらが好きかは人によると思うが、自分は見えているほうが落ち着く。それが正直なところです。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事
RTX 4070 Ti 12GBでMiniMax H3を実測:5秒動画は34.5秒
VRAM 12GB の RTX 4070 Ti で MiniMax H3 の音声付き動画をローカル生成した実測。Fused Turbo int8+SLA+nvfp4 エンコーダで 5 秒動画が 34.5 秒。SLA あり/なし・steps・解像度を同じ seed で切り分けた表と、初回計測の罠・ComfyUI 更新後の起動ループまで。
MiniMax H3、画風検証は後回しでいい?速度差より広告の崩れに注目
RTX 4070 Ti 12GB で MiniMax H3 を使い、同じ構図の架空ビール CM を 3 画風×4 設定=12 本生成した比較。画風が変わっても生成時間はほぼ同じ、仕上がりは 3D アニメが最も安定。文字のないラベルに偽の文字が生える落とし穴と、音の指示の勘所まで。

MiniMax H3はつなぎ目が飛ぶのに直せる——同seedで構図維持
RTX 4070 Ti 12GB で MiniMax H3 の動画を 40 秒まで延ばした実測。1 本の上限 15 秒を続きを生成する追加ノードでつなぎ、つなぎ目の構図飛びは同じ seed のまま指示文 2 行で解消、スワップ枯渇は区間を分けて回避した。

Ollama実測:RTX 3060 31.84、RTX 5090 94.18t/s
Ollamaを同一条件で実測。RTX 3060から5090までのtokens/s、VRAM不足による速度低下、予算別の選び方を整理します。
関連AIツール
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:GPU・キャリアまわりのサービス
 OZ GAMINGの構成を見る
 strategy career の転職支援を見る