MiniMax H3はつなぎ目が飛ぶのに直せる——同seedで構図維持
RTX 4070 Ti 12GB で MiniMax H3 の動画を 40 秒まで延ばした実測。1 本の上限 15 秒を続きを生成する追加ノードでつなぎ、つなぎ目の構図飛びは同じ seed のまま指示文 2 行で解消、スワップ枯渇は区間を分けて回避した。

こんにちは。朝晩がようやく涼しくなって、GPU を長く回しても部屋が暑くなりにくい季節になってきましたね。
MiniMax H3(音声付きの動画を作れる AI)で、RTX 4070 Ti(VRAMVRAMグラフィックボードに載っている、GPU 専用の高速なメモリ。詳しく → 12GB)の自宅 GPU でも 40 秒の動画は作れました。しかも思った以上に実用的でした。 ただ、そこまでに壁が 2 つありました。つなぎ目で場面が飛ぶことと、メモリが尽きることです。前者は乱数の種(seed)を変えずに、指示文を 2 行足し、引き継ぐコマを増やすことで直り、後者は区間を分けて作ることで避けられました。
Part1 では 5 秒の音声付き動画が 1 本 35 秒前後で作れること、Part2 では画風を変えても速度がほぼ変わらないことを確かめました。今回は「長さ」です。「どこかのパラメータを変えると 40 秒もいける」という話を聞いて、12GB でどこまで伸ばせるかを試しています。
1 本で作れるのは 15 秒まで。限界は GPU ではなくメインメモリだった
まず、1 回の生成でどこまで長くできるか。H3 の学習範囲は 124〜362 コマ(24fps で約 5〜15 秒)です。ComfyUI(ノードをつないで生成の流れを組むソフト)の設定ではもっと長い値も入力できますが、15 秒を超える長さは学習されておらず、品質の保証がありません。
そこで、学習範囲の中で長さを変えて測りました(SLA あり・4 steps・音声付き)。
| 長さ | 解像度 | 生成時間 | 予備メモリ(スワップ)の最大 |
|---|---|---|---|
| 5 秒 | 960×544 | 約 35 秒 | 約 5GB |
| 10 秒 | 960×544 | 89 秒 | 5.1GB |
| 15 秒 | 960×544 | 139 秒 | 6.4GB |
| 10 秒 | 1152×640 | 132 秒 | 6.2GB |
15 秒でも破綻しませんでした。「カップを持ち上げる → 置く → カウンターを拭く → 手を振る」という 4 つの動作を、最後まで順番どおりにこなしています。生成時間は長さにほぼ比例して延び、15 秒で約 2 分 20 秒です。
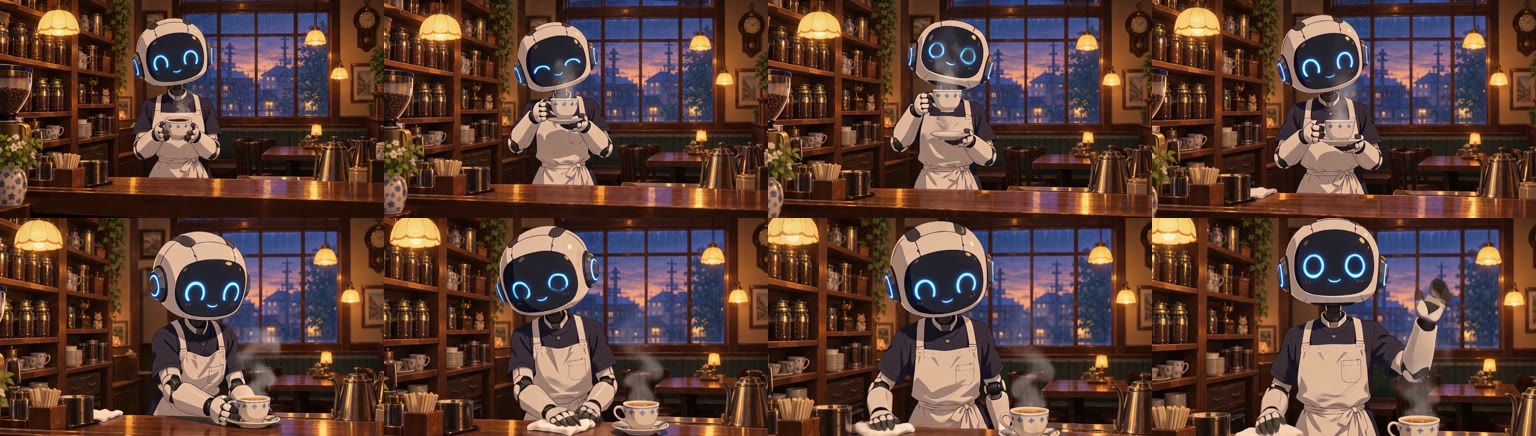
1 回で作った 15 秒(960×544・生成 139 秒)
測っていて見えてきたのは、12GB の機械の本当の限界は、GPU のメモリではなくメインメモリだ ということです。VRAM はどの長さでも約 11.7GB で頭打ちになります。ComfyUI が、GPU に載りきらないぶんをメインメモリへ逃がすからです。その結果、メインメモリ 32GB に加えて、SSD 上の予備メモリ(スワップ 8GB)まで使い込んでいきます。15 秒の時点で、スワップは 8GB 中 6.4GB 埋まっていました。ここが後で効いてきます。
「パラメータで 40 秒」の正体は、続きを作る追加ノードだった
では、40 秒はどうやって作るのか。調べてみると、長さの設定を 40 秒にする話ではありませんでした。正体は、有志が作った「続きを生成する」追加ノード です。
使ったのは MiniMax H3 Video Extend(kat3ri 氏作)。前の動画の最後の数コマを「直前の時間」として新しい動画に引き継ぎ、その続きを生成します。前の動画の最後の 1 コマを画像として渡して続きを作る方法(I2V のつなぎ)もありますが、それよりも動きや音が自然につながる、というのが作者の説明です。
このノードは、ComfyUI 本体の一部を起動時にメモリ上で書き換えて動きます。第三者のプログラムを入れることになるので、中身を読み、外部との通信やコマンド実行がないことを確かめてから導入しました。作者自身も「実物での検証はまだ」と書いているので、結果は目で確かめる前提です。
作り方は「15 秒 → 続きを 15 秒 → さらに続きを 10 秒」で、合計 40.27 秒。3 つの区間には、それぞれ別の動作を指示しました。
- カップを持ち上げて、飲むふりをする
- カップを置き、布でカウンターを拭く
- 布をしまい、カメラに手を振ってお辞儀する
1 回目:40 秒はできたが、15 秒のつなぎ目で場面が飛んだ
1 回目は、3 区間を 1 つのワークフローで続けて生成しました。所要時間は 380 秒(約 6 分半)。メモリ不足で止まることもなく、40 秒の音声付き動画ができあがりました。スワップは 8GB 中 7.2GB と、ほぼ限界です。
ところが、見てみると問題がありました。2 つ目のつなぎ目(25 秒付近)は滑らかです。しかし 1 つ目のつなぎ目(15 秒付近)では、顔の寄りの画から、数コマで引きの画に切り替わっていました。 窓の形やコーヒーマシンなど、店内の様子まで変わっています。編集で場面を切り替えたように見えるんですよね。
原因は、2 区間目の指示に「カウンターを拭く」という別の動作と場面の説明を入れたことだと考えました。モデルが、そこで構図を作り直してしまったわけです。
2 回目:同じ seed のまま指示を 2 行足したら、構図が保たれた
そこで、seed は 1 回目と同じにしたまま、次の 2 点だけを変えました。
- 2 区間目以降の指示を「Continuing the same shot:(同じカットの続き)」で始め、末尾に「同じ寄りの構図・同じロボット・同じ店内のまま、1 カットで、切り替えなし」と明記した
- 引き継ぐコマの量(context_frames)を 2 から 4 に増やした
結果ははっきりしていました。1 つ目のつなぎ目でも、寄りの構図と店内がそのまま保たれ、カップを置いて拭く動作へ自然に続いています。つなぎ目の破綻は、パラメータより指示文で直る部分が大きい。これが今回いちばんの収穫です。
1 回目(左)と 2 回目(右)を、40 秒まるごと左右に並べた動画です。15 秒付近で、左だけ画面が引きに切り替わります。
動画を再生できない環境向けに、つなぎ目の前後のコマも並べておきます。
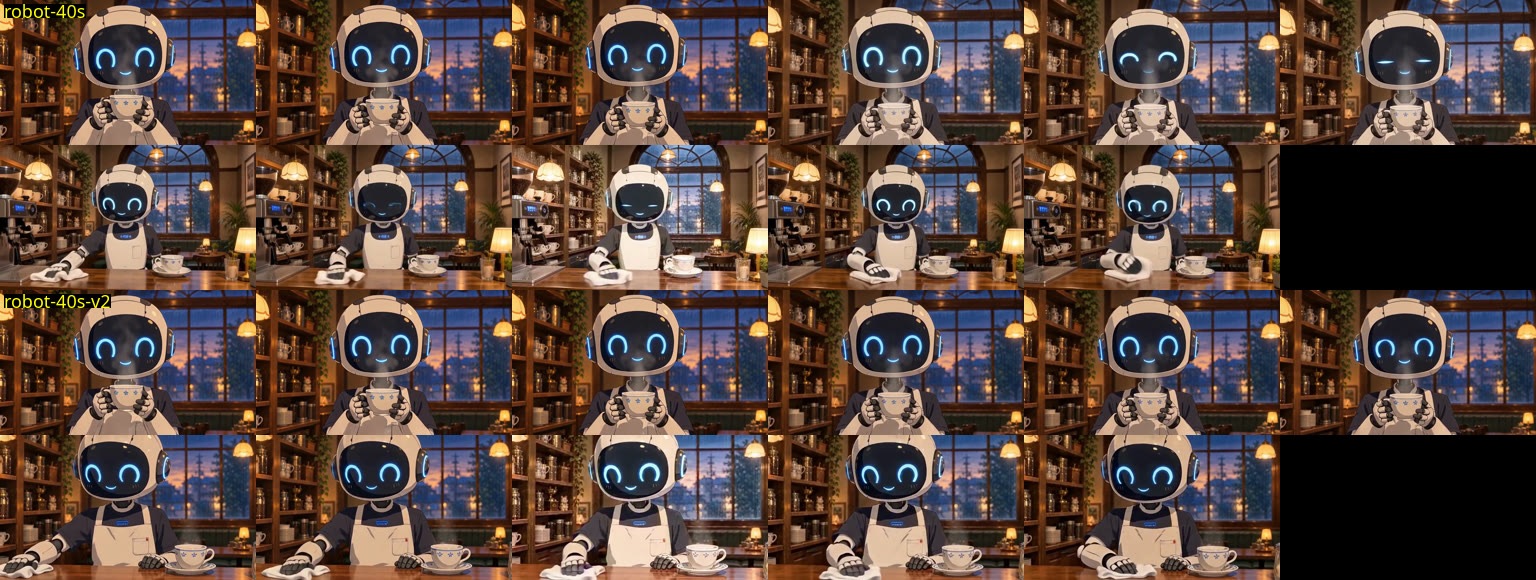
15 秒・25 秒付近のつなぎ目前後のコマ(上 2 段:1 回目/下 2 段:2 回目)
もう 1 つの壁:スワップが尽きたので、区間を分けて作った
ただ、2 回目では別の壁に当たりました。引き継ぐコマを増やしたぶんメモリの使用量が増え、3 区間目の途中で、スワップ 8GB を使い切った のです。
こうなるのを見越して、スワップの使用量が 7.7GB を超えたら生成を自動で止める見張り役を横で動かしていました。これが働いて処理は止まり、マシンにも異常は出ていません。1・2 区間目の動画も保存できていました。
そこで作り方を変えました。3 区間目だけを、ComfyUI を再起動したまっさらな状態で、別に生成する 方式です。2 区間目の最後の 5 秒(124 コマ)を切り出して読み込ませ、その続きを作ります。この追加ノードには、既存の動画を読み込んで引き継ぐための変換ノードも用意されています。3 区間目は 125 秒で完成し、スワップの最大は 6.3GB に収まりました。
区間ごとにメモリがリセットされるので、この方式なら 40 秒を超えて延ばすことも可能 です。目安は、15 秒の区間 1 つあたり 2〜2.5 分。40 秒なら全体で約 6〜7 分でした。
長くしたい方向けに、今回の手順で効いたことを並べておきます。
- 1 本の上限は 15 秒。それを超える長さは、続きを生成する追加ノードでつなぐ
- 2 区間目以降の指示は「同じカットの続き」で始め、構図・人物・場所を保つよう明記する
- 引き継ぐコマを指示文と合わせて増やすとつながりは良くなったが、メモリの使用量も増える
- 12GB 機ではスワップを見張り、足りなくなりそうなら区間ごとに分けて生成する
音も一緒に。完成した 40 秒
完成した 40 秒(2 回目)の動画です。H3 は映像と同時に音も生成します。各区間の指示には「カフェのジャズと雨音」を入れました。つなぎ目で音がどう聞こえるか、ぜひ耳で確かめてみてください。
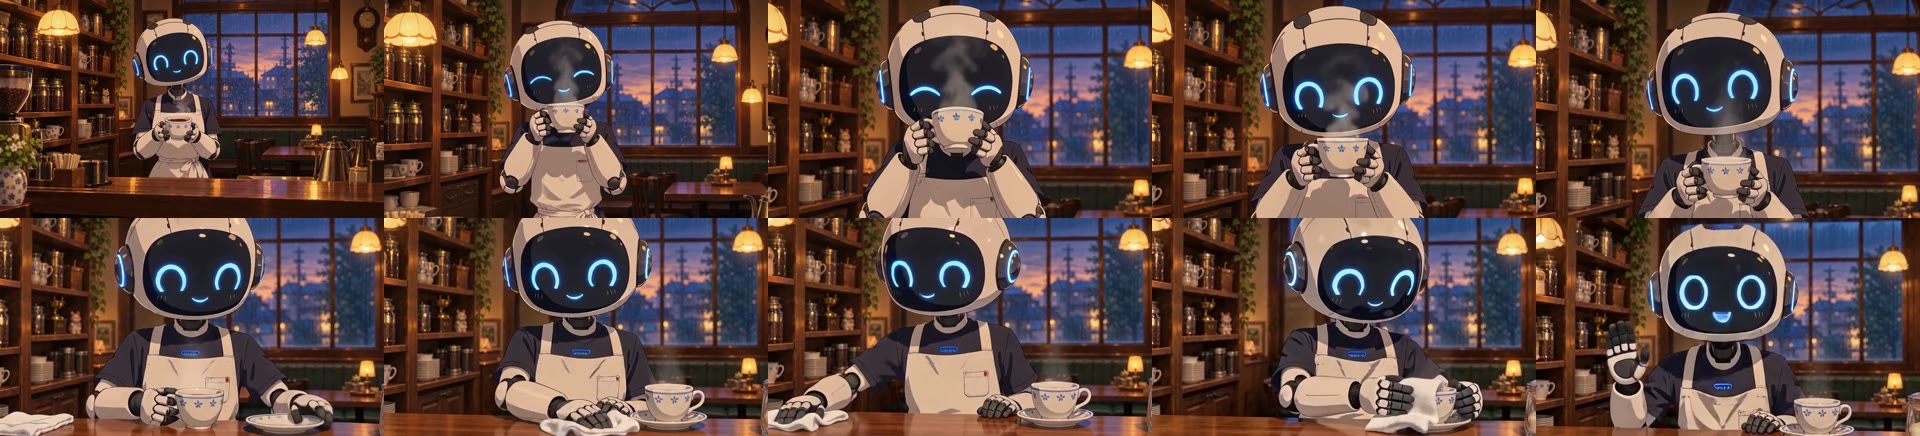
完成した 40 秒(2 回目)の 4 秒おきのコマ
正直なところ、始める前は「40 秒なんて、つなぎ目だらけで使い物にならないだろう」と思っていました。実際には、指示を少し工夫するだけで 1 カットの長回しに見える 40 秒になっています。思った以上に実用的 です。短い CM や SNS 向けの動画なら、12GB の自宅 GPU で十分に作れる時代になったと感じます。
この記事の動画は、すべて MiniMax H3 で AI 生成したものです(元の静止画も画像生成 AI で作ったオリジナルです)。Powered by MiniMax H3.
検証日・環境
- 検証日:2026-09-24
- GPU:NVIDIA GeForce RTX 4070 Ti(12GB)/メインメモリ 32GB+スワップ 8GB/Ubuntu 24.04
- ComfyUI 0.37.0/PyTorch 2.14.0+cu130
- モデル:Fused Turbo int8(MATLOWAI)+ Qwen3-VL-32B nvfp4 テキストエンコーダ+映像 VAE int8+音声 VAE fp32
- SLA:H3 SLA Attention ノード(sparsity 0.90・block 64)
- 延長:ComfyUI-MiniMax-H3-Extend(MiniMaxH3VideoExtendPatched)
- 生成条件:I2V・960×544・4 steps・seed 42/43/44(区間ごと)
出典
- kat3ri/ComfyUI-MiniMax-H3-Extend(GitHub)
- ComfyUI MiniMax H3 Video Generation Guide
- I want to make longer videos! How many seconds can the MiniMax H3 be extended?(AICU)
- vllm-omni: MiniMax-H3 sliding-window generation for videos longer than 15 s
- MiniMaxAI/MiniMax-H3(Hugging Face)
- MATLOWAI/minimax-h3-fused-turbo-int8-convrot(Hugging Face)
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。

関連記事

ComfyUI + FLUX.1-devでローカル画像生成——ノードエディタは難しいのか検証
RTX 4070 Ti(12GB)にComfyUI v0.12.3 + FLUX.1-dev fp8を入れて実際に画像生成。VRAM実測6.9GB、ノードエディタの構造、fp8量子化の選び方まで正直に記録。
RTX 4070 Tiで72秒の紹介動画を自作:クラウド代は声の約3円だけ
RTX 4070 Ti(VRAM 12GB)の自宅 PC で、複製した自分の声と MiniMax H3・WhisperX・ACE-Step・Remotion を順に回し、72秒の紹介動画を作った実践記録。工程ごとの所要時間と費用(クラウド代は声の約3円)、字幕を誤字ゼロにする方法、書き出しが止まる罠、映像が暗いなど一発出しで残った課題まで。

RTX 4070 Ti 自宅サーバーに Qwen3-TTS を入れた実録 — API変更で3回詰まった話
自宅の RTX 4070 Ti に Qwen3-TTS をデプロイした記録。クラス名・メソッド名・戻り値の形式が全部変わっていて3回詰まった。同じ罠に落ちる人が減るよう全部書く。

Qwen3-TTS に声クローン機能を追加した話 — Gradio UI・自分の声で TTS・ハマり全記録
自宅 RTX 4070 Ti の Qwen3-TTS に Gradio UI と声クローンを追加した記録。モデルの種類の罠・64KB制限・VoiceClonePromptItemの落とし穴・Gradio初期化順序まで、5件のハマりを全部書く。