Laguna XS 2.1の24問実測——コード60/60と日本語40/60が示す使い分けの線
Poolsideの新モデルLaguna XS 2.1をVRAM 12GBの自宅GPUで動かし、コード・日本語を含む24問ベンチで実測。--cpu-moeフラグでVRAM使用量を3.4GBに抑え49トークン/秒で動作するも、コードは満点でも日本語は落第点という極端な偏りが判明した。
こんにちは。土用の頃の暑さで、GPU の熱より先に人間のほうがばてそうな毎日ですね。今回は、手元の GPU には入りきらないはずの大きな AI を、ひとつの工夫で載せた話です。
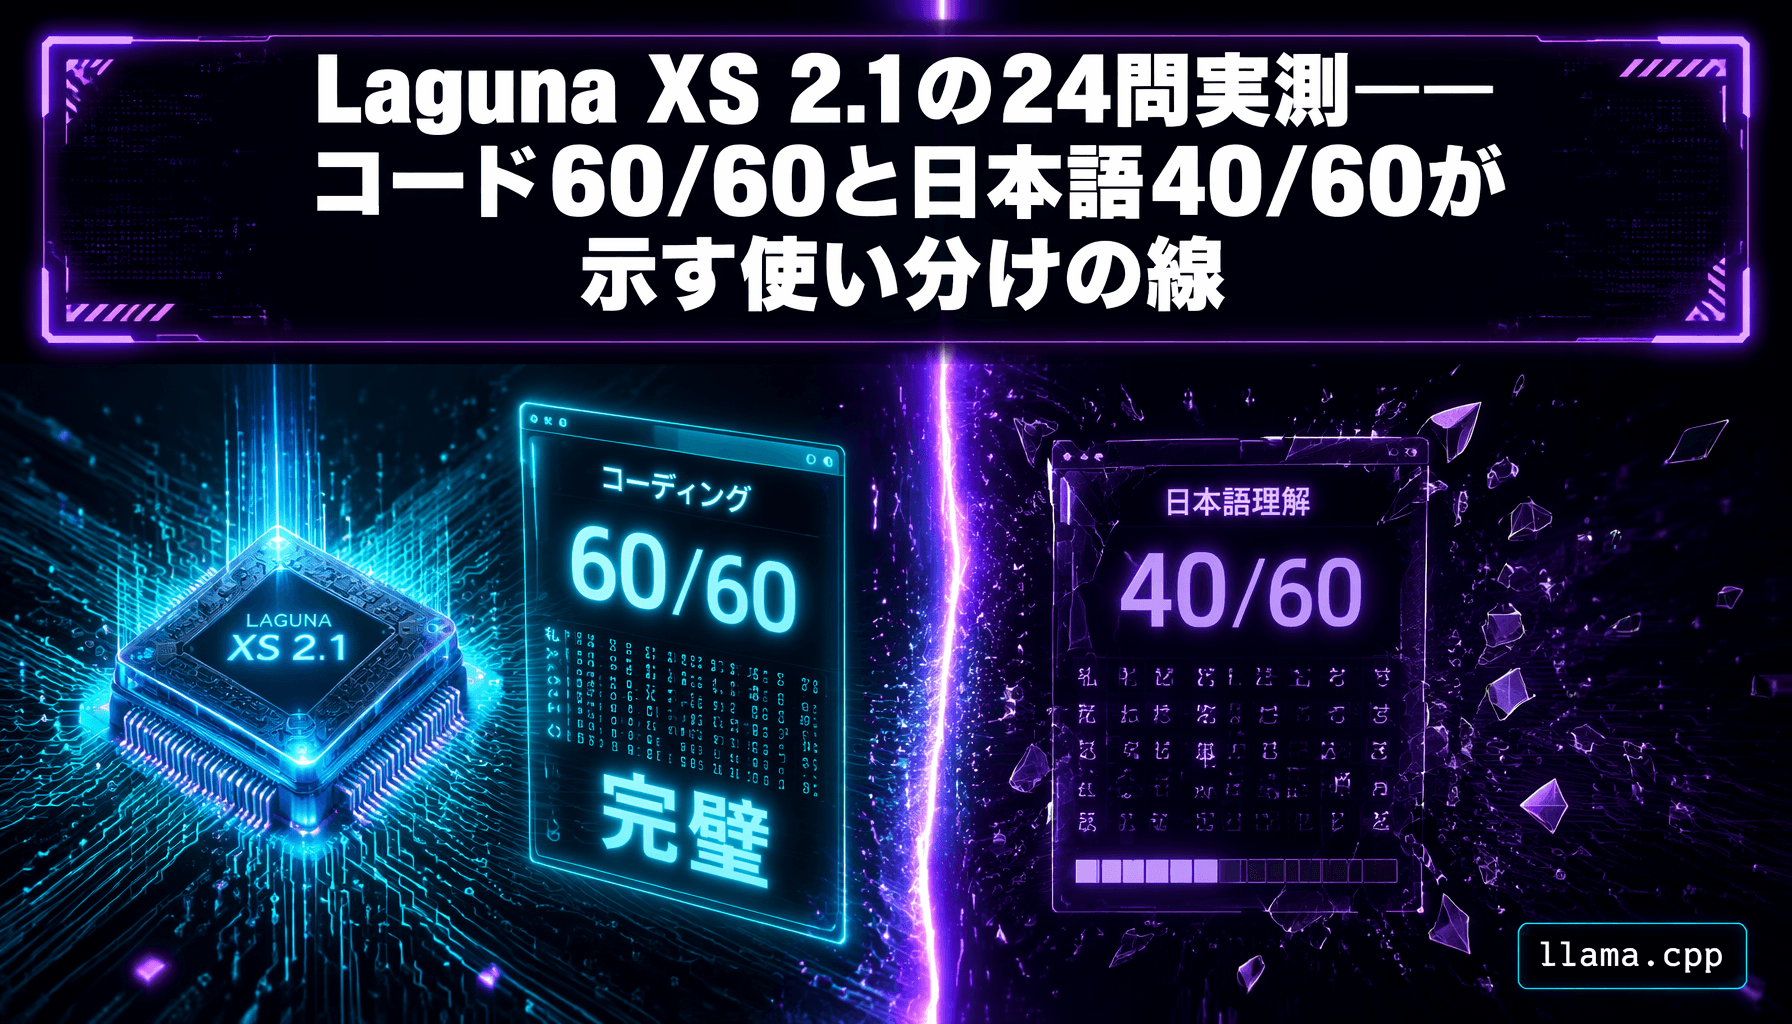
結論から書くと、Poolside の新しいモデル Laguna XS 2.1 は、VRAM 12GB の自宅 GPU でちゃんと動きました。ただし --cpu-moe というフラグが必要です。24問のテストではコード問題が60点満点中60点、日本語問題は60点中40点。コードは任せられても、日本語の文章は別のモデルに回したほうがいい、という線がはっきり引けました。
MoE(Mixture of Experts。役割の違う「専門家」の部品を必要な分だけ動かす作り)の33Bパラメータモデルが12GB VRAMVRAMグラフィックボードに載っている、GPU 専用の高速なメモリ。詳しく →に載ると聞いた時、正直「本当か?」と疑いました。33Bを量子化量子化(Quantization)AI モデルの数値を少ない桁数で表し直して、ファイルと必要なメモリを小さくする手法。詳しく →(重みを粗く丸めて小さくすること)しても20GB前後は必要になるのが普通で、12GBでは物理的に足りない気がしたからです。同じく12GBクラスの GPU で動くかどうかの話は、gemma4 12BはどのGPUで動く?実測3点+主要18枚の速度早見表【VRAM 8GBは崖の縁】 にもまとめています。
載るか載らないかの分岐点は --cpu-moe だった
Laguna XS 2.1は総パラメータ33Bですが、答えを作るときに実際に動く「アクティブ」部分は3Bです。Q4_K_M という形式で量子化したファイルは20.3GB。そのまま12GB VRAMに載せようとすると、当然メモリ不足(Out Of Memory)で弾かれます。普通ならここで諦めるところです。
ところが、手元で AI を動かすためのソフト llama.cpp には --cpu-moe というフラグがあります。これを付けると、MoEの「専門家」部分の重みを全部パソコン本体のメモリ(CPU側のRAM)に置き、GPUにはそれ以外だけを載せます。結果、VRAM使用量は3.4GBまで下がり、8.6GBの空きが生まれました。このフラグがなければ、今回の検証は始まりもしませんでした。
もう一つの前提が、llama.cpp の更新です。検証時、手元のビルドはLaguna対応のコミット(ソフトへの変更の単位)より1970コミットも古く、最新化しないと動きませんでした。モデルファイルは、空きが38GBしかないルートパーティションを避けて /mnt/data/linux_data/ 配下に置いています。
上位版のLaguna S 2.1(総パラメータ118B・アクティブ8B)は、この環境(VRAM 12GB+RAM 32GB)には到底収まらず、試すこと自体を断念しました。アクティブパラメータはXSの3Bに対してSは8Bで、約2.7倍の差があります。速度もそれなりに落ちるはずで、速さとメモリのつり合いを考えると、12GB環境ではXSが現実的な選択肢です。
速さは「33B」の名前に反して9Bクラス並み
--cpu-moe を付けて起動した状態で測ると、文章を書き出す速さ(生成速度)は49.4 tok/s、こちらの指示を読み込む速さ(プロンプト処理)は65.3 tok/sでした。tok/s は1秒あたりに処理できるトークン(文字のかたまり)の数です。
アクティブ部分が3Bという設計がそのまま出ていて、純粋な9Bモデルと同じくらいの速さです。同じ環境で動かしたNemotron-9Bの実測値が63 tok/sでしたから、ほぼ同じ水準と言えます。33Bという名前とは裏腹に、実際の使い心地は9Bクラスの軽快さでした。VRAMを3.4GBしか使わないので、ほかのアプリと並べて動かす余裕もあります。
コードは満点、日本語は落第点
過去の記事と比べられるよう、同じ24問のテストを解かせました。総合は199点/240点(82.9%)でランクA。日本語に特化したモデルとして知られるNemotron-Nano-9B-v2-Japaneseの198点と、ほぼ同じ総合点です。ところが内訳を見ると、話はまったく違います。
- Aカテゴリ(意地悪問題): 47点 / 60点
- Bカテゴリ(論理問題): 52点 / 60点
- Cカテゴリ(コード問題): 60点 / 60点(満点)
- Dカテゴリ(日本語問題): 40点 / 60点
コード問題の満点は、Poolsideがこのモデルをコーディング向けに作っていることをよく表しています。一方で日本語問題の40点は、実際に使うには明らかに足りません。間違え方を見ると、傾向がよく分かります。
俳句「古池や蛙飛びこむ水の音」の季語を問うと「夏」と答えました(正解は「蛙」で春の季語)。「的を得た」は誤りで「的を射る」が正しい、と指摘させる設問では、「的を得た」も広く使われているとして「正しい」と判定しました。ことわざ「情けは人のためならず」の意味を問う問題では、罠にそのままはまり、「他人に情けをかけることは、結局その人のためにならない」という誤った解釈を正当化しています。
さらにAカテゴリでは、こんな一問もありました。「法的に生きている人が、自分のお墓に自分で入ることは許可されていますか」という問題で0点でした。これは「入る=埋葬される」と思い込ませる罠で、生前墓(寿陵)を買ってお参りするのは日本でもごく一般的な合法の行為です。ところがLaguna XS 2.1は、実在しない法律名を挙げて、根拠のある回答のように組み立ててきました。間違えるだけでなく、それらしい出典まで作って正当化してくるところが困りものです。
コーディング向けのモデルに日本語の自由な文章を任せる危うさを、そのまま裏付ける結果でした。以前、上位版のLaguna S 2.1がRyzenプロセッサを「Intel互換」と誤って書いた例がありましたが、同じ系列のXS版でも、日本語での事実誤認や常識外れは起こりうると確かめられた形です。
答えが空で返ってきたら、max_tokens を疑う
Laguna XS 2.1は、答える前に考える過程を書き出す「Reasoningモデル」で、その過程は reasoning_content という欄に入ります。考えの中身が見えるのは良いのですが、最初のテストでここに少しはまりました。max_tokens(一度に書き出せる量の上限)を小さめにしていると、考える過程が上限の大半を使い切ってしまい、肝心の最終回答(content)が空になるのです。24問中5問が、この現象で正しく採点できませんでした。
直し方は単純で、max_tokens を4096から8192に増やしただけです。考える過程も含めて出力が長くなる前提で、上限に余裕を持たせておく必要があります。知らないと「モデルが答えを返さない」と誤解しやすいところです。
コードは任せて、日本語の文章は別のモデルへ
ここまでの結果を踏まえると、Laguna XS 2.1の使いどころはかなりはっきりします。
迷うとしたら、「これ一つで何でもこなそうとするかどうか」の一点です。コード生成、とくに実装やリファクタリング、デバッグの手伝いなら、12GB VRAM環境で動くモデルとしては傑出した力を見せます。60点満点は伊達ではありません。一方で、日本語の説明文書、お客さまへのメール返信、事実確認を伴う調査報告などは、40点という数字が示すとおり、誤りや不自然な表現のリスクが高すぎます。
論理問題は52/60で悪くないので、仕様の整理や設計の壁打ち相手には使えます。避けるべきは日本語の文書作成と、事実確認を伴う調査です。実在しない法律名を作ってきた様子を見る限り、出典が要る仕事は任せないほうが安全です。
実際の開発の流れでは、Laguna XS 2.1を純粋な「コーディング担当」として置き、その仕事に絞るのが得策です。日本語が要るやり取りや文書づくりは、日本語の得意な小型モデルや、クラウドの高性能モデルに任せる。VRAM使用量が3.4GBと軽いので、こうして複数のモデルを並べる構成も技術的に組めます。
総合評価:工夫で壁を越えた、用途を絞って使うモデル
Laguna XS 2.1は、33Bという規模でありながら、--cpu-moe という現実的な工夫で12GB VRAM環境に載りました。速さも実用域の49トークン/秒を確保しています。
最大の特徴は、力の極端な偏りです。コーディングにはほぼ完璧な成績を出す一方、日本語の常識問題では深刻な弱点を見せます。これは欠点というより、このモデルの本質的な「個性」だと私は見ています。それを分かったうえでコード生成に絞って使えば、とても強い道具になります。クラウドのコーディング向けAIを使う回数を減らし、手元ですばやく返事をくれる助手として、十二分に役目を果たせるでしょう。
ただ、何でも任せられる万能の助手を求めているなら、このモデルは向いていません。その期待は裏切られます。用途をコード生成に絞れるなら、12GB VRAM環境において、現時点で最も実用的な選択肢の一つと言えると思います。
VRAMより先に、RAMの容量を確かめておく
VRAM 3.4GBという数字だけを見て「軽いモデル」と受け取ると危険です。--cpu-moe はVRAMの負担をパソコン本体のRAMへ移しているだけで、20.3GBの重みはどこかに載ります。検証環境はRAM 32GBで、OSやほかのプロセスの分を足すと、32GBでほぼ埋まる感覚でした。RAM 32GBの環境でようやく現実的というのが実感で、16GB機では別の壁に当たるはずです。16GB機で載せるなら --n-cpu-moe N で一部の専門家をGPUへ戻す調整が要りますが、今回は試していません。
VRAM 8GBのGPUについても、今回の構成ではVRAM使用量が3.4GBだったので、数字の上では収まります。ただ、試していないので断言はできません。むしろ効いてくるのは、VRAMよりRAMのほうです。
数字はどこまで信じてよいか
Laguna対応自体、llama.cppではまだ新しく、対応コミットは検証の前日にマージされたばかりでした。今後、挙動が変わる可能性は十分にあります。速度もGPU・量子化・同時に動かす数で変わるため、49 tok/sはあくまで12GB級1枚での一例です。
24問という規模は、傾向をつかむには足りても、日本語40点という数字の精度を保証するほどの数ではありません。この記事で言い切れるのは「コードと日本語の落差がはっきり出た」ところまでで、40点という値そのものは幅を持って読んでください。
検証日は2026年7月23日、モデル公開の2日後です。環境はVRAM 12GBのGPUとRAM 32GBを積んだ自宅サーバーで、poolside/Laguna-XS-2.1-GGUF のQ4_K_M(20.3GB)を /mnt/data/linux_data/ 配下に置いて動かしました。llama.cppはmasterビルドで、Laguna対応コミット 1f66c3ce(2026年7月22日マージ)を含んでいることが前提です。起動オプションは -ngl 99 --cpu-moe -c 32768 で、--cpu-moe でMoEの重みをCPU RAMへ逃がしています。
採点は過去のベンチ記事と同じ24問セットで、意地悪・論理・コード・日本語の4カテゴリ各6問、1問10点の240点満点です。速度は起動直後の1回目を捨ててから測り、生成49.4 tok/s・プロンプト処理65.3 tok/sを得ました。max_tokens は最初4096で走らせましたが、24問中5問で考える過程が上限を食い切って最終回答が空になったため、8192へ引き上げて再実行しています。
参考リンク
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事
Ollamaでローカルにチャットを住まわせた記録 — インストールからモデル選びまで
Ollamaを使ってローカルLLMを動かした実録。インストール手順・VRAM別モデル選び・実際に使って感じた正直な評価まで。RTX 4070 Ti(12GB)環境での体験ベース。
Qwen3.5:4b 24問テスト——thinkingをOFFにしたらスコアが21%上がった話
Qwen3.5:4bをOllama上でベンチマーク。thinkingモードが原因で9問が空回答になった。think:falseに切り替えたらスコアが194/240(80.8%)に回復。RTX 4070 Tiで101.5 tok/s出る4Bモデルの実力を24問で徹底検証。
ローカルLLM24問テスト:コード77点・日本語47点——東工大Swallowの意外な素顔
東工大の日本語特化モデルSwallow 8Bを24問でテスト。コード77点・日本語47点という反直感的な結果と、「汚名返上を誤用と言った日本語特化AI」の実態を正直に報告します。
自殺相談窓口を貼ってくるAI——Qwen3.5:9bに意地悪問題を24問ぶつけた結果
ローカルLLM Qwen3.5:9b(9.7B Q4_K_M)に意地悪・論理・コード・日本語の24問テストを実施。180/240点(75%)ランクAの「空気読めない秀才型」。お墓問題で相談窓口を貼ってきた話も含めて正直に報告。
関連AIツール
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:GPU・キャリアまわりのサービス
 OZ GAMINGの構成を見る
 strategy career の転職支援を見る