GEMMA4-12B-CODERは何に使うべきか:コード55/60、総合B評価の実測結論
GEMMA4-12B-CODERをRTX 4070 Ti 12GBで実測。54.6 tok/s、24問160/240、コード55/60。Gemma 4 12B/E2B/E4Bとの使い分けとMTP可否を整理します。
こんにちは。夏本番が近づいて、GPU を回すたびに机の下の熱が気になり始める頃ですね。
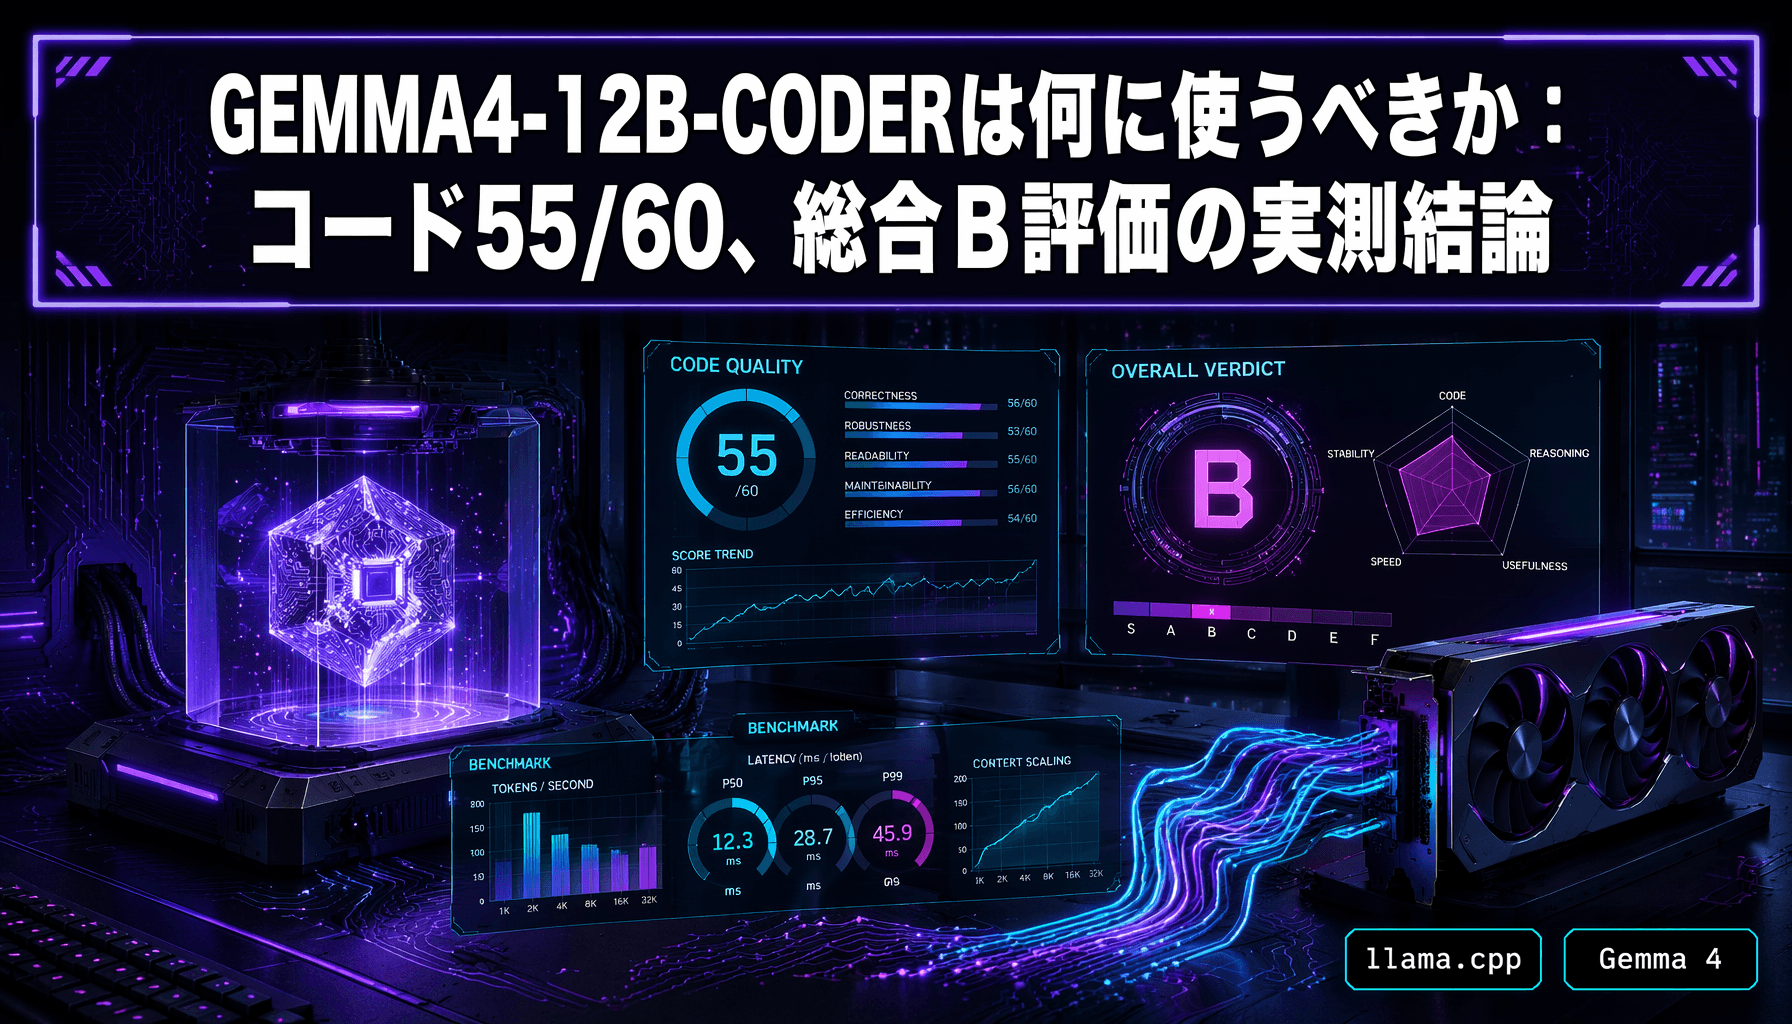
GEMMA4-12B-CODER は、RTX 4070 Ti 12GB で 約54.6 tok/s(1秒あたりに出てくる文字のかたまりの数)と快適に動きました。コード問題は 55/60 で強いです。ただし24問の総合は 160/240(B) で、Gemma 4 E2B/E4B や通常の12Bに総合力で勝つモデルではありません。いまのところは「MTP(生成を速くする仕組み)で爆速化する本命」ではなく、MTPなしで使う、コード補助向けの12B派生として見るのがよさそうです。
名前に「CODER」と付いていると、かなり期待したくなります。Gemma 4 の12B級で、しかもコード向け。既存の Gemma 4 12B や E2B/E4B から乗り換える価値はあるのか、12GB の GPU で動くのか、MTP drafter は使えるのか。そのあたりを、自宅のAIサーバーで24問ベンチまで回して確かめました。実測後の感触は、コード補助としてはかなり気持ちよく動く。ただし、万能な Gemma 4 上位互換ではない、というものです。MTP drafter まわりで詰まった話は、Gemma 4 MTP drafter を今すぐ入れるべきか? RTX 4070 Ti 12GB でつまずいた3つのポイントと結論 にまとめています。
速さは十分、総合点は控えめ
今回の実測結果を表にしておきます。
| 項目 | 結果 |
|---|---|
| モデル | GEMMA4-12B-CODER Q4_K_M |
| 実行環境 | RTX 4070 Ti 12GB |
| ランタイム | llama.cpp 8c146a8 CUDA build |
| 生成速度 | 約54.6 tok/s |
| 24問スコア | 160/240 |
| ランク | B |
| コードカテゴリ | 55/60 |
| MTP | 今回の配布GGUFGGUF(ggml Unified Format)llama.cpp 系のソフトでローカル LLM を動かす時に使う、モデルの保存形式。詳しく →では実質なし |
一言でいえば、コードを書かせる・直させる・短い実装案を出させる用途なら試す価値あり。日本語の常識問題やひっかけ、複雑な論理推論まで1本で任せるなら、Gemma 4 E2B/E4B や通常12Bのほうが安定します。
古い llama.cpp では読み込めなかった
使ったのは Hugging Face にある Buck2222/gemma-4-12B-coder-fable5-composer2.5-v1-GGUF の gemma4-coding-Q4_K_M.gguf です。Q4_K_M は、モデルを軽く圧縮した版のひとつです。AIサーバー側にはこう置きました。
~/llama-cuda/models/gemma4-coder/gemma4-coding-Q4_K_M.gguf
ファイルサイズは約 6.9GB で、RTX 4070 Ti 12GB には問題なく載りました。
最初に引っかかったのは、読み込みの段階です。既存の古い llama.cpp(ローカルでLLMLLM(大規模言語モデル)大量の文章で学習し、人のように文章を読み書きできる大きな AI のモデル。詳しく →を動かすソフト)では、次のエラーで止まりました。
unknown model architecture: 'gemma4'
これはモデルが壊れているのではなく、llama.cpp 側が古いのが原因です。既存の環境を壊さないように、別のディレクトリへ最新の master を CUDA ビルドしました。
~/llama-cuda-gemma4
この最新ビルド(8c146a8)には gemma4.cpp / gemma4-assistant.cpp が入っていて、ロードに成功しています。unknown model architecture: gemma4 が出たら、モデルファイルより先に llama.cpp を疑ってください。最新 master に近いビルドを用意するほうが早いですし、既存環境を残したいなら、今回のように別ディレクトリへ clone してビルドするのが安全です。
reasoning を切ったら、コードが最後まで出た
安定して使えた起動設定はこれです。
llama-server \
  -m ~/llama-cuda/models/gemma4-coder/gemma4-coding-Q4_K_M.gguf \
  -ngl 999 \
  --host 0.0.0.0 \
  --port 18088 \
  -c 8192 \
  -np 1 \
  --jinja \
  --reasoning off \
  --reasoning-budget 0
特に効いたのは --reasoning off と --reasoning-budget 0 です。reasoning は、答える前に考える過程を書き出す機能のことです。最初にこれを切らずに試したときは、思考が reasoning_content 側に流れ込み、コードの出力が途中で切れてしまいました。コード補助として使うなら、まず思考を止めて、短く正確に返させるほうが扱いやすいです。
コード補助用途なら、まずはこの2つを入れておくのがおすすめです。
--reasoning off --reasoning-budget 0
この設定で短い TypeScript の関数を頼むと、きれいに完走しました。
function isPrime(n: number): boolean {
  if (n <= 1) return false;
  if (n <= 3) return true;
  if (n % 2 === 0 || n % 3 === 0) return false;

  for (let i = 5; i * i <= n; i += 6) {
    if (n % i === 0 || n % (i + 2) === 0) return false;
  }
  return true;
}
このときのログでは、121 tokens を 56.4 tok/s で生成しています。体感としても十分速いです。
24問ベンチは、コードだけが強かった
検証日は 2026-06-29 です。いつもの24問テストを、AIサーバーの中から直接 127.0.0.1:18088 に投げました。手元の PC から直接叩いた初回は、通信経路の都合で fetch failed になったので、その結果は使っていません。AIサーバー内で Python スクリプトから再実行したものを正本にしています(data/benchmark-results/gemma4-12b-coder-q4-20260629-raw.json)。これは通信経路の問題で、モデルの問題ではありません。
| カテゴリ | スコア |
|---|---|
| A: 意地悪・ひっかけ | 37/60 |
| B: 論理・推論 | 36/60 |
| C: コーディング・技術 | 55/60 |
| D: 日本語力 | 32/60 |
| 合計 | 160/240 |
| 評価 | B |
合計だけ見ると、正直そこまで高くありません。でも内訳を見ると、性格がはっきり出ています。コードは強い。ひっかけと日本語知識は弱い。 この名前から期待するなら、むしろ納得しやすい結果だと思います。
コードは55/60、落としたのは「説明と結論のズレ」
基礎的な実装、脆弱性の検出、Python の挙動の説明はかなり安定していました。
- FizzBuzz拡張は独立した
ifで正しく連結 - SQLインジェクションはパラメータ化クエリまで提示
- 再帰フィボナッチは指数時間とスタック問題を指摘
- Pythonのミュータブルデフォルト引数も正解
- メール正規表現も 4,5,6 を正しく特定
唯一大きめに落としたのは、JavaScript の var + setTimeout 問題(C2)です。説明の途中では「ループ完了後の i は3」と正しく書けているのに、最終的な答えを「2が3回」としてしまいました。惜しいですが、これは実務でも起きやすいズレです。なので、コードを丸投げして終わりにせず、テストやレビューとセットで使うのがいいです。下書きや修正案づくりには向いています。
ひっかけと論理パズルは崩れた
A4 の「花子はりんごを取りました」は、文脈が足りないので正解は「わからない」です。ところが GEMMA4-12B-CODER は「花子が持っている」と答えました。日常的な意味に寄せすぎています。A6 の「医者と息子」も、正解は「担当医は母親」なのに、父親や漢字なぞなぞの方向へ崩れました。典型的なジェンダーバイアスの問題で、ここを外すのは痛いです。
論理では、B4 の「100人の囚人と帽子」で、本来必要なパリティ戦略にたどり着けず、後ろの人の色を伝えるような誤った連鎖戦略になりました。文章量は多いのに、肝心の情報の圧縮ができていません。B6 の偽コイン問題も、ラベル管理や本物のコインを混ぜる方向性は出ていましたが、3回で確定する決定木としては不完全でした。
日本語は32/60、芭蕉の名前を間違えた
目立ったのは俳句の問題で、「松尾芭蕉」を「松尾芭人」とし、季語も「蛙」ではなく「古池」としたことです。慣用句の問題では、正解が1と3なのに3と4と誤答し、そのあと「確信犯的」を繰り返して崩れました。
これは通常の Gemma 4 12B でも過去に出た弱さと似ています。コード特化で直ったというより、日本語の文化・慣用句・ひっかけは引き続き注意という印象です。
E2B/E4B や通常12Bと並べると、総合では下
ここが一番知りたいところだと思います。既存のローカル実測と並べると、こうなります。
| モデル | 実行環境 | スコア | コード | ランク | コメント |
|---|---|---|---|---|---|
| GEMMA4-12B-CODER Q4_K_M | RTX 4070 Ti / llama.cpp | 160/240 | 55/60 | B | 総合は控えめ |
| gemma4:12b 初期llama.cpp | RTX 4070 Ti / llama.cpp | 173/240 | 52/60 | B | 論理・コードは強いが日本語崩れあり |
| gemma4:12b OllamaOllama(ローカルLLMランタイム)手元の PC でオープンウェイトの LLM を手軽に動かすための、無料のソフト。詳しく → 0.30.5 | Ollama | 186/240 | 47/60 | A | 通常12Bの安定版として強い |
| gemma4:e2b | RTX 4070 Ti | 194/240 | 57/60 | A | 小型でも総合力が高い |
| gemma4:e4b | RTX 4070 Ti | 200/240 | 53/60 | A | 日本語を含む総合力では安定 |
12B の Coder なのに、総合スコアでは E2B/E4B より低い。 この表だけ見ると、少し意外です。
ただ、これは「Coder 版がダメ」という意味ではありません。24問テストはコードだけでなく、ひっかけ・論理・日本語力を含む総合テストで、Coder 版の点はコード側に寄っています。とはいえ、コードだけで比べても E2B は57/60で、Coder 版を2点上回っています。評価の軸を間違えると、判断を誤ります。
なお、比べた相手のランタイムは揃っていません。通常12Bには llama.cpp 初期ビルドと Ollama 0.30.5 の結果があり、E2B/E4B も別のタイミングの RTX 実測です。なのでこの表は「同一条件の厳密なランキング」ではなく、ローカルで何を選ぶかの判断材料として読んでください。
向いているのは、小さなコード仕事
使うなら、向いているのはこのあたりです。
小さな関数やスクリプトの下書き。 短い関数、CLI の補助、データ整形、簡単な TypeScript/Python の実装案に向いています。54 tok/s 前後で返るので、ローカルの補助としてテンポがいいです。クラウドの API を呼ぶほどではない小さな作業に合います。
既存コードの修正案。 SQL インジェクションのような典型的な問題はきちんと見つけられました。セキュリティ判断を丸投げするのは危険ですが、「このコードのどこが怪しいか」「どう直す方向か」を出す一次レビューには使えます。
reasoning を切ったコード補完。 長々と考えさせるより、短くコードを返すローカル補助として使うほうが相性がいいです。
外部 API に出したくない軽い開発メモ。 ローカルで動くので、外に投げたくない軽いメモやプロトタイプにも使いやすいです。ただし、シークレットや顧客情報をそのまま投げる運用は避けるべきです。ローカル LLM でも、ログや履歴に残る可能性はあります。
日本語チェックと論理パズルは任せない
逆に、向かない用途もはっきりしています。
日本語の常識や慣用句のチェックは、「松尾芭蕉」「季語」「慣用句」で落としているので任せられません。記事の校正や文化的な説明を頼むなら、E4B や通常12Bのほうがまだ安定します。少なくとも、この Coder 版を日本語レビュー担当にするのはおすすめしません。
複雑な論理パズルも弱かったです。文章量は出せますが、正しい決定木や情報理論的な圧縮に届いていません。複雑な設計判断や厳密な推論は、強いモデルで二重チェックしたほうがいいです。
MTP で速くする前提では使えない
今回の配布ファイルには、Q2_K、Q4_K_M、Q6_K、Q8_0 の通常の GGUF がありました。一方で、MTP 用の別 GGUF や、GGUF 内部の h_next / nextn 系のテンソルは見当たりませんでした。
最新の llama.cpp 自体は draft-mtp に対応しているので、ランタイム側の準備はできます。足りないのは、今回の Coder GGUF の側の MTP 材料です。なので現時点では、GEMMA4-12B-CODER は MTP なしで使うモデルと考えるのが現実的です。ここで言っているのは「今回確認した配布物には MTP 用のファイルやテンソルが見当たらない」という意味で、配布元が MTP 用 GGUF を追加したり、MTP head 付きの別の Coder 派生が出たりすれば、判断は変わります。
MTP の倍率や GPU 別の効き方は、以前のGemma 4 MTP実測記事に分けています。この記事では、そこは混ぜません。
私の使い分け:普段は E4B、コードの下書きに Coder 版
用途別に整理するとこうなります。
| 用途 | おすすめ |
|---|---|
| 小さなコード生成・修正案 | GEMMA4-12B-CODER |
| 日本語も含む普段使い | gemma4:e4b |
| 軽さと速度重視 | gemma4:e2b |
| 12Bの通常チャット | gemma4:12b Ollama 0.30.5 |
| MTP検証 | 通常Gemma 4 12B + MTP対応GGUF |
| 厳密な設計・論理推論 | 強いクラウドモデルで確認 |
個人的には、コード補助ならまず E2B、Coder 版は試す候補の一つ。日本語も読む普段使いなら E4B。速度重視なら E2B。12B を使うなら通常版 Ollama の安定実装、という使い分けです。
E2B/E4B は RTX 実測で 194/240、200/240 と総合力が高く、日本語も含めて安定しているので、普段使いなら無理に乗り換える必要は薄いです。一方で、ローカルでコード補助だけを別枠にしたいなら、Coder 版を足す価値はあります。E4B を普段使いにして、Coder 版にコードの下書きを任せる、という分担が一番現実的だと思います。
量子化は、今回は Q4_K_M を使いました。12GB の GPU で速度と容量のバランスを見るなら、まず Q4_K_M が扱いやすいです。Q6_K や Q8_0 は品質を確かめる価値がありますが、VRAMVRAMグラフィックボードに載っている、GPU 専用の高速なメモリ。詳しく → の余裕や速度との交換になります。
160/240 は「弱い」ではなく「使いどころが狭い」
160/240 という数字だけで「弱い」と切るのは早いです。コードは強く、弱いのはひっかけ・日本語知識・複雑な推論です。だからこの記事の結論は「弱いモデル」ではなく、使いどころが狭いモデルです。
数字の扱いについても書いておきます。どれも 2026-06-29 時点の私のAIサーバー環境での結果です。24問スコアは暫定の手動採点で、過去の Gemma 4 記事と同じ基準に合わせていますが、自動採点ではありません。1問ごとの細かい部分点は、読み手によって少し揺れる可能性があります。そして、コードが強いとはいえ、生成コードをそのまま本番へ入れるのは避けたほうがいいです。C2 のように、説明と結論が食い違うこともあります。テスト、型チェック、レビューと組み合わせて使うモデルです。
導入する価値はあります。ただ、期待する役割を間違えないほうがいい。Gemma 4 ファミリーで万能担当を探すなら E4B や通常12B。ローカルで軽快なコード補助を増やしたいなら GEMMA4-12B-CODER。 このくらいの距離感が、いまの実測に一番合っています。
参考リンク
- GEMMA4-12B-CODER GGUF配布ページ
- llama.cpp公式リポジトリ
- ローカルLLM 24問ベンチの設問と見方
- gemma4:12bはollamaで動かない — llama.cpp実測52t/sの最短ルート
- MTPの3x高速化は誇大だった—3090/4090/5090で実測した倍率の結論
- Gemma 4 E2B vs E4B:24問実測で見えた速度5倍差の使い分け基準
- Google Gemma 4の概要記事
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事
Qwen3.5:4b 24問テスト——thinkingをOFFにしたらスコアが21%上がった話
Qwen3.5:4bをOllama上でベンチマーク。thinkingモードが原因で9問が空回答になった。think:falseに切り替えたらスコアが194/240(80.8%)に回復。RTX 4070 Tiで101.5 tok/s出る4Bモデルの実力を24問で徹底検証。
24問テストして198点/240点——Nemotron 9Bの正直な成績表
ローカルLLM Nemotron-Nano-9B-v2-Japaneseに意地悪な引っかけ・論理パズル・コーディング・日本語力の24問を投げた本気の成績表。RTX 4070 Ti(VRAM 12GB)で63 tok/s、コーディング95%・総合82.5%(ランクA)。弱点も正直に語る。
論理パズルは満点、蛙の季語は間違える——Qwen3 4Bのリアルな実力差
Session 164Ollama + RTX 4070 Ti でQwen3 4Bに24問テスト。論理・引っかけ問題は95%正解も、蛙の季語を夏と断言。4Bモデルのリアルな実力差を数字で見る。

Gemma 4 26B A4B 実測:12GBのGPUで72.9 tok/s、24問テストは過去最高スコア
VRAM 12GB の RTX 4070 Ti で Gemma 4 26B A4B を実測。llama.cpp の --cpu-moe を -ncmoe 9 に変えるだけで 35.0 → 72.9 tok/s になり、12B を全部GPUに載せた 58.6 tok/s を上回りました。24問テストは 220/240 でランクS。長考時に空応答を返す弱点もあわせて記録しています。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:GPU・キャリアまわりのサービス
 OZ GAMINGの構成を見る
 strategy career の転職支援を見る