gemma4:12bがollamaで動かなかった件——0.30.5で解消・12GBで52t/s
ollamaのHTTP 500やSIGFPEで詰まったgemma4:12bは0.30.5で解消。それ以前の版向けにllama.cpp経由で12GB GPUに載せる実測手順も残しています。
こんにちは。湿気で髪がまとまらない日が増えてきましたが、GPU のほうは天気に関係なく素直に動いてほしいものですね。
先に、いまの答えから書きます。gemma4:12b は ollama 0.30.5 で全部直りました。 ollamaOllama(ローカルLLMランタイム)手元の PC でオープンウェイトの LLM を手軽に動かすための、無料のソフト。詳しく →(自分の PC で AI モデルを動かすためのソフト)を 0.30.5 以降に上げて公式タグ gemma4:12b を取り直せば、12GB の RTX 4070 Ti でも実測 52t/s(1秒あたりに出るトークン=文字のかたまりの数)で動きます。忘れやすいのは think:false を付けることだけです。
この記事を書いた 2026-06-04 の時点では、ollama では動きませんでした。上流のバグなので、あなたの環境のせいではありません。その日は本家 llama.cpp の docker(アプリを箱ごと動かす仕組み)に逃がして、12GB GPU で 52t/s を出すところまで確かめました。ただ日本語の長文は崩れが残り、安定化待ちという結論でした。同じ日に出た ollama 0.30.4 正式版でも再検証していて、公式配布は macOS 専用のままでしたが、テキストだけ読ませる回避策なら ollama でも 52t/s が出ています。そして翌 2026-06-05、0.30.5 で公式タグ gemma4:12b が Linux にも配られ、SIGFPE(計算エラーで落ちる症状)も直り、GGUFGGUF(ggml Unified Format)llama.cpp 系のソフトでローカル LLM を動かす時に使う、モデルの保存形式。詳しく →(モデルの配布形式)の再変換で日本語も正常になりました。直った後の確認は続報記事と、この記事の後半「続報2」にまとめています。
0.30.4 以前を使い続ける事情がある人のために、当時の回避策と詰まりどころはそのまま残しました。ollama そのものの入れ方でつまずいているなら、Ollama導入の罠と解決手順——GPU認識・日本語チャットまでの全記録と結論 を先に見ておくと、話がつながりやすいと思います。
確かめたのは4つ、書くのはその範囲だけ
| 検証項目 | 環境 | 結果 |
|---|---|---|
| ollama で gemma4:12b が動くか | RunPod RTX A4000・4回実走 | ❌ pull 412 / generate SIGFPE(上流バグ → のちに 0.30.5 で解消・続報節へ) |
| llama.cpp docker で動くか | 12GB GPU(RTX 4070 Ti) | ✅ 実測 52t/s |
| 日本語長文の品質 | 実プロンプトで確認 | 🟡 day-one ビルドは崩れあり → GGUF 再変換で後日解消 |
| 詰まりやすいポイント | 実ログから切り分け | ✅ 4 つを本文に掲載 |
ollama の復旧を前提にした回避策探しや、日本語品質を過大評価したおすすめはしません。検証した範囲だけを書きます。
2026-06-04 時点: ollama は外れ、llama.cpp なら当日動いた
2026-06-04 時点の実測では、gemma4:12b は ollama で次のどちらかに当たりました。
- 安定版 v0.30.3 では pull が 412 に落ちる
- 0.30.4-rc0 / rc1 では pull 後に generate で SIGFPE
RunPod の RTX A4000 で 4 回実走して確かめています。量子化量子化(Quantization)AI モデルの数値を少ない桁数で表し直して、ファイルと必要なメモリを小さくする手法。詳しく →(モデルを軽く縮める処理)やフラグをいじっても直りませんでした。ここで自分の設定を疑い続けるより、上流コード側のバグとして扱うのが妥当です。
そうなると、その日に必要だったのは「ollama を頑張ること」ではなく、別のランタイム(モデルを動かす土台のソフト)に逃がして、今日使える状態を作ることでした。
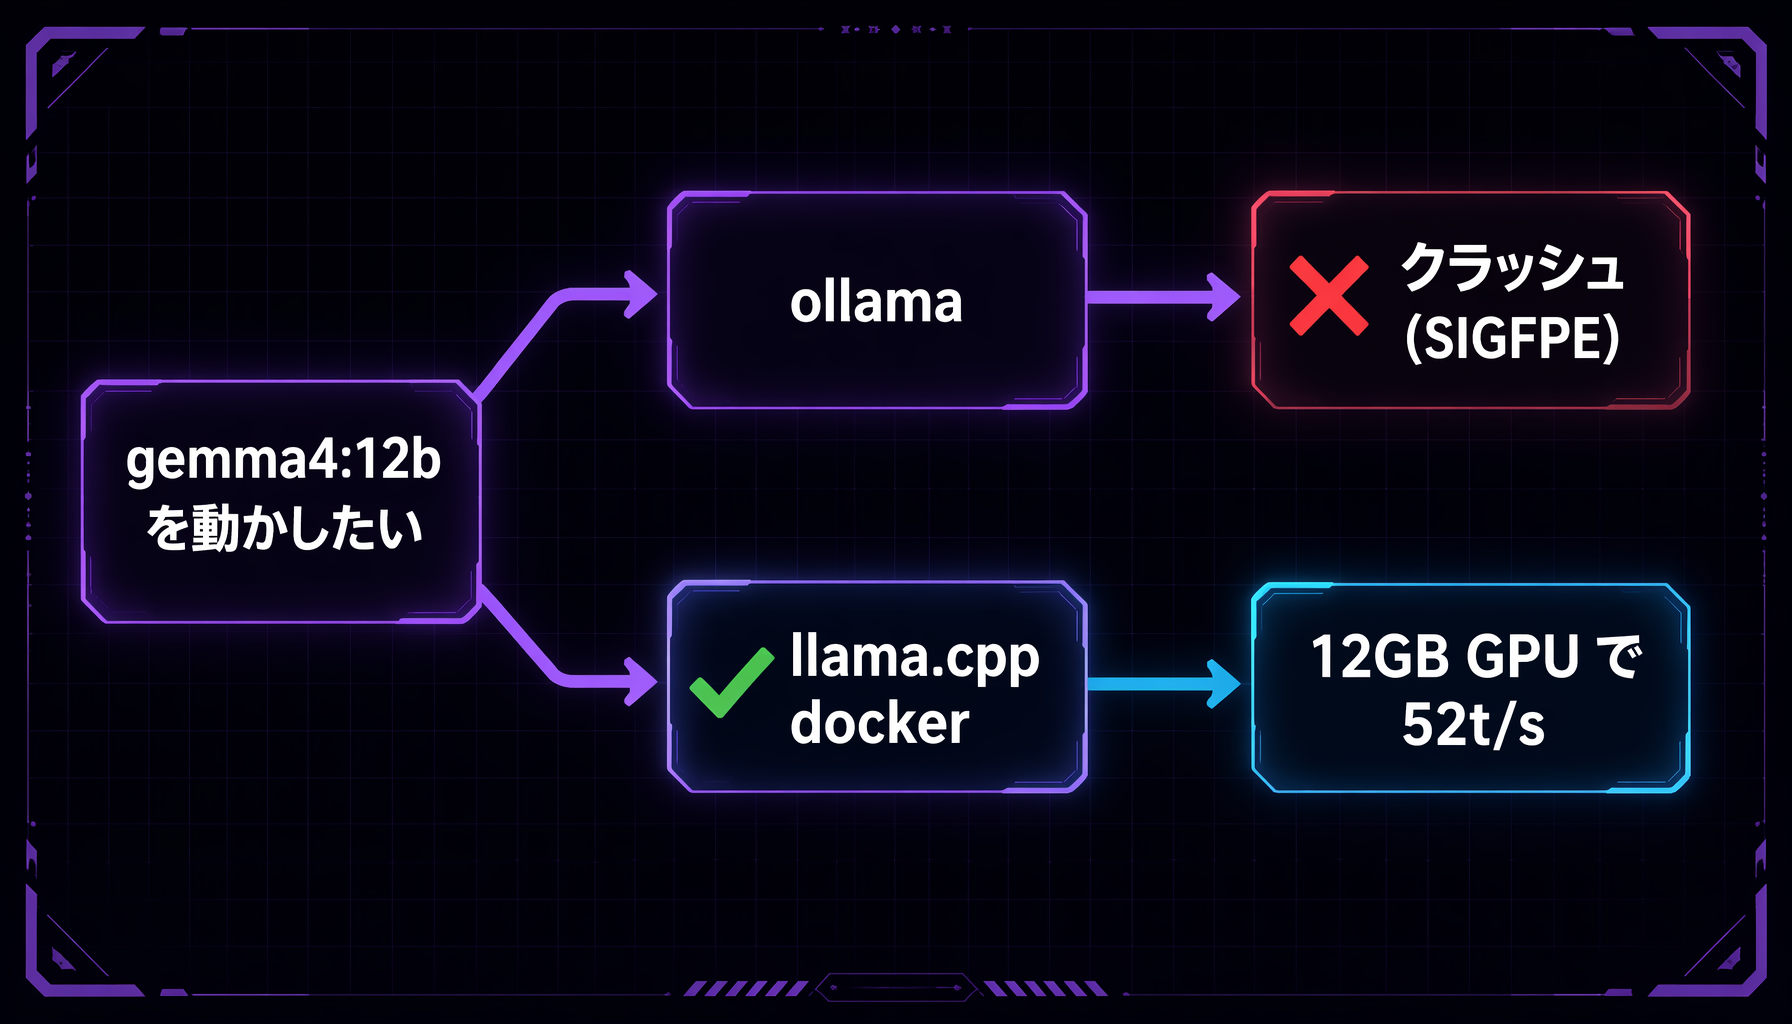
gemma4:12b の最短ルート: ollama は上流バグで外れ、llama.cpp なら今日動く
ランタイムごとの状況(2026-06-05 更新)
| ランタイム | 状態 | 備考 |
|---|---|---|
| ollama ★実測 | ✅ 動く(0.30.5〜) | 公式タグ gemma4:12b を 4070Ti で実測 52t/s・VRAMVRAMグラフィックボードに載っている、GPU 専用の高速なメモリ。詳しく → 8.1GB・日本語正常。思考モデルのため think:false 必須。0.30.4 以前は SIGFPE(経緯 → 続報節) |
| llama.cpp ★実測 | 🟡 テキストのみ動く | --no-mmproj 必須(vision は未対応) |
| HF Transformers | ✅ 動くはず | 公式サポートの本命(公式情報ベース・未実測) |
| MLX | ✅ 動くはず | Apple Silicon 向け(公式情報ベース・未実測) |
| LM Studio | 🟡 条件付き | エンジン更新の取り込み待ちあり(報告ベース・未実測) |
| vLLM | 🟡 条件付き | day-one 対応は要バージョン確認(報告ベース・未実測) |
★実測は、この記事で実際に試した行です。それ以外は 2026-06-04 時点の公式情報やコミュニティの報告をもとにしているので、最新の状況は各プロジェクトのリリースノートで確かめてください。
ここから扱うのは、NVIDIA GPU で最も手軽に動く llama.cpp 経路です。
llama.cpp の docker なら、12GB GPU に収まって動く
使うのは本家の docker イメージです。
- イメージ:
ghcr.io/ggml-org/llama.cpp:server-cuda - モデル:
-hf ggml-org/gemma-4-12B-it-GGUF:Q4_K_M - 重要な回避策:
--no-mmproj
Q4_K_M は 7.4GB なので、16GB はもちろん 12GB GPU にも収まります。 私の環境では VRAM 9.0GB / 12GB でした。数字としては地味ですが、この「ちゃんと収まる」が大事です。
実行コマンド
docker run --gpus all --rm -it \
  -p 8080:8080 \
  ghcr.io/ggml-org/llama.cpp:server-cuda \
  -hf ggml-org/gemma-4-12B-it-GGUF:Q4_K_M \
  --host 0.0.0.0 \
  --port 8080 \
  --no-mmproj \
  --ctx-size 8192 \
  --reasoning-budget 0 \
  --repeat-penalty 1.1 \
  --repeat-last-n 64
各オプションの意味
-hf ...: Hugging Face からモデルを取得します--no-mmproj: vision projector(画像を読むための部品)を読ませないための回避策です--ctx-size 8192: コンテキスト(一度に覚えておける文の長さ)を抑えて KVキャッシュの膨張を防ぎます。これを外すと 12GB に収まらない可能性があります(実測 VRAM 9.0GB はこの設定での値です)--reasoning-budget 0: 思考出力に流れて本文が空になる事故を避けます--repeat-penalty 1.1/--repeat-last-n 64: 日本語長文の無限ループ対策です
gemma4 をテキストだけのモデルとして使うなら、vision 機能は切っておいた方がむしろ安定します。ここを外すと、入れたはずなのに server が落ちる、あるいは 502 が延々と返る、という嫌な流れになります。一方で、入れた直後の 502 は「壊れている」のではなくまだモデルをダウンロード中ということも多いので、そこは分けて見る必要があります。以下の4つが、実際に引っかかったところです。
詰まりポイント1: --no-mmproj は必須
gemma4 の vision projector は gemma4uv 形式ですが、2026-06-04 時点では llama.cpp 側が対応していません。
-hf が自動で落としてきた mmproj を読み込む段階で、こう出ます。
unknown projector type: gemma4uv
そのまま server が終了し、フロント側では 502 が続きます。
テキスト用途なら、mmproj を読ませなければ済みます。
--no-mmproj
これだけです。vision を使いたい人には少し残念ですが、今はそこを欲張ると先に進めません。
詰まりポイント2: 起動直後の 502 は、たいていダウンロード待ち
llama.cpp の -hf は、モデルのダウンロードが先、待ち受けの開始(listen)が後です。なので起動してすぐ 502 が返ってきても、壊れているとは限りません。モデル本体が 8GB 前後あるので、初回は普通に時間がかかります。
ollama は「pull が終わってから動く」感覚が強いので、慣れている人ほどここで早めに見切って誤診しやすいところです。待つ間は、次の3つを見てください。
docker logsに download の進行が出ているかcurl http://localhost:8080/v1/modelsが後で通るか- しばらく待っても
unknown projector typeが出ていないか
詰まりポイント3: 日本語長文は repeat-penalty を入れないと壊れる
ここは実機で触っていて手が止まったところです。少なくとも私の環境では、repeat-penalty を外すと長文の日本語で無限ループが出ました。意 意 意... のような反復が伸び続けて、8000 トークン級まで暴走したのを見ています。
直し方はこれです。
--repeat-penalty 1.1 --repeat-last-n 64
これを入れた対照実験では、同じ 2 問が 799 / 1036 トークンで正常に終わりました。
ollama は既定でこのあたりが効いているので、普段 ollama で触っている人ほど気づきにくい差です。
詰まりポイント4: 思考の出力が本文を飲み込むことがある
gemma4 は思考モデル(答える前に考える過程を出力するモデル)です。そのため、出力が reasoning_content 側に流れることがあり、max_tokens が小さいと本文が空っぽに見えることもあります。初見だと、かなり嫌な症状です。
すぐ答えが欲しいなら、思考を切ります。
--reasoning-budget 0
あわせて、/completion ではなく /v1/chat/completions を使ってください。raw 系のエンドポイントだとチャットテンプレートが効かず、出力が崩れやすくなります。
速度は 12GB でも 52t/s、計算どおりの「普通に速い」
速度はかなり良かったです。
- RunPod RTX A4000 16GB: 44.77 tokens/s(100% GPU)
- 自宅 RTX 4070 Ti 12GB: 52.4 tokens/s
この数字は、私がいつも使っている予測式とも合っています。
生成速度(tokens/s) ≒ GPUメモリ帯域(GB/s) ÷ モデルサイズ(GB) × 効率(0.6〜0.85)
A4000(帯域 448GB/s)なら理論値は 448 ÷ 7.4 ≒ 60 tokens/s。実測 44.77 は効率75%でほぼ式どおりです。LLMLLM(大規模言語モデル)大量の文章で学習し、人のように文章を読み書きできる大きな AI のモデル。詳しく → の文章生成はメモリの読み出し速さで決まるので、モデルが VRAM に収まってさえいれば素直にこの式に乗ります。12B 級は 12GB でも体感即時です。
この式と「VRAM からあふれた瞬間の崖」については、RunPod で 16GB と 24GB を借りて実測した記事で詳しく確かめています。大げさに言うより、「普通に速い」と受け取るのが実態に近いと思います。
24問テストは 173/240、地力はあるが日本語が揺れた
品質も一応測りました。結果は 173/240(72.1%)で、ランクB です。
内訳では論理 52/60、コード 52/60 とかなり良く、モデルの地力が低いわけではありません。気になったのは日本語の長文で、分かち書きの崩れや固有名詞の崩れ(例: 「松尾芭蕉」が「松尾芭人」になる)といった、普段使いでは引っかかる揺れが残りました。
これは day-one ビルド(出たばかりの版)の成熟度の問題と見るのが自然で、モデルの賢さそのものを否定する材料ではありません。実際、この崩れは後で GGUF の再変換によって直っています(続報2)。
続報: ollama 0.30.4 正式版では、回避策つきで動いた(2026-06-04)
公開した直後に ollama 0.30.4 正式版が出たので、自宅の RTX 4070 Ti 12GB でその日のうちに再検証しました。「そのまま」はまだ動きません。ただ回避策を使えば動いて、52.25t/s 出ました。
動かない原因は1つではなく、3 層に分かれていました。
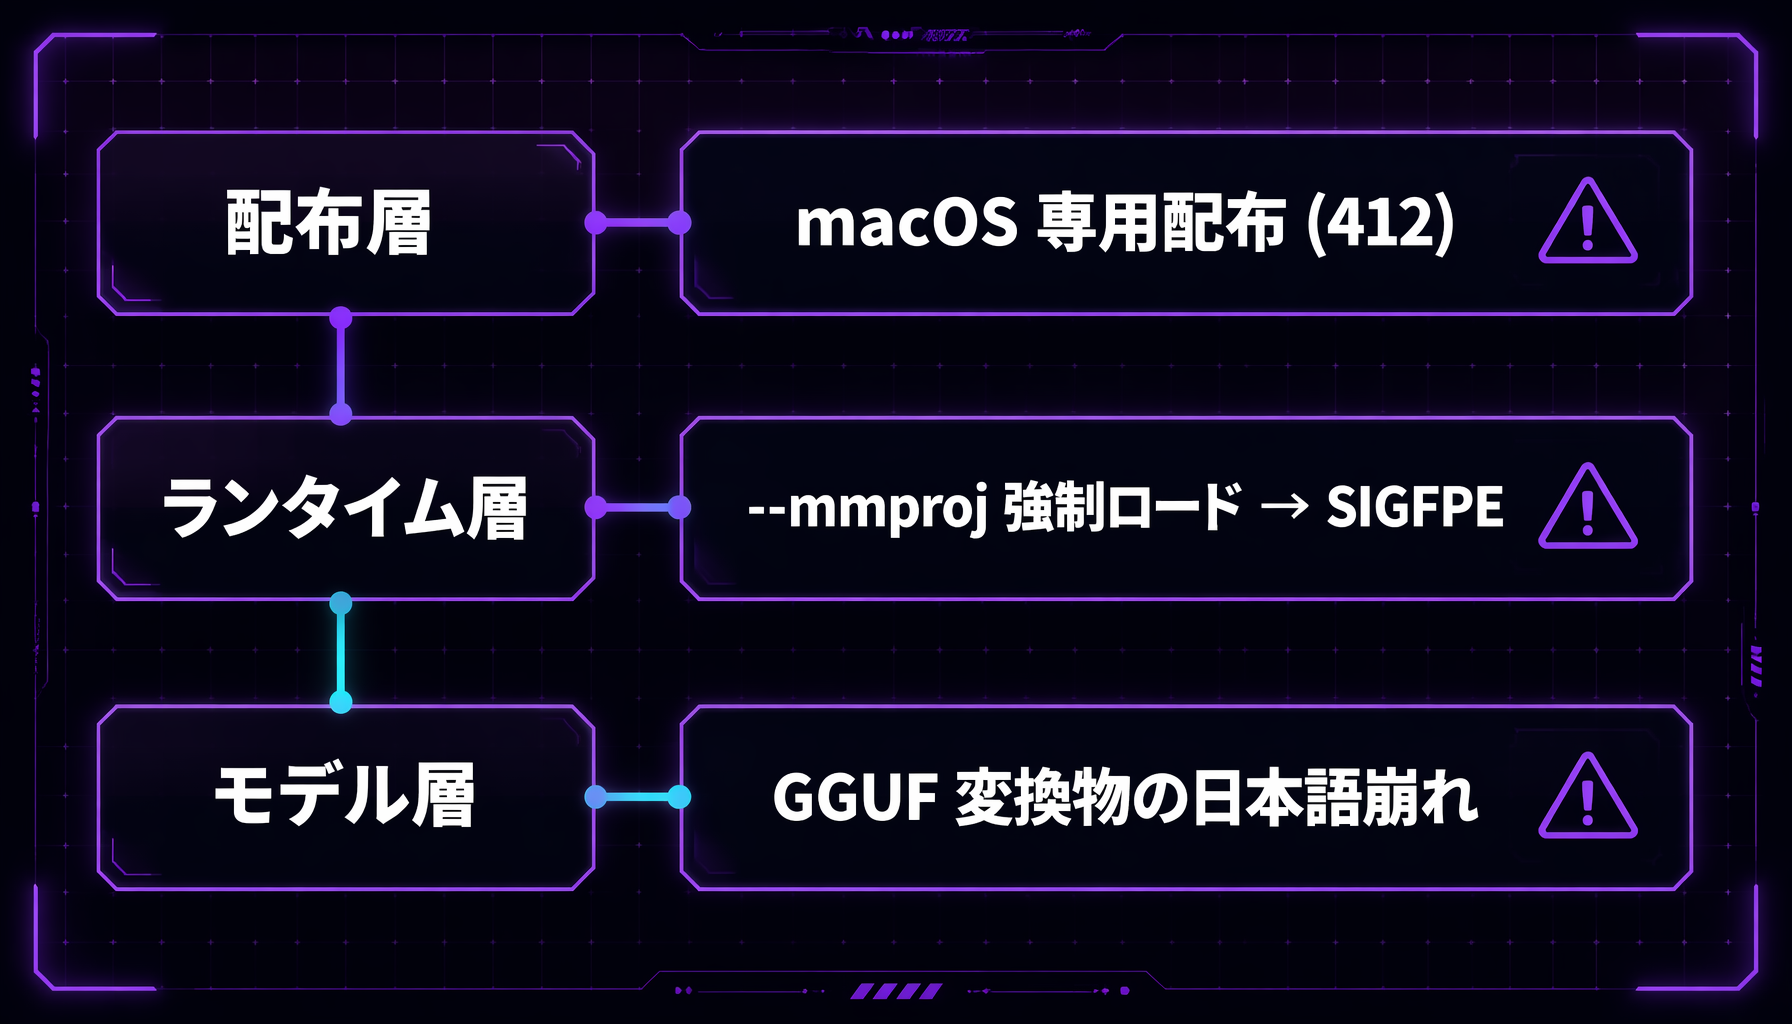
「動かない」の正体は1つではない: 配布・ランタイム・モデルの3層で別々の問題
| 層 | 何が起きるか | 切り分け結果 |
|---|---|---|
| 配布 | ollama pull gemma4:12b が manifest not found | 素の 12b タグはそもそも存在しない。12b 系タグ(mlx / mxfp8 / nvfp4)は全て 412: this model requires macOS = macOS 専用配布 |
| ランタイム | HF から GGUF を直 pull すると generate で SIGFPE | ログを見ると ollama が llama-server に --mmproj を強制付与していた。詰まりポイント1(gemma4uv 未対応)と同じ罠で、ollama 側に外すオプションがない |
| モデル | 日本語長文が崩れる | 後述。これだけは回避できない |
回避策: テキスト blob だけの Modelfile を作る
mmproj を読ませなければ動きます。pull 済みのテキスト用 GGUF blob(ダウンロード済みのモデル本体ファイル)だけを FROM に指定したモデルを作ります。
ollama pull hf.co/ggml-org/gemma-4-12B-it-GGUF:Q4_K_M
# ↑ この時点で generate はまだ SIGFPE で落ちるが、blob のダウンロードは完了している

# テキスト blob のパスを確認(一番大きい 7.4GB のファイルがそれ)
ls -lhS ~/.ollama/models/blobs | head -3

echo 'FROM /home/<ユーザー名>/.ollama/models/blobs/<7.4GBのblob名>' > Modelfile
ollama create gemma4-12b-text -f Modelfile
blob はハッシュで再利用されるので、追加のディスク消費はほぼゼロです。これで ollama run gemma4-12b-text が普通に動きます。思考出力で本文が空に見えるときは、API なら "think": false を付けてください。
速度は次のとおりでした。
- RTX 4070 Ti 12GB: 52.25 tokens/s(VRAM 8.0GB・100% GPU)
- 同じ GPU での llama.cpp 実測が 52.4t/s なので、ランタイム間の速度差は実質ゼロでした
日本語の崩れだけは、この時点では直らなかった
ここが残念なところでした。temperature 0 で「日本の四季について説明して」と聞くと、「三千島」という存在しない固有名詞の説明が返ってきました(/api/generate と /api/chat の両方で同じ出力)。
ただ、これで切り分けは一歩進みました。同じ GGUF を別ビルドのランタイムに載せても、崩れ方が同じ。つまり崩れの原因はランタイムではなく、GGUF 変換物そのものです。この時点では、上流で GGUF が再変換されるまで日本語の常用は待ち、という判断でした。
続報2: ollama 0.30.5 で3層とも直った(2026-06-05)
前日の3層切り分けから半日で、上流が一気に動きました。3層すべてに修正が入っています。
| 層 | 何が直ったか | 確認結果(4070Ti 実機) |
|---|---|---|
| 配布 | 公式タグ gemma4:12b(7.6GB)が Linux にも配布開始 | ollama pull gemma4:12b 成功 |
| ランタイム | v0.30.5 リリースノートに「Fix gemma4:12b floating point exception crash」 | SIGFPE 消滅・正常生成 |
| モデル | ggml-org の GGUF が再変換(2026-06-04 15:42 UTC) | 同一質問・temperature 0 で「三千島」幻覚が消え、桜・お花見・入道雲と正しい構造化日本語に |
実測は 52.2〜52.7t/s・VRAM 8.1GB・100% GPU。回避策版と同じ速さなので、乗り換えても損はありません。
# 0.30.5 以降はこれだけで動きます
ollama pull gemma4:12b
curl localhost:11434/api/chat -d '{"model":"gemma4:12b","messages":[{"role":"user","content":"こんにちは"}],"think":false,"stream":false}'
残る注意は1点だけです。gemma4 は思考モデルなので、think: false を付けないと応答が空に見えます(出力が thinking 側へ流れるため)。
上の回避策(テキスト blob の Modelfile)と llama.cpp で迂回する手順は、0.30.4 以前を使い続ける場合の参考として残しておきます。
いまの使い分け: ふつうは ollama 0.30.5、軽さ優先なら e4b
2026-06-05 時点では、こう考えるのが現実的です。
- ふつうに使いたい → ollama 0.30.5 + 公式タグ
gemma4:12bで OK(think:falseだけ忘れずに) - コード・英語・日本語とも → 実用圏に入りました(同一質問の temp0 比較で日本語修復を確認済み)
- 0.30.4 以前から更新できない事情がある → テキストのみ Modelfile の回避策(上の続報節)で
- 軽さ優先・省VRAM → gemma4:e4b も引き続き良い選択(e2b と e4b の実測比較はこちら)
迷うとしたら、たぶん 12b と e4b のどちらにするか、だと思います。念のため書いておくと、これは「12b が e4b より劣る」という話ではありません。計測の経路が違ううえ(e4b は ollama・12b は出たての llama.cpp ビルド)、12b の失点の大半は day-one ビルドの文字崩れでした。地力は 12b が上、今日の安定は e4b、という時点つきの使い分けです。
2026-06-04 の時点では「ollama を直す」より「今日使える経路へ逃がす」が正解でした。正式版が来たらそこで戻せばいい、と考えていて、実際に 0.30.4 は出た当日に試し、0.30.5 で配布・ランタイム・GGUF の3層すべてが直ったのを確かめました。いまは ollama に戻して大丈夫です。
いま取るべき行動は3つ
- ollama 側で詰まっているなら、0.30.5 以降に上げて公式タグ gemma4:12b を pull し直す
- 0.30.4 以前から更新できない事情があるときだけ、llama.cpp の docker かテキストのみ Modelfile の回避策を使う
- API から呼ぶときは think:false を付ける(付けないと応答が空に見える)
チームの中で共有するなら、この 3 行で十分です。
ollama は 0.30.5 以降なら公式タグ gemma4:12b がそのまま動く(think:false 必須)llama.cpp の docker なら 12GB でも動く日本語長文の崩れは GGUF 再変換で解消済み
盛らずに伝えておく方が、後で揉めません。
動作確認の最終チェック
llama.cpp で起動したら、最低限ここまで確かめてください。まずモデル一覧です。
curl http://localhost:8080/v1/models
応答が返れば、次に chat API を叩きます。
curl http://localhost:8080/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemma-4-12B-it-GGUF:Q4_K_M",
    "messages": [
      {"role": "user", "content": "日本語で一文だけ返して"}
    ],
    "max_tokens": 64
  }'
ここで短い日本語が返れば、最低限の導入は成功です。OS やライブラリの版が違うと手順が変わることがあるので、本番の環境に入れる前に、テスト環境で一度動かしておくと安心です。
参考リンク
- gemma4:e2b と e4b を24問テストで実測比較した記事
- RunPod で 16GB と 24GB の GPU を借りて実測した記事
- META-MARK
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
記事内で紹介した製品
関連記事

iGPU で LLM 推論:Radeon 780M + Ollama ROCm の速度実測と落とし穴3つ
Radeon 780MでOllama ROCmを動かす手順を、renderグループ・gfx1103偽装・OOMの3つの落とし穴ごとに整理。Ubuntu 24.04向けの実用ガイドです。
Nemotron-Nano-9B日本語版を実測——NVIDIA日本語特化LLMの実力と限界
NVIDIAが開発した日本語特化ローカルLLM「Nemotron-Nano-9B-v2-Japanese」をUbuntuサーバー(RTX 4070 Ti)に実際にインストールして動かした実録。日本語品質・速度・VRAM使用量を正直に評価。
Ollamaでローカルにチャットを住まわせた記録 — インストールからモデル選びまで
Ollamaを使ってローカルLLMを動かした実録。インストール手順・VRAM別モデル選び・実際に使って感じた正直な評価まで。RTX 4070 Ti(12GB)環境での体験ベース。
自分のPCで動かすAI — GPT4All完全ガイド。GPU選びからモデル選択まで
GPT4AllはGUIだけでローカルLLMが動かせるツール。GPU別モデル選択ガイドと、RTX 3060がなぜコスパ最強なのかを実用的に解説。LocalDocsでPDFをAIに読ませる方法も紹介。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:GPU・キャリアまわりのサービス
 OZ GAMINGの構成を見る
 strategy career の転職支援を見る