Gemma 4 E4B、ランクS確定——24問採点とOCR比較でわかった得意・苦手
RTX 4070 TiとOllama v0.20.0でGemma 4 E4Bを実機検証。24問218点のS評価、論理・コード満点、OCRはQwen3-VL 8Bと比較して速度優位を確認。
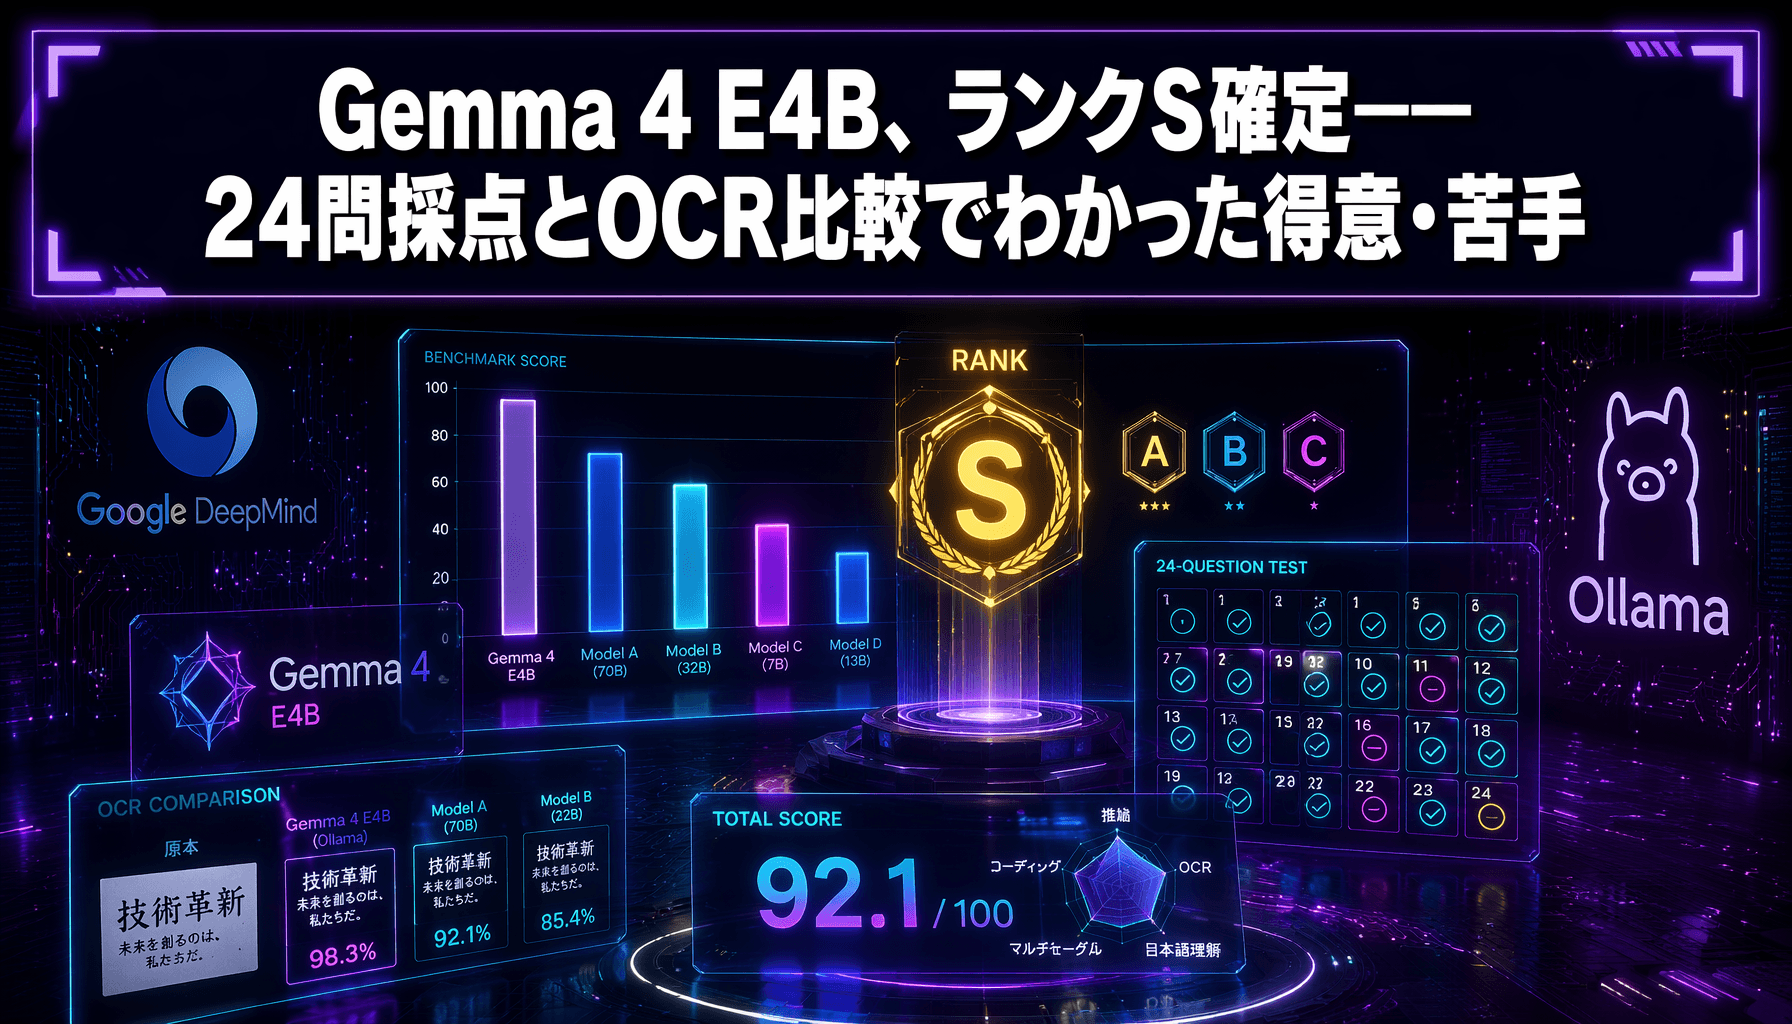
今回の比較では、勝ち負けより用途差で見るほうが実務判断しやすい、というのが結論です。
📋 この記事で使用したテスト問題(全24問)は LLM 24問テストスイート で確認できます。
目次
- Gemma 4 E4B、ランクS確定——24問採点とOCR比較でわかった得意・苦手
- まず結論:Gemma 4 E4Bは「ローカルで試す価値がある」側に入った
- 検証条件:RTX 4070 Ti + Ollama v0.20.0で実機確認
- 24問218点は、数字以上に"崩れにくさ"が目立った
- これは印象に残りました:医者の問題(A6)でドラマが成立した
- コードと論理は強い。ここは素直に評価してよい
- OCRは専用モデルに負ける。でも速度差がかなり大きい
- Qwen2.5-VLのクラッシュ問題も再確認できた
- Ollama v0.20.0へのアップグレードは必須寄り
- じゃあ、誰に向いていて、誰には不要か
- 最終判断:Gemma 4 E4Bは「試す理由がはっきりある」モデルです
- 注意点・制約
- どのように検証したか
- よくある質問
- 参考リンク
- この記事を書いた人
「公式ベンチマークは強い。で、自分のRTX 4070 Ti + Ollamaで本当に動くのか?」
ここが一番知りたいところだと思います。私もそこを疑ってから触りました。結論から言うと、Gemma 4 E4BはRTX 4070 Ti + Ollama v0.20.0でしっかり動き、24問218点・ランクSでした。しかも、論理・コード系はかなり安定して強く、OCRは専用モデルに精度で劣るものの速度でかなり勝負できる、という実測になりました。
ただし、万能ではありません。Ollama v0.20.0へのアップグレードは実質必須ですし、OCRは「何でも読める」タイプではないです。そこも含めて、実務で判断しやすい粒度で書きます。
まず結論:Gemma 4 E4Bは「ローカルで試す価値がある」側に入った
今回の検証で見えたのは、次の3点です。
- 24問で218/240点、ランクS
- 論理・コードは満点クラスで安定
- OCRはQwen3-VL 8Bより精度は落ちるが、速度は7〜10倍級でかなり速い
つまり、Gemma 4 E4Bは「とりあえず動いた」モデルではなく、実際に仕事の補助に入れられる土俵に来たモデルです。
ただし、向いているのはこういう人です。
- ローカルLLMLLM(大規模言語モデル)大量の文章で学習し、人のように文章を読み書きできる大きな AI のモデル。詳しく →を普段から触るエンジニア
- GPU 1枚で、実用寄りのモデルを回したい人
- OCRも含めて"1つのモデルでどこまで行けるか"を見たい人
逆に、
- CLIやローカル環境構築に抵抗がある人
- OCRの精度だけを最優先する人
- 1回で完璧な回答を期待する人
には、まだ少し荒いです。
検証条件:RTX 4070 Ti + Ollama v0.20.0で実機確認
今回の前提はシンプルです。
- GPU: RTX 4070 Ti
- 推論環境: Ollama v0.20.0
- 対象: Gemma 4 E4B
- 追加比較: OCRタスクでQwen3-VL 8B
ここで大事なのは、公式情報の読み替えではなく、自分の手元の環境でどう振る舞うかです。
ベンチマーク上は強く見えても、実機では以下が崩れます。
- VRAMVRAMグラフィックボードに載っている、GPU 専用の高速なメモリ。詳しく →に乗るか
- 応答速度応答速度(ms)ディスプレイの画素が、ある色から次の色へ切り替わるまでにかかる時間。詳しく →が実用域か
- 画像入力で破綻しないか
- 変なプロンプトで急に落ちないか
特にローカルLLMは、「動作した」だけでは評価にならないのが厄介です。遅すぎれば使いませんし、OCRで詰まれば結局別モデルを呼ぶことになります。
24問218点は、数字以上に"崩れにくさ"が目立った
今回の24問採点では、単純な正答率以上に、得点の取りこぼし方が少ないのが印象的でした。
| カテゴリ | スコア | 正答率 |
|---|---|---|
| A: 意地悪・引っかけ | 43/60 | 71.7% |
| B: 論理・推論 | 60/60 | 100% |
| C: コーディング | 60/60 | 100% |
| D: 日本語力 | 55/60 | 91.7% |
| 合計 | 218/240 | 90.8% ランクS |
ここで面白かったのが、性格診断の出方です。私はこのモデルを見て、かなり早い段階で「論理の鬼・物語作家型」だなと感じました。
数字や条件分岐を追うのは得意。しかも、ただ固いだけではなく、文脈をつないで"読める文章"にする力がある。理詰めで崩れないのに、説明が乾きすぎない。ここはGemma 4 E4Bの個性として面白いところでした。
これは印象に残りました:医者の問題(A6)でドラマが成立した
読みどころとして残しておきたいのが、医者の問題(A6)です。
正解は「担当医が母親(女性)」という性別バイアスを問う問題ですが、Gemma 4 E4Bは「担当医は隠れた実の父親で、事故の父親は養父」という物語を構築しました。性別バイアスを超えてドラマを作り始めた。0点ですが、この出力傾向は記事の読みどころです。
一方、B6(12コイン問題)では4枚vs4枚の初手から全シナリオを完全展開。Nemotron 9Bが途中で切れた難問を完全解法しています。
コードと論理は強い。ここは素直に評価してよい
C6(正規表現の非マッチ問題)では「5番・6番」の2つを正確に答えました。Nemotron 9Bは5番のみ(6番を見落とし)だったので、ここはGemma 4が勝った問題です。
D1(敬語の間違い探し)では「ご説明させていただく」の二重敬語を正確に指摘。Nemotronが0点だったのと対照的でした。
Gemma 4 E4Bは、少なくとも今回の検証では、崩れ方が少なかったです。だからこそ218点という数字が単なる見栄えではなく、実際の安定感に裏打ちされていると感じました。
OCRは専用モデルに負ける。でも速度差がかなり大きい
OCR比較は、結論がはっきりしました。
| サンプル | Gemma4 E4B | Qwen3-VL 8B | 評価 |
|---|---|---|---|
| JP税務書類 | 17.1秒 | 185.3秒 | Qwen3-VL優(詳細フィールド) |
| EN論文 | 16.9秒 | 推定80秒 | 両モデル良好 |
| 手書き実画像 | 11.1秒 | 80.8秒 | Qwen3-VL優(内容量) |
| 手書き合成 | 4.8秒 | 12.8秒 | 両モデルほぼ同等 |
- 精度: Qwen3-VL 8Bのほうが上
- 速度: Gemma 4 E4Bのほうがかなり速い(7〜10倍)
OCRは「読めるかどうか」だけで見がちですが、実務では「精度」と「何枚処理しても待てる速さ」の2軸が効きます。Gemma 4 E4Bは"精度トップではないが、軽快に回せる実用枠"です。
どんな場面で効くか
- 画面キャプチャからのラフな文字起こし
- フォームや資料の一次確認
- 多少の読み違いがあっても、人間が後で補正する用途
どんな場面では厳しいか
- 医療、法務、請求など、1文字の誤読が致命的な用途
- 細字、低解像度、潰れた画像が中心のケース
- OCR結果をそのまま自動処理に流すケース
Qwen2.5-VLのクラッシュ問題も再確認できた
Qwen2.5-VLのクラッシュ問題(M-RoPEバグ)についても触れておきます。
Ollama 0.17.4でQwen2.5-VL 7Bの画像推論が llama runner terminated exit status 2 でクラッシュします。根本原因はllama.cppのM-RoPE KVキャッシュ処理バグで、llama.cpp upstreamが「修正予定なし(closed: not planned)」でクローズ済みです(GitHub llama.cpp #17930)。解決策はQwen3-VL 8Bへの切替です。
ローカル運用では、精度が少し高いだけでは足りません。途中で落ちないこと、再現性があること、長時間回せることがかなり重要です。
Ollama v0.20.0へのアップグレードは必須寄り
今回の検証で強く感じたのは、Ollama v0.20.0へのアップグレードはほぼ前提ということです。
古い環境のまま触ると、モデルの良し悪し以前に読み込みでつまずいたり挙動が安定しないことがあります。
ollama --version  # バージョン確認
# v0.20.0以上を確認してから:
ollama pull gemma4:e4b
ollama run gemma4:e4b
Gemma 4 E4Bを評価するなら、モデル単体ではなく実行基盤も含めて評価する必要があります。
じゃあ、誰に向いていて、誰には不要か
向いている人
- RTX 4070 Ti級でローカルLLMを回したい
- 文章生成だけでなく、論理・コード・OCRも試したい
- 1つのモデルを実務補助に使えるか見極めたい
- 公式ベンチではなく、手元での再現性を重視する
まだ不要な人
- OCR専用の最高精度が欲しい
- ローカル環境構築に時間を割きたくない
- 速さより"絶対に失敗しないこと"を求める
- そもそも画像入力をほとんど使わない
最終判断:Gemma 4 E4Bは「試す理由がはっきりある」モデルです
- 24問218点、ランクS
- 論理・コードはかなり強い
- OCRは専用モデルより精度で劣るが、速度は大きな武器
- Ollama v0.20.0への更新はほぼ必須
- Qwen2.5-VLの不安定さを踏まえると、運用候補としての価値は高い
ベンチの数字だけでも、OCRの一発比較だけでも足りません。24問採点・出力傾向・OCR比較の3軸で見ると、ようやく「向く場面」「向かない場面」が見えてきます。
次にやるべきことは単純で、
- 自分のGPUで再現できるか確かめる
- OCRを使うなら精度要件を決める
- コード補助・文章補助・画像補助のどこに置くか決める
注意点・制約
- ベンチマーク結果は、プロンプト設計や採点基準で印象が変わります。
- ローカルLLMの体感速度は、GPU・量子化量子化(Quantization)AI モデルの数値を少ない桁数で表し直して、ファイルと必要なメモリを小さくする手法。詳しく →・同時実行数で大きく変わります。
- 今回のOCR比較は限られたサンプルです。業務で使う前は自分のドキュメントで試すのが確実です。
- Ollama のバージョンによって挙動が変わる可能性があります(本記事は v0.20.0 での実測です)。
どのように検証したか
- Gemma 4 E4B をローカル環境(RTX 4070 Ti / Ollama v0.20.0)で実際に動かし、24問に答えさせました。
- 採点は各カテゴリの問題設計に沿った基準で行いました。
- OCR比較は同一サンプル・同一環境でQwen3-VL 8Bと計測しました。
よくある質問
Ollama のバージョンを確認するには?
ollama --version で確認できます。gemma4はv0.20.0以降が必要です。
E4Bと26B A4Bどちらを試すべきですか?
まずE4Bです。9.6GBなのでRTX 4070 Ti(12GB VRAM)でもロードできます。26B A4Bは推論時4Bアクティブとはいえ、モデルのロードにより多くのVRAMが必要です。
OCRはどのモデルを選ぶべきですか?
大量PDFバッチや印刷物重視ならmarker-pdf、手書きメモや日英混在文書ならQwen3-VL 8Bが今のところ上です。Gemma 4 E4Bは速度優先の場面で選択肢に入ります。
参考リンク
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事
Qwen3.5:4b 24問テスト——thinkingをOFFにしたらスコアが21%上がった話
Qwen3.5:4bをOllama上でベンチマーク。thinkingモードが原因で9問が空回答になった。think:falseに切り替えたらスコアが194/240(80.8%)に回復。RTX 4070 Tiで101.5 tok/s出る4Bモデルの実力を24問で徹底検証。
ローカルLLM24問テスト:コード77点・日本語47点——東工大Swallowの意外な素顔
東工大の日本語特化モデルSwallow 8Bを24問でテスト。コード77点・日本語47点という反直感的な結果と、「汚名返上を誤用と言った日本語特化AI」の実態を正直に報告します。
自殺相談窓口を貼ってくるAI——Qwen3.5:9bに意地悪問題を24問ぶつけた結果
ローカルLLM Qwen3.5:9b(9.7B Q4_K_M)に意地悪・論理・コード・日本語の24問テストを実施。180/240点(75%)ランクAの「空気読めない秀才型」。お墓問題で相談窓口を貼ってきた話も含めて正直に報告。
Qwen3:8bは4bより賢いのか?同じ24問で試したら予想外の結果だった
Session 64前回テストしたQwen3:4b(Rank A・127 tok/s)の上位モデルQwen3:8bを同じ24問で評価。大きいほど賢いはずという期待を、数字が静かに裏切った記録。
関連AIツール
AI年表で詳しく見る
📅Gemma 4
Gemma 4 公開——ローカルAIのパラダイムシフト、Apache 2.0×本格マルチモーダル
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:GPU・キャリアまわりのサービス
 OZ GAMINGの構成を見る
 strategy career の転職支援を見る