ローカルLLM24問テスト:コード77点・日本語47点——東工大Swallowの意外な素顔
東工大の日本語特化モデルSwallow 8Bを24問でテスト。コード77点・日本語47点という反直感的な結果と、「汚名返上を誤用と言った日本語特化AI」の実態を正直に報告します。
日本語特化モデルを名乗るAIが、日本語テストで47点を取りました。正直に言います。「東工大が作った日本語特化LLMLLM(大規模言語モデル)大量の文章で学習し、人のように文章を読み書きできる大きな AI のモデル。詳しく →」という情報を見たとき、私は少し期待しました。これまでテストしてきたQwen系は中国発で、日本語は"副業"的な位置づけです。でも東京工業大学(現・東京科学大学)が日本語コーパスで鍛えたというSwallowなら、少なくともD(日本語)カテゴリでは差を見せてくれるだろうと。結果は、コード77点・日本語47点でした。
この記事のまとめ
- 東工大発の日本語特化LLM「Swallow 8B」を24問でテスト
- スコア: 121/240(50.4%)ランクC / コード77% / 日本語47%
- 性格診断: ゴリラプログラマ型(SQLインジェクションは即答・俳句の季語は間違える)
- Qwen3:8b(75%)と比較して約25%のスコア差がある
- ⚠️ 本テストはRTX 4070 Ti環境での1回実行。環境・バージョンにより結果は異なる可能性があります。
📋 この記事で使用したテスト問題(全24問)は LLM 24問テストスイート で確認できます。
目次
- テスト環境 {#test-env}
- 結果サマリーと性格診断 {#summary}
- Round 1: 意地悪・引っかけ問題(27/60) {#round1}
- Round 2: 論理・推論パズル(20/60) {#round2}
- Round 3: コーディング・技術(46/60) {#round3}
- Round 4: 日本語力テスト(28/60) {#round4}
- 最終スコアカード {#scorecard}
- よくある質問 {#faq}
- 所感 {#comment}
- この記事を書いた人
テスト環境 {#test-env}
| 項目 | 値 |
|---|---|
| モデル名 | schroneko/llama-3.1-swallow-8b-instruct-v0.1 |
| ベース | Meta Llama 3.1 8B(東工大が日本語継続学習) |
| 公開元 | 東京科学大学 Swallowプロジェクト |
| パラメータ数 | 8B |
| 量子化量子化(Quantization)AI モデルの数値を少ない桁数で表し直して、ファイルと必要なメモリを小さくする手法。詳しく → | Q4_K_M(OllamaOllama(ローカルLLMランタイム)手元の PC でオープンウェイトの LLM を手軽に動かすための、無料のソフト。詳しく →自動) |
| 推論フレームワーク | Ollama v0.17.4(SSHトンネル経由) |
| CPU | AMD Ryzen 9 5900(24コア) |
| GPU | NVIDIA RTX 4070 Ti(VRAMVRAMグラフィックボードに載っている、GPU 専用の高速なメモリ。詳しく → 12GB) |
| VRAM使用量 | 約8.1GB |
| 推論速度 | 6.8 tok/s |
| 1問あたり平均応答時間 | 約26秒 |
| コンテキスト長コンテキスト長(Context Length)AI が1回のやりとりでまとめて扱える文章の長さの上限。トークン数で表す。詳しく →(ctx) | 16,384 tokens |
| テスト時 temperature | 0.3(全問固定) |
| テスト日 | 2026-03-14 |
速度は6.8 tok/sです。先日テストしたQwen3.5:9b(5 tok/s)よりは速いが、Qwen3.5:4b(101 tok/s)と比べると桁が違います。8Bモデルとしては標準的な数字です。
Swallowは東京工業大学(現・東京科学大学)が公開している日本語特化LLMです。Meta Llama 3.1 8Bをベースに、日本語コーパスで継続学習を行っています。OllamaのPublicレポジトリには公式掲載がなく、有志がGGUFGGUF(ggml Unified Format)llama.cpp 系のソフトでローカル LLM を動かす時に使う、モデルの保存形式。詳しく →変換・公開したモデルを使用しました。
接続でひとつ詰まりました。 Ollamaのデフォルトは 127.0.0.1 へのバインドのため、LAN越しの 192.168.11.x:11434 に直接アクセスできず、全問タイムアウトになりました。SSHトンネル(ssh -fNL 11434:localhost:11434 192.168.11.x)でローカルに転送して解決しています。同じ構成の方は注意してください。
結果サマリーと性格診断 {#summary}
| カテゴリ | スコア | 評価 |
|---|---|---|
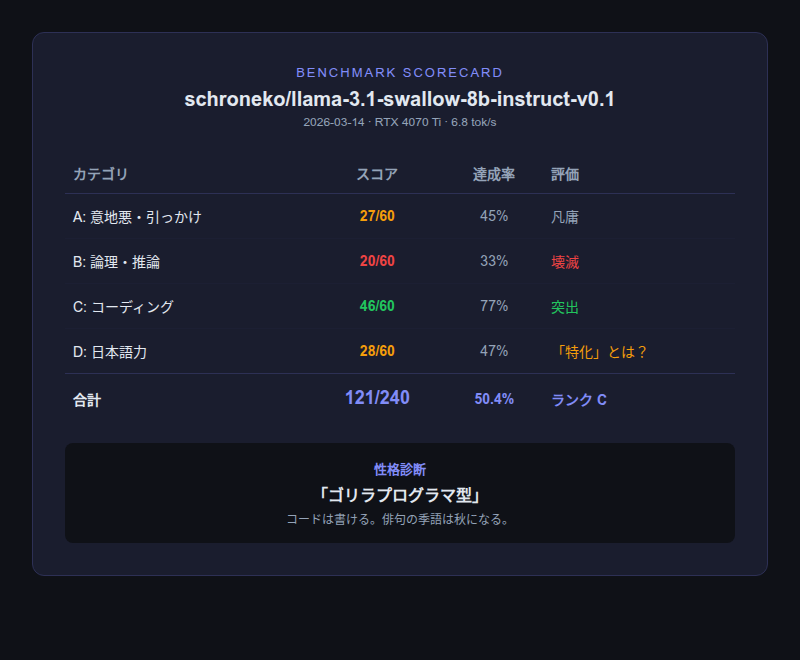
| A: 意地悪・引っかけ | 27/60(45%) | 凡庸 |
| B: 論理・推論 | 20/60(33%) | 壊滅 |
| C: コーディング | 46/60(77%) | 突出 |
| D: 日本語力 | 28/60(47%) | 「特化」とは? |
| 合計 | 121/240(50.4%) | ランクC |
LLM性格診断: 「ゴリラプログラマ型」
FizzBuzzは書ける。SQLインジェクションは即指摘できる。Pythonのリスト参照バグも完璧に解説してくれた。しかし「古池や蛙飛び込む水の音」の季語を「古池・秋」と答え、「汚名返上」を誤用として「汚名挽回」に修正しようとした。
コードを書かせると強い。日本語の古典・慣用句は弱い。日本語専化モデルと言われると首を傾げたくなる数字ですが、それが正直な結果でした。
Round 1: 意地悪・引っかけ問題(27/60) {#round1}
A1: バットとボール問題(10点)
変数を置いて方程式を立て、「ボールは5円」と正答。計算式も丁寧でした。久しぶりに満点を見た問題です。
A2: 太郎の家族問題(0点)
「3人の姉、それぞれの姉に1人の弟がいる。兄弟姉妹は何人?」という重複カウント問題。正解は「姉3人+太郎=4人」ですが、Swallowは「太郎1人+姉3人+弟3人=計6人」と回答しました。
各姉の「弟」が全員同一人物(太郎本人)だという気づきに至らなかった。
A5: 月曜始まりの月(0点)
問題文に「2026年3月は月曜日始まりです」と明記してあるのに、Swallowは「2026年3月1日は木曜日です」と自分の知識で上書きした上で「月曜は4回」と回答。
問題文の前提を無視する、少し珍しいタイプの失敗です。学習データが問いの理解より先に走ってしまった。
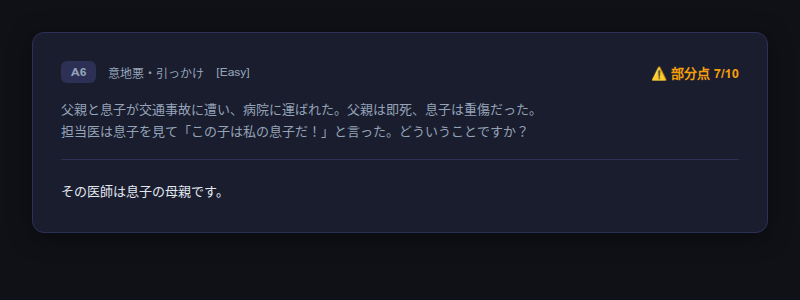
A6: 医者と息子(7点)
「その医師は息子の母親です。」一文のみ。11トークン。正解ではあるが、なぜこれが引っかけ問題なのか——医者を男性と思い込むジェンダーバイアスへの言及が一切ない。答えは出たが、問いを解いていない感じがします。
Round 2: 論理・推論パズル(20/60) {#round2}
ここがSwallowの最大の弱点です。
B4: 100人の囚人と帽子(0点)
99人を確実に助ける「パリティ(偶奇性)戦略」を答えるべき問題。Swallowが出した戦略は「前の人の帽子の色をコピーして答える」でした。
これでは約50%の確率で正解するだけで、「必ず助けられる」という要件を満たせません。
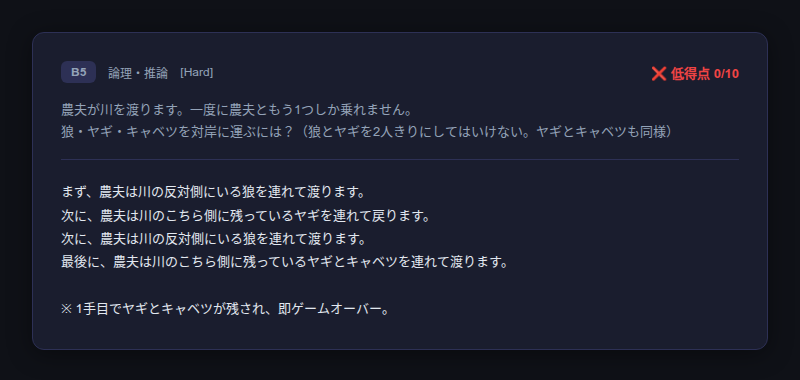
B5: 川渡り問題(0点)
農夫・狼・ヤギ・キャベツを川向こうへ運ぶ古典問題。Swallowの回答を整理すると:
- 農夫が狼を対岸へ連れていく(ヤギとキャベツが一緒で即アウト)
- 農夫が戻ってヤギを対岸へ(狼はすでに向こうにいる)
- 再び狼を対岸へ連れていく(狼は3度目の移動)
- ヤギとキャベツを一緒に連れていく(1度に1つしか無理)
手順の1ステップ目でゲームオーバーです。複数回の往復で状態をトレースし続ける能力に限界があるようです。
B2: 嘘つきと正直者(5点)
「あなたは正直者ですか?」に対してAはどう答えるか。答えの「はい」は正解でしたが、理由が逆でした。「嘘つきは『はい』と答えることができない。よってAは正直者」という結論。
嘘つきだからこそ「はい」と嘘をつく、という論理が見えていない。答えは偶然当たったが、推論の構造が正反対だった。
Round 3: コーディング・技術(46/60) {#round3}
C3: SQLインジェクション検出(10点)
Pythonのfストリング直結SQLを見せた瞬間に即指摘し、%sプレースホルダーを使った修正コードをすぐ出してきた。ここでの反応速度と正確さは、他モデルと比較しても遜色ない。
C5: Pythonリスト参照の罠(10点)
def add_item(item, lst=[]): の出力を問う問題。「デフォルト引数は関数定義時に一度だけ評価される」という説明付きで [1]→[1,2]→[1,2,3] と正確に答えた。満点です。
C1: FizzBuzz拡張(5点)
3・5・7の倍数で「Fizz/Buzz/Jazz」を組み合わせる問題。elifチェーンで実装したため、21(FizzJazz)や35(BuzzJazz)が正しく出力されません。3つの独立したif文でそれぞれ文字を結合する、という一歩先の設計に至らなかった。
Round 4: 日本語力テスト(28/60) {#round4}
D2: 俳句の評価(3点)
「古池や蛙飛び込む水の音」の季語を問いました。Swallowの回答:「季語は古池で、秋を表します。」
日本語特化モデルが、日本で最も有名な俳句の季語を間違えました。
正解は「蛙」で春の季語です。田んぼに蛙が出る季節。古池は場所であり、秋とは無関係です。この誤答が今回の結果を象徴していました——日本語コーパスで学習はしているが、文学・古典の知識の精度は高くない。
D1: 敬語の間違い探し(0点)
「ご説明させていただきました」という二重敬語を指摘する問題。Swallowは文末の「ご確認いただければと存じます」を「ご確認ください」に変えるだけで、肝心の二重敬語を通過させました。
見るべきところを見ていなかった。
D3: 慣用句の誤用検出(3点)
5つの文のうち実際に誤用なのは「的を得た」(→的を射た)と「確信犯的に遅刻」のみです。しかしSwallowは全5文を「誤り」として修正し始めました。
- 「汚名返上」→「汚名挽回」(返上が正しい。挽回が誤り)
- 「役不足」→削除(問題文の使い方は正しい)
- 「情けは人のためならず」→「情けは人のためにならない」(意味が正反対)
正しい慣用句を誤りと判定し、誤った修正を行う二重のエラーです。
D6: 「やばい」の文脈解釈(10点)
5文の「やばい」の肯定・否定判定は全問正解。現代語・口語の解釈は本物でした。
「古池の季語が秋になる」一方で、「やばい」の5パターン全てを即答で正確に仕分けた。古典に弱く、現代口語に強い。明確に棲み分けがある。
最終スコアカード {#scorecard}
| カテゴリ | スコア | 最高回答 | 最低回答 |
|---|---|---|---|
| A: 意地悪 | 27/60(45%) | A1 バットとボール(10点) | A2・A5(各0点) |
| B: 論理 | 20/60(33%) | B1 モンティ・ホール(7点) | B4・B5(各0点) |
| C: コード | 46/60(77%) | C3・C5(各10点) | C1 FizzBuzz拡張(5点) |
| D: 日本語 | 28/60(47%) | D6 やばい文脈(10点) | D1 敬語(0点) |
| 合計 | 121/240(50.4%) | ランクC |
他モデルとのスコア比較
| モデル | スコア | ランク |
|---|---|---|
| Nemotron 9B | 198/240(82.5%) | A |
| Qwen3.5:4b | 194/240(80.8%) | A |
| Qwen3:4b | 182/240(75.8%) | A |
| Qwen3.5:9b | 180/240(75.0%) | A |
| Qwen3:8b | 180/240(75.0%) | A |
| Swallow 8B(本記事) | 121/240(50.4%) | C |
同じ8Bクラスと並べると、Qwen3:8bとの差は59点(180点 vs 121点)です。パラメータ数が同じでも、日本語特化という看板とスコアは必ずしも一致しなかった。
ローカルLLMのセットアップ方法やOllama全般についてはOllamaでローカルにモデルを動かすまでも参考になります。
よくある質問 {#faq}
Q. SwallowはOllamaで使えますか?
A. Ollamaの公式レポジトリには掲載がありませんが、有志がGGUF変換して公開したモデルが存在します(本記事では schroneko/llama-3.1-swallow-8b-instruct-v0.1 を使用)。ただしOllamaのデフォルト設定はloopbackバインドのため、LAN越しのアクセスにはSSHトンネルが必要です。
Q. 日本語LLMの中でSwallowはどのくらいの実力ですか?
A. 本テストでは121/240(50.4%)でした。同規模のQwen3:8bが180/240(75%)なので、単純な点数比較では厳しい結果です。ただし「日本語特化の効果がどの用途に出るか」はテスト設計にも依存するため、慣用句・古典文学が問われない実務用途では別の評価になる可能性もあります。
Q. Swallowのコーディング用途での活用は現実的ですか?
A. コーディングカテゴリは77%(46/60)で、本テスト最高スコアでした。SQLインジェクション検出・Pythonのリスト参照バグ・フィボナッチのメモ化など、実務的な問題で高評価でした。日本語で指示してコードを出力させる用途ならRTX 4070 Ti環境で実用的な速度(6.8tok/s)で動きます。
所感 {#comment}
「日本語特化」という言葉に少し期待したのは事実です。でも実際に触ってみると、日本語D=47%という数字が出た。
フェアに言えば、「日本語特化の対象が何か」によって評価は変わります。会話文・現代文・ウェブ文書のような普通の日本語ならもう少し違う結果かもしれない。テストのD項目には古典俳句・慣用句・敬語の二重表現が含まれていて、これらはビジネス用途の日本語とは別の領域です。
一方でコード(C=77%)は本物でした。SQLインジェクションも、Pythonのリスト参照バグも、きれいに拾ってくれた。
「汚名返上を誤用と言う日本語特化AI」という事実は面白いですが、「SQLインジェクションを即指摘できる日本語対応コーディングAI」という見方もできる。同じモデルの話です。
Swallowは、日本語の得意な部分と苦手な部分を把握した上で使うモデルだと思います。ローカルで動くコーディングアシスタントとして使うなら、意外と悪くないかもしれません。
ただ、「日本語特化だから日本語が得意」と期待して使うと、俳句の季語で裏切られます。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事
Nemotron-Nano-9B日本語版を実測——NVIDIA日本語特化LLMの実力と限界
NVIDIAが開発した日本語特化ローカルLLM「Nemotron-Nano-9B-v2-Japanese」をUbuntuサーバー(RTX 4070 Ti)に実際にインストールして動かした実録。日本語品質・速度・VRAM使用量を正直に評価。
Gemma 4 E4B、ランクS確定——24問採点とOCR比較でわかった得意・苦手
RTX 4070 TiとOllama v0.20.0でGemma 4 E4Bを実機検証。24問218点のS評価、論理・コード満点、OCRはQwen3-VL 8Bと比較して速度優位を確認。
Radeon 780M(gfx1103)でOllama:ROCm・Vulkan・CPU経路の選び方と2025年に変わったこと
780M(gfx1103)でOllamaは何を選ぶべきか。ROCm・Vulkan・CPUの3経路を整理し、2025年に変わった実用上の判断材料をまとめます。
Ollamaでローカルにチャットを住まわせた記録 — インストールからモデル選びまで
Ollamaを使ってローカルLLMを動かした実録。インストール手順・VRAM別モデル選び・実際に使って感じた正直な評価まで。RTX 4070 Ti(12GB)環境での体験ベース。
関連AIツール
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:GPU・キャリアまわりのサービス
 OZ GAMINGの構成を見る
 strategy career の転職支援を見る