Gemini 3.8 Flash TTSを実測:1分約2.6円で声は本人か
Gemini 3.8 Flash TTS の声の複製(Voice replication)を管理人本人の声で試したレビュー。見本25秒と同意文9秒の録り方、有料キーが必須だった点、全9本・420秒で約18円(1分約2.6円)の実測費用、品質は最高クラスだが完璧すぎる・感情指定は効きすぎという評価、同意録音を公開してはいけない理由まで。
こんにちは。夜になると虫の声が聞こえる季節になりましたね。今回は、自分の声を AI にそっくり読ませるという、ちょっと不思議な体験の話です。
2026年9月23日に Google が公開した音声合成モデル Gemini 3.8 Flash TTS には、短い録音から話し手の声を再現する Voice replication(声の複製) が付いています。これを管理人自身の声で試したところ、品質はこれまで試した中で文句なしの最高クラスでした。ノイズもなく、自分で聴いて「ほぼ私」と感じるほどです。ただし完璧すぎて、一度も言い間違えない。そこだけが人間らしくなく、だからこそナレーションや説明音声には非常に向いています。費用は 1分あたり約2.6円、今回作った全9本で約18円でした。
管理人は、これまでもローカルの音声合成や声クローンをいくつか試してきました(たとえば Qwen3-TTS に声クローン機能を追加した話)。でも正直、「似ているけど、どこか別人」の域を出たことがありません。今回は日本語・英語・CM 風・感情指定まで試しています。そして、この記事でいちばん伝えたいのは、複製の肝は「同意文の録音」で、その録音は絶対に公開してはいけないということです。
声の複製は「録音2本」で作る
Gemini 3.8 TTS には、声の選び方が4つあります。
- 既製の30声(Kore・Puck など)
- 数百種類の拡張ボイスライブラリ
- 文章で声を注文する Voice design
- 実際の録音から声を再現する Voice replication
Voice replication は、同じ大人の話し手による録音を2本送ると、その人の声のプロファイル(声の特徴をまとめたデータ)を作ってくれる機能です。
| 録音 | 中身 | 規定 |
|---|---|---|
| 見本(reference) | 普通に話している声 | 10〜30秒・雑音のない自然な発話 |
| 同意(consent) | 決められた同意文の読み上げ | 対応30言語のいずれかの文面を一字一句そのまま |
形式は 24kHz・モノラル・16bit の WAV が推奨です。作った声は voice_... という ID で1年間保存され、合成するときはその ID を指定するだけで使えます(1プロジェクト200声まで)。
肝は「同意文の録音」
公式ドキュメントに載っている日本語の同意文はこれです。
私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。
これを見本と同じ話し手が、見本と同じマイク・同じ部屋で読み上げます。Google 側は、見本の声と同意の声が同じ人かどうかを照合します。他人の声を勝手に複製できないようにするための「鍵」が、この録音なんですよね。
同じ条件で録れば、照合は1回で通った
管理人の環境は、USB コンデンサーマイクとブラウザの録音画面です。
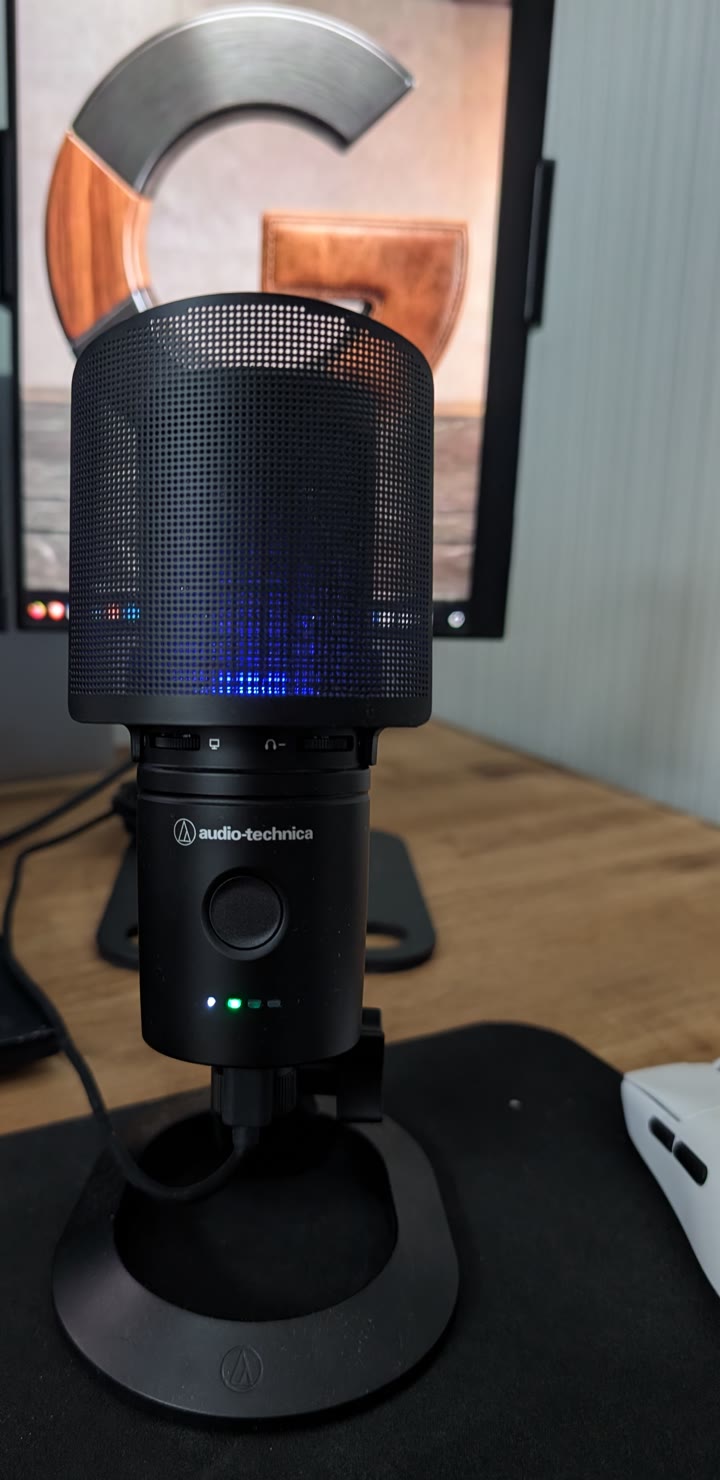
今回の見本と同意の録音は、すべてこのマイクで録りました
使ったのは、オーディオテクニカの AT2020USB-XP です。USB でパソコンにつなぐだけで使える手頃な価格帯の高性能マイクで、定番の AT2020 の音質を引き継いだうえにノイズリダクション機能を載せています(公式によると、エアコンやパソコンのファンの音を3段階で低減。オートゲインコントロール=音量の自動調整も付いています)。
※ PR:上の Amazon リンクはアフィリエイトリンクです。経由して購入されると、当サイトに紹介料が入ります。
Voice replication は「雑音のない自然な発話」を求めるので、録音の質がそのまま複製の質に直結します。実際、今回の録音は話していない部分の雑音がほぼゼロで、照合も1回で通りました。手順はこうです。
- 見本を先に録る。ナレーションに近い落ち着いた口調で、日常の話題を6文ほど。39秒録れたので、文の切れ目で25秒に切りそろえました(規定は10〜30秒)
- 同じマイク・同じ場所・同じ距離で同意文を録る。前後の無音を切って9秒
- 2本とも同じ処理で音量をそろえる。録音は平均 -35dB と小さめだったので、ラウドネス正規化(聞こえる音量をそろえる処理)で -20dB 前後に整えました
うまくいった理由は「同じ条件で録る」に尽きます。照合に落ちるとしたら、マイクや部屋が変わったときです。もうひとつ、同意文は読み間違えると照合以前に弾かれるので、一度声に出して練習してから録るのがおすすめです。
AI Studio では無料で試せず、有料キーが必要だった
最初は Google AI Studio(ブラウザで Gemini を試せる Google の画面)で試そうとしました。既製の声なら無料で試せます。ところが「音声の作成」から声の複製に進むと、こう表示されました。
ボイス レプリケーションは有料の階層で実行されます。
AI Studio 画面の表示(2026年9月27日)
流れは「プロジェクトと API キーを選択 → お支払い情報を設定 → API キーをリンク」。つまり声の複製は無料枠では試せません。公式の料金ページやドキュメントには、この制限がはっきり書かれていませんでした。
どうせ有料なら、ということで API(プログラムから直接モデルを呼ぶ窓口)を使う方法に切り替えました。やったことは3つだけです。
- AI Studio で、声の複製専用の API キーを新しく作る(他の用途のキーと共用しない)
POST /v1beta/voicesに見本と同意の録音を送って、声を登録する- 合成のリクエストで、返ってきた
voice_...を声として指定する
登録は1回で通りました。なお、API キーの画面には「10月12日までに前払いに切り替えると10ドル分のクレジット。それ以降は自動で前払いに切り替わる」という告知が出ていました。前払いなら残高以上は使われないので、使いすぎの心配が減ります。
複製した声で作った音声
ここからは、複製した管理人の声で作った音声です。元の録音(見本・同意)は載せていません。理由は記事の後半で説明します。
結婚相談所の CM 風ナレーション
管理人が運営している結婚相談所の紹介を、テレビ CM 風に読ませました。style(読み方の指示)には「energetic, upbeat TV commercial announcer, speaking with a big smile」を指定しています。約230字で36秒です。
台本も短い文と「!」で刻んで、CM らしいテンポにしました。30秒の枠に収めるなら、日本語で200〜230字が目安です。
エンジニア専門の結婚相談所の紹介:style 一行で17%短くなった
管理人の相談所は、エンジニア専門をうたっています。せっかくなので、その切り口の紹介も自分の声で作りました。「結婚相談所は何をしてくれるのか」と「うちの強み(診断ツールによる性格分析と、データに裏打ちされたカスタマイズ)」を、エンジニアに刺さる言葉で話しています。style は「warm, confident and inviting」で、84秒です。
社名は英字の「MetaMarry」ではなく、台本ではカタカナの「メタマリー」と書いています。読み方を確実に指定したい固有名詞は、カタカナで書くのが安全です。
聴き直してみると、これはこれで良いのですが、少し「ナレーション感」が強い。そこで台本はまったく同じまま、style だけを「energetic and expressive, lively intonation, talking directly to a friend」に変えて、元気で抑揚のある版も作りました。
| 版 | style | 長さ |
|---|---|---|
| 落ち着いた版 | warm, confident and inviting | 83.6秒 |
| 元気版 | energetic and expressive, lively intonation, talking directly to a friend | 69.0秒 |
同じ台本なのに14.6秒(約17%)短くなりました。話すテンポが上がり、語りかけるような抑揚が付いています。ナレーション寄りにするか、話しかけ寄りにするかは、style 一行で大きく切り替えられるということです。
紹介ナレーション(明るめ)
同じ相談所の紹介を、落ち着いた明るさで。約480字で81秒です。
短編ナレーション(日本語)
「AI によるシンギュラリティはもうすぐ」をテーマにした、ドキュメンタリー風の短編です。途中に <sigh>(ため息)と <long pause>(長い間)のタグを入れています。
日本語の見本だけで、英語も同じ声で読めた
見本は日本語で録っただけです。それでも英語の原稿を渡すと、同じ声のまま英語で読んでくれました。見本と違う言語で話させた場合の品質について、公式ドキュメントには記載が見当たりませんでしたが、日本語の見本1本でも英語は十分に実用的でした。
聴いてみた評価
品質は最高クラス、ただし「完璧すぎる」
聴いた瞬間の感想は「これは過去一」。雑音はまったくなく、本人が聴いて「ほぼ私」と感じるほどでした。
ただ、何本か聴いていると違和感の正体が見えてきます。丁寧すぎて、言い間違いが一度もないのです。人間は、どんなに慣れていても、どこかで詰まったり、言い直したり、語尾が揺れたりします。その不完全さがまったくない。AI だと言われれば「ああ、なるほど」と分かるのは、声そのものより、この完璧さのせいだと感じました。
公式の書き方ガイドにも「自然さを求めるなら、言いよどみ(えーと、うーん)を台本に書き込む」とあります。会話っぽさが欲しいときは、わざと不完全さを台本に足す必要がありそうです。
だからナレーション・説明には非常に向いている
裏を返すと、不完全さがあってはいけない用途には、これ以上ないということです。
- 商品やサービスの紹介ナレーション
- 手順の説明音声、マニュアルの読み上げ
- 動画の解説・字幕の代わりの音声
- 同じ内容を多言語で出したいとき
自分で録ると、言い間違えるたびに録り直しです。それが原稿を渡すだけで、一発で、しかも自分の声で仕上がります。何度も録り直した経験がある人ほど、この楽さは響くと思います。
感情の指定は「効きすぎる」
気になったのは感情の指定です。style に感情を書くと、大きくそちらに振れすぎます。「少しだけ明るく」「ほんのり落ち着いて」のような微調整が難しい。
同じ文を「指定なし → a little brighter → cheerful」の3通りで読ませて、つなげてみました。
公式ガイドは「まず style を空で試し、必要な所だけ短い指示を足す」「長い演出指示は声がぶれる原因」と勧めています。微調整したいときは、style を強く書く前に、台本の書き方(文の長さ・句読点・「!」)で調整してみるのも一つの手です(ここは今回きちんと比べてはいないので、試す価値のある方法として挙げておきます)。
漢字の読み間違いはゼロ
日本語の音声合成でいちばん困るのが、漢字の読み間違いです。今回の日本語原稿(合計約1,000字)では、読み間違いは一度もありませんでした。「正規加盟」「先回り」「積み上げてきた」のような言葉も、すべて正しく読めていました。
費用は1分あたり約2.6円
API の返答に含まれる使用量(トークン数。AI の処理量を数える単位)から、1本ずつ費用を出しました。出力トークンは返答の合計値(安全側の多いほう。理由は表の下で説明します)を使っています。単価は2026年9月27日時点の公式料金ページの値(入力 $0.50/100万トークン、音声出力 $9.00/100万トークン)で、1ドル150円で計算しています。
| 生成物 | 音声の長さ | 入力トークン | 出力トークン | 費用 |
|---|---|---|---|---|
| 日本語ナレーション | 73.6秒 | 177 | 2,356 | $0.0213(約3.2円) |
| 英語ナレーション | 49.5秒 | 147 | 1,584 | $0.0143(約2.1円) |
| 紹介ナレーション(明るめ) | 81.4秒 | 251 | 2,605 | $0.0236(約3.5円) |
| CM 風ナレーション | 36.0秒 | 125 | 1,154 | $0.0104(約1.6円) |
| エンジニア向け紹介 | 83.6秒 | 248 | 2,674 | $0.0242(約3.6円) |
| エンジニア向け紹介(元気版) | 69.0秒 | 248 | 2,208 | $0.0200(約3.0円) |
| 感情比較 3本 ※ | 26.5秒 | 約120 | 約846 | 約$0.0077(約1.2円) |
| 合計(9本) | 420秒 | 約1,320 | 約13,430 | 約$0.12(約18円) |
※ 感情比較の3本は使用量を控え損ねたため、音声の長さから推定しています。
1分あたり約2.6円なので、1時間分の音声でも約160円です。費用のほとんどは音声出力側で、台本の長さはほぼ効きません。作り直しも全部課金されますが、この単価なら10回作り直しても数十円で済みます。気をつけたいのは次の2点です。
- 単価は 2027年1月1日から2倍 になる予定
- 声の登録そのものの料金は、ドキュメントに記載がなかった
出力トークンの数え方が2つあり、請求はまだ確定していない
料金表には「10秒あたり $0.00225」とあり、ここから逆算すると音声は1秒25トークンです。ところが API の返答には、出力トークンの数え方が2つ入っていました。
- 返答の合計値(
total_output_tokens): どの生成でも 1秒32トークン - モデル呼び出しの内訳(
candidates_tokens_details): どの生成でも 1秒25トークン(料金表と一致)
どちらで請求されるかは、まだ分かりません。上の表は安全側の32トークンで計算しています。25トークンで請求されるなら、費用は表の約8割(全9本で約15円)になります。
もうひとつ、内訳には毎回音声633トークンの入力が含まれていました。これは登録した声の見本(25.3秒×25トークン)と一致するので、合成のたびに見本の声が入力として使われているようです。仮にこれが入力として請求されても1回 $0.0003(0.05円)ほどで、ほぼ影響はありません。実際の請求が確定したら追記します。
公開してはいけない録音と、残るリスク
最後に、いちばん大事な話です。
見本と同意の録音は、セットで公開しない
記事を書くにあたって、最初は「入力に使った録音も載せたほうが、聴き比べできて分かりやすい」と考えていました。でも、よく考えるとこれは危険です。
見本と同意の録音が2本そろえば、第三者がそれを使って、Google の審査を通して、管理人の声を複製できてしまいます。同意文の録音は、なりすましを防ぐための「鍵」そのものです。鍵を公開したら、鍵の意味がありません。
なので、この記事では元の録音は文章での紹介にとどめ、生成した音声だけを載せています。
生成した音声にも、リスクは残る
では生成音声なら安全かというと、そうとも言い切れません。生成した声を見本にして、さらに同意文を AI に読ませれば、同じことができてしまうのでは? という疑問が残ります。
公式ドキュメントには「本人による実際の録音が2本必要」と書かれていますが、AI で作った同意音声を見抜く仕組みがあるかどうかは明記されていません。生成音声には Google の電子透かし(SynthID)が入るとされていますが、それが同意の審査で使われているかも公表されていません。
つまり、自分の声の生成音声を公開するということは、講演や動画で自分の声を公開するのと同じ程度のリスクを負うということです。使うなら、次の4つは守っておきたいところです。
- 同意の録音は、どこにも公開しない・送らない
- 見本の録音も、長いものをそのまま公開しない
- 不要になった声は API から削除する(
DELETE /v1beta/voices/<ID>) - AI 生成であることを、動画や記事で明示する
この4つを守ったうえで使うのが、現実的な落としどころだと考えています。
向いている人・向いていない人
迷うとしたら、「自分の用途は、言い間違えないことが強みになるのか、それとも揺らぎが欲しいのか」という一点だと思います。
向いている人
- 自分の声で、商品紹介や解説のナレーションを量産したい人
- 録音のたびに言い間違えて、何度も録り直している人
- 同じ内容を日本語と英語で出したい人
向いていない人
- 感情の細かい強弱を作り込みたい人(ドラマ・朗読劇など)
- 人間らしい揺らぎや言いよどみが欲しい会話コンテンツ
- 無料で試したい人(声の複製は有料キーが必須)
30秒の見本と、1文の同意録音。準備はそれだけで、「言い間違えない自分」が手に入ります。同意の録音の扱いにだけは気をつけて、試してみてください。
続く実践編では、この複製ボイスを使って、VRAMVRAMグラフィックボードに載っている、GPU 専用の高速なメモリ。詳しく → 12GB の自宅 PC で72秒の紹介動画を1本作りました。声以外はすべてローカルで、クラウドに払ったのは声の約3円だけです。
→ 実践編:VRAM 12GB の自宅 PC で72秒の紹介動画を作った
出典
- Text-to-speech generation (TTS) | Gemini API
- Voice replication | Gemini API
- Gemini 3.8 Flash TTS | Gemini API
- Gemini Developer API pricing
- AT2020USB-XP 製品ページ(オーディオテクニカ)
- Gemini 3.8 text-to-speech says hello(Google Blog)
検証日・環境
- 検証日: 2026年9月27日
- モデル:
gemini-3.8-flash-tts(Gemini API・有料キー) - 録音: USB コンデンサーマイク(オーディオテクニカ AT2020USB-XP)、24kHz モノラル WAV
- 見本 25.3秒・同意 9.4秒(いずれもラウドネス正規化済み)
- 評価: 管理人本人による試聴
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
META-MARK × AI
AI モデル選びの次は、動かす場所です。
エージェントや自作ツールを止めずに動かすなら、常時稼働できる置き場所が要ります。手元の GPU で動かす場合の必要スペックも確認できます。


