VRAM12GBで35Bクラスが動く時代、Qwen3.5で確かめた3つの事実
Qwen3.5-35B-A3BをRTX 4070 Ti(VRAM 12GB)で動かした記録。Ollama非対応・Q2_K_L不可・IQ2_XSで突破。24問ベンチマーク:170/240 Rank B、113 tok/s。
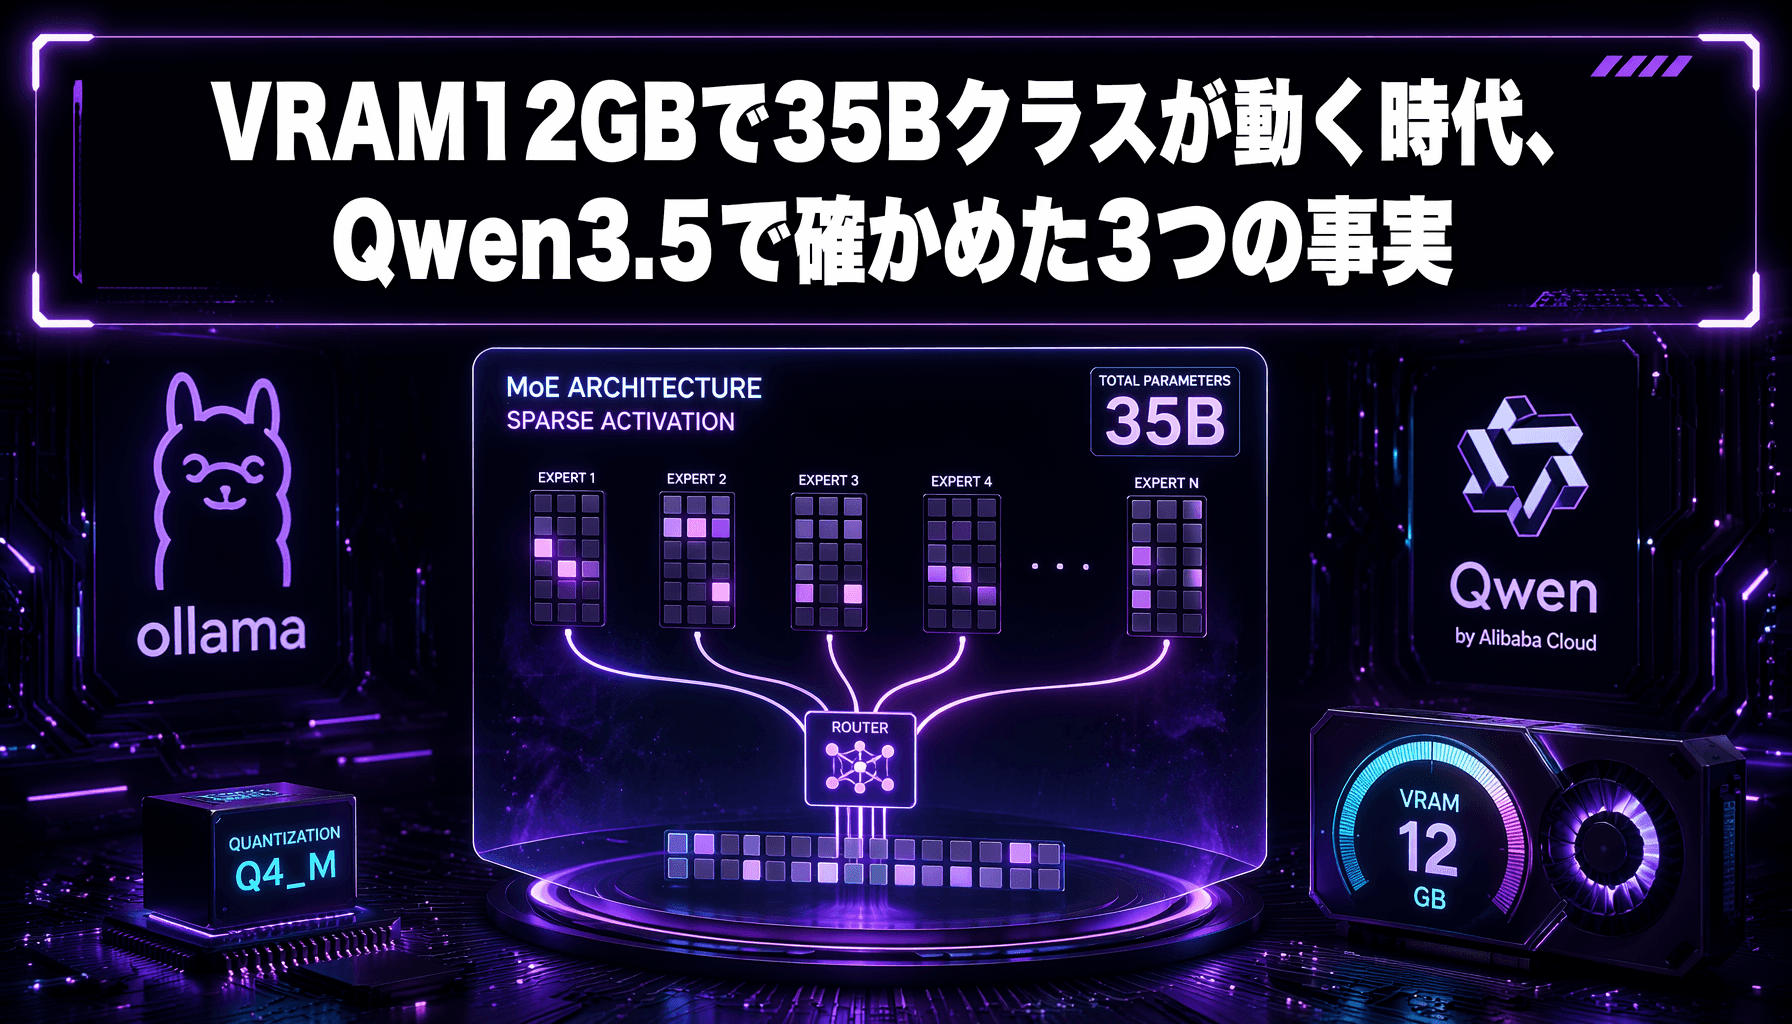
RTX 4070 Ti(VRAMVRAMグラフィックボードに載っている、GPU 専用の高速なメモリ。詳しく → 12GB)でQwen3.5-35B-A3Bを動かした。
Alibabaが2026年2月に公開したMoEモデルだ。35Bのパラメータを持ちながら、推論時のアクティブ量は3B相当という設計。「12GBで動く」という話が出回っていたので、実際に確かめることにした。
結論から言うと、動いた。ただし普通の方法では動かなかった。
① OllamaOllama(ローカルLLMランタイム)手元の PC でオープンウェイトの LLM を手軽に動かすための、無料のソフト。詳しく → v0.17.4はqwen35moeアーキテクチャ未対応(
unknown model architecture: qwen35moe) ② Q2_K_L(12GB GGUFGGUF(ggml Unified Format)llama.cpp 系のソフトでローカル LLM を動かす時に使う、モデルの保存形式。詳しく →)はVRAMに入らない——5MiB差でcudaMallocが失敗 ③ IQ2_XS(9.3GB GGUF)が正解——VRAM使用量10.8GB、約1GB余裕あり ④ 24問ベンチマーク:170/240(70.8%)Rank B / 113 tok/s
📋 この記事で使用したテスト問題(全24問)は LLM 24問テストスイート で確認できます。
この記事の構成
テスト環境
| 項目 | 値 |
|---|---|
| モデル名 | Qwen3.5-35B-A3B |
| パラメータ数 | 35B総数 / アクティブ3B(MoE) |
| 量子化量子化(Quantization)AI モデルの数値を少ない桁数で表し直して、ファイルと必要なメモリを小さくする手法。詳しく → | IQ2_XS(9.3GB GGUF)※imatrix最適化量子化 |
| 推論フレームワーク | llama-server(llama.cpp CUDA build) |
| CPU | AMD Ryzen 9 5900(24コア) |
| GPU | NVIDIA RTX 4070 Ti(VRAM 12GB) |
| VRAM使用量 | 10,803〜10,811 MiB(空き約1GB) |
| 推論速度 | 113.4 tok/s |
| コンテキスト長コンテキスト長(Context Length)AI が1回のやりとりでまとめて扱える文章の長さの上限。トークン数で表す。詳しく →(ctx) | 16384 tokens |
| temperature | 0.3(全問固定) |
| max_tokens | 8192 |
| テスト日 | 2026-03-01 |
壁① Ollamaが対応していない
まずOllamaで動かそうとした。v0.17.4(最新版)に更新して、BartowskiのHugging FaceリポジトリからGGUFを引っ張ろうとすると。
unknown model architecture: qwen35moe
GGUFのアーキテクチャ識別子が qwen35moe なのだが、Ollama 0.17.4に内蔵されているllama.cppが未サポートだ。Q2_K_LでもIQ2_XSでも同じエラーが出る。Ollamaでは現時点では動かない。
解決策はllama-serverを使うこと。Ollamaが内蔵するllama.cppより新しいコミットのCUDAビルドは、qwen35moeに対応している。
Ollamaの「Hugging FaceのGGUFを直接pullできる」仕組みは確かに便利だ。ただしリリース直後のモデルはllama.cpp本体が先行サポートする。GUIツールの快適さを前提にしていると、新しいアーキテクチャのモデルで詰まることがある。
壁② Q2_K_Lが12GBに入らない理由
llama-serverで試したところ、今度は別の問題が出た。
Q2_K_Lは12.8GBのGGUFファイルだ。VRAMへの実際の要求量は11,737MiB——12GBに収まるはずだった。実際のエラーがこれ。
cudaMalloc failed: needs 11737.53MiB, free 11743MiB
空きは11,743MiB。差は5MiB。なのに失敗する。
nvidia-smiが報告する「空きメモリ」とCUDAアロケーターが実際に使える連続メモリ領域は一致しない。MoEモデルの場合、全エキスパート重みが単一CUDAバッファに確保されるため、--ngl でGPU層数を調整する手も効かない。5MiBのヘッドルームでは足りなかった。
| 量子化 | ファイルサイズ | VRAM要求量 | RTX 4070 Ti 12GB |
|---|---|---|---|
| Q2_K_L | 12.8GB | ~11,737 MiB | ❌ 5MiB差で失敗 |
| IQ2_XS | 9.3GB | ~10,808 MiB | ✅ 約1GB余裕 |
| IQ2_S | 9.8GB | ~11,300 MiB | 要確認 |
| Q3_K_S | ~18GB | ~16,000 MiB+ | ❌ VRAM不足 |
解決:IQ2_XS(9.3GB)で突破
IQ2_XSとは、imatrixと呼ばれる重要度スコアで圧縮対象を選別する量子化手法だ。通常のIQ2(均一2bit量子化)より品質劣化が少ない。
IQ2_XS(9.30GB)に切り替えたところ、起動した。VRAM使用量は10,803〜10,811MiB。約1GBの余裕が生まれた。
起動後の速度は113.4 tok/s。MoE設計のアクティブパラメータが3B相当のため、これだけの速度が出る。手元の7Bモデルと大差ない速度感だ。
「12GBで動く」は正確には「IQ2_XSを選べば10.8GBで動く」だ。Q2_K_Lは無理。IQ2_XSが正解。
24問ベンチマーク
意地悪(A)・論理(B)・コーディング(C)・日本語(D)の各6問、計24問。採点はClaude Sonnet 4.6(10点満点)。
スコアサマリー
| カテゴリ | スコア | 比率 |
|---|---|---|
| A(意地悪) | 43/60 | 71.7% |
| B(論理) | 40/60 | 66.7% |
| C(コード) | 50/60 | 83.3% |
| D(日本語) | 37/60 | 61.7% |
| 合計 | 170/240 | 70.8% |
ランク:B(60〜74%ライン)
LLMLLM(大規模言語モデル)大量の文章で学習し、人のように文章を読み書きできる大きな AI のモデル。詳しく →性格診断:「思考過多型」
24問中6問(A6・B5・B6・C6・D1・D3)が空回答だった。共通の原因は「推論チェーンが8192トークンを全消費して、最終回答が出力されなかった」こと。難しい問題ほど丁寧に考えようとする。その丁寧さが、答えを出せない結果につながった。
Round 1:意地悪・引っかけ問題(43/60)
A1〜A2・A4〜A5はパーフェクト(各10点)。引っかけのパターンを見抜いて正解に辿り着く能力は問題ない。A3は途中で迷走したが立て直して3点。
A6が空回答。推論チェーンがmax_tokensを使い切った。
「騙されない」力はある。ただし複雑な引っかけには考え込みすぎる傾向がある。
Round 2:論理・推論パズル(40/60)
B1〜B4がすべて10点。論理を積み上げる問題では安定していた。推論の流れが整然としていて、採点しやすい回答が出てきた。
B5・B6は空回答。どちらも複雑な推論が必要な問題で、同じパターンで詰まった。
論理問題は得意だが、難易度が上がると推論が暴走する。max_tokensを16384以上に設定すれば改善が見込める。
Round 3:コーディング(50/60)
ここが今回の見どころだった。C1〜C5がすべて10点。
コードの正確さだけでなく、変数名・コメント・エラーハンドリングの設計まで採点したが、すべて問題なかった。「コーディング補助として実用になるか」という問いへの答えは、このラウンドで出た。C6だけ空回答。
コミュニティで言われている「コーディング能力が高い」という評価は、今回の数字(83.3%)でも裏付けられた。
Round 4:日本語(37/60)
D2・D4・D6は10点。基本的な日本語の理解と生成は問題ない。D5(7点)は惜しい部分はあったが許容範囲だ。
D1・D3が空回答。日本語の細かいニュアンスを問う問題で詰まった。IQ2_XS量子化が日本語の微妙なコンテキストに影響している可能性もある。
日常的な会話・要約・翻訳程度なら実用的なレベルだ。
最終スコアカード
A(意地悪): 43/60  (71.7%) ████████████████████░░░░░
B(論理)  : 40/60  (66.7%) █████████████████░░░░░░░░
C(コード): 50/60  (83.3%) █████████████████████░░░░
D(日本語): 37/60  (61.7%) ████████████████░░░░░░░░░
──────────────────────────────────────────────────
合計       : 170/240 (70.8%) → Rank B
よくある質問
Q. Ollamaではいつ動くようになりますか? Ollamaが内蔵するllama.cppが更新されれば対応される。新しいアーキテクチャはllama.cpp本体が先行するため、数週間〜数ヶ月のラグがあることが多い。現時点ではllama-serverが唯一の選択肢だ。
Q. Q2_K_L(12GB)は本当に12GBのVRAMには入りませんか? RTX 4070 Ti 12GBでは動かなかった。理論値では5MiBの余裕があるが、CUDA allocatorのオーバーヘッドで失敗する。RTX 4080(16GB)以上なら問題ないはずだ。
Q. max_tokensを増やせばスコアは上がりますか? 空回答の6問については改善が見込める。8192を16384〜32768に設定すれば、推論を最後まで走らせられる問題が増える。KVキャッシュが増えるがVRAM影響は軽微な範囲だ。
Q. コーディング補助として実用になりますか? 今回の結果(C: 83.3%)では十分に実用レベルだ。llama-serverのセットアップという前提はあるが、その先の品質は今回の数字が示している。
所感
動いた。思ったより速かった。
113 tok/sは、手元の7B denseモデルと大差ない速度感だ。35Bのパラメータを持ちながら、実質3B分の計算量で推論するMoE設計の合理性が、この数字に表れている。
ただし「Ollamaで手軽に動かせる」という話ではない。現時点ではllama-serverを自前でビルドする必要がある。Q2_K_Lが12GBに入らないことも含めて、「12GBで動く」という話には2つの前提が隠れている。これは正直に書いておきたい。
コーディング補助として毎日使うモデルを探しているなら、今回の結果(C: 83.3%)は参考になるはずだ。
今後の予定: Ollama側がqwen35moeをサポートした時点で、同条件(IQ2_XS / ctx 16384)で再テストし、セットアップ難易度込みの比較記事を書く予定だ。また、Q4_K_M(24GB環境)との品質差も計測したい。
Ollamaで動くローカルLLMの全体像はOllamaワークロードガイドにまとめてある。VRAMごとのGPU選びはGPUランキングで確認できる。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事
Qwen3.5:4b 24問テスト——thinkingをOFFにしたらスコアが21%上がった話
Qwen3.5:4bをOllama上でベンチマーク。thinkingモードが原因で9問が空回答になった。think:falseに切り替えたらスコアが194/240(80.8%)に回復。RTX 4070 Tiで101.5 tok/s出る4Bモデルの実力を24問で徹底検証。
Nemotron-Nano-9B日本語版を実測——NVIDIA日本語特化LLMの実力と限界
NVIDIAが開発した日本語特化ローカルLLM「Nemotron-Nano-9B-v2-Japanese」をUbuntuサーバー(RTX 4070 Ti)に実際にインストールして動かした実録。日本語品質・速度・VRAM使用量を正直に評価。
Ollamaでローカルにチャットを住まわせた記録 — インストールからモデル選びまで
Ollamaを使ってローカルLLMを動かした実録。インストール手順・VRAM別モデル選び・実際に使って感じた正直な評価まで。RTX 4070 Ti(12GB)環境での体験ベース。
自殺相談窓口を貼ってくるAI——Qwen3.5:9bに意地悪問題を24問ぶつけた結果
ローカルLLM Qwen3.5:9b(9.7B Q4_K_M)に意地悪・論理・コード・日本語の24問テストを実施。180/240点(75%)ランクAの「空気読めない秀才型」。お墓問題で相談窓口を貼ってきた話も含めて正直に報告。
関連AIツール
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:GPU・キャリアまわりのサービス
 OZ GAMINGの構成を見る
 strategy career の転職支援を見る