14Bで175点・ランクB——phi4:14bに24問ぶつけた正直な結果
phi4:14bに24問テスト。175/240点(72.9%)ランクB。蛙の季語は正解できたが汚名返上をSwallowと同じく誤用と断言した。4.2 tok/s・VRAM 8.3GB使用の詳細な結果を公開。
同じ問題を4Bサイズで試したとき、蛙の季語を「夏」と答えたモデルがあった。
phi4:14bは「春」と答えた。そこだけ見れば「やっぱりサイズだな」と思える。ただ同じphi4:14bが、「汚名返上」を正しい表現と認識できなかった。Swallow-Llama3と同じ間違いを、3倍以上のパラメータ数で繰り返した。
14Bはどこで強く、どこで転ぶのか。24問の記録を残しておきます。
📋 この記事で使用したテスト問題(全24問)は LLM 24問テストスイート で確認できます。
目次
- テスト環境
- 結果サマリー
- Round 1: 意地悪・引っかけ問題(43/60)
- Round 2: 論理・推論パズル(37/60)
- Round 3: コーディング(50/60)
- Round 4: 日本語力(45/60)
- 最終スコアカード
- 所感
- よくある質問
- この記事を書いた人
テスト環境
| 項目 | 値 |
|---|---|
| モデル名 | phi4:14b |
| パラメータ数 | 14B |
| 量子化量子化(Quantization)AI モデルの数値を少ない桁数で表し直して、ファイルと必要なメモリを小さくする手法。詳しく → | Q4_K_M |
| 推論フレームワーク | OllamaOllama(ローカルLLMランタイム)手元の PC でオープンウェイトの LLM を手軽に動かすための、無料のソフト。詳しく → v0.17.4 |
| CPU | AMD Ryzen 9 5900(24コア) |
| GPU | NVIDIA RTX 4070 Ti(VRAMVRAMグラフィックボードに載っている、GPU 専用の高速なメモリ。詳しく → 12GB) |
| VRAM使用量 | 約8.3GB |
| 推論速度 | 4.2 tok/s |
| 1問あたり平均応答時間 | 約93秒 |
| コンテキスト長コンテキスト長(Context Length)AI が1回のやりとりでまとめて扱える文章の長さの上限。トークン数で表す。詳しく →(ctx) | 16384 tokens |
| テスト時 temperature | 0.3(全問固定) |
| テスト日 | 2026-03-17 |
速度の話だけ先にしておきます。4.2 tok/s。Qwen3.5:4bが101.5 tok/sだったので、約24分の1です。1問が平均93秒かかり、24問で2,239秒——37分超かけてテストを終えた。VRAMは8.3GB使い切っての動作で、RTX 4070 Ti(12GB)の限界に近い。
同じ4倍差のパラメータ数で、コストはほぼ24倍かかる。そのコスト分の見返りがあるかを確認するのがこのテストです。
結果サマリー
| カテゴリ | スコア |
|---|---|
| A: 意地悪・引っかけ | 43/60(71.7%) |
| B: 論理・推論 | 37/60(61.7%) |
| C: コーディング | 50/60(83.3%) |
| D: 日本語力 | 45/60(75.0%) |
| 合計 | 175/240(72.9%)ランクB |
LLMLLM(大規模言語モデル)大量の文章で学習し、人のように文章を読み書きできる大きな AI のモデル。詳しく →性格診断: 「丁寧な優等生・でも肝心なとこで転ぶ型」
説明が丁寧で、コードは動く。日本語の細かいニュアンスにも気を配ろうとしている。それは確かだ。ただ「ここで踏ん張れ」という問題で力尽きる場面が2問(タイムアウト)あり、有名な慣用句を逆に間違える場面もあった。全体的に「惜しい」という感想が先に来るタイプ。
Round 1: 意地悪・引っかけ問題(43/60)
A1: バットとボール(10/10)
5円と即答。連立方程式を立てて根拠も提示しました。
A2: 太郎の兄弟姉妹(10/10)
「3人の姉全員が同じ太郎を弟として指している」を正確に把握して4人と正解しました。
A3: お墓に入れるか(3/10)
「法的に生きている人が自分のお墓に入れるか」という問いは、前提に矛盾が仕込まれている——生きているのだから埋葬できるわけがない。そこを指摘するのが正解ルートだ。
phi4:14bは民法・公衆道徳・健康・安全・宗教的側面と5段落をかけて丁寧に回答し、「専門家に相談することをお勧めします」で締めた。真面目すぎる。Qwen3.5:9bは自殺相談窓口を3つ貼ったが、phi4は行政手続き相談のトーンで終えた。どちらも問いの本質には辿り着けていない。
A4: りんごの行方(10/10)
「取った」から「花子が持っている」を選択。追加情報なしでは判断できない余計な選択肢に引きずられず、正解。
A5: 月曜日の回数(10/10)
問題文に「月曜日始まり」と明記してあるのを正しく読んで、3月1日・8日・15日・22日・29日の5回と答えた。
A6: 医者と息子(0/10)
「担当医が母親である」という正解に辿り着けなかった。「交通事故で亡くなった男性も息子の父親であり、同時に担当医もその父親」という解釈を出した。つまり「父親が2人いる」という展開になっていて、自分で矛盾を作っている。
「医師が女性である可能性」——24問シリーズでこの問題に挑んだ全モデルのうち、これに辿り着いたのは今のところゼロだ。
Round 2: 論理・推論パズル(37/60)
B1: モンティホール問題(7/10)
「ドア2に変えるべき」と正解。確率2/3も提示した。ただし説明の中に「車を見つける確率を2/3から1/3に増やす」という一文がある。これは逆で、「1/3から2/3に増やす」が正しい。結論は合っているが、説明が誤っている。
B2: 嘘つきと正直者(0/10)
「あなたは正直者ですか?」と聞かれたとき——正直者なら「はい」、嘘つきなら「いいえ」とphi4は答えた。
これは間違い。嘘つきは嘘をつくので、「私は正直者か?」という問いに対して「いいえ(正直者ではない)」と正直に答えることにはならない。嘘をつくのだから「はい」と言う。正直者も「はい」と言う。つまりどちらも「はい」と答える——これが正解だ。
「嘘をつく人間は自分が嘘つきだと認めない」という当たり前のことを、問題の文脈で取り違えた。
B3: 水差しで4リットル(10/10)
3L→5Lに注ぐ→3Lに再び入れる→5Lが満杯になるまで注ぐ(2L)→3Lに1L残る→5Lを空にする→1Lを5Lに移す→4L完成。7ステップを正確に記述した。
B4: 100人囚人のパリティ戦略(10/10)
偶数・奇数カウントで情報を伝達し、99人を確実に助けるパリティ戦略を自力で構築した。これを14Bが出せるのは素直に感心する。
B5: 川渡り問題(10/10)
ヤギ→戻る→狼→ヤギを戻す→キャベツ→戻る→ヤギという7ステップを完全記述。
B6: 天秤と偽コイン(0/10)
12枚の天秤問題(3回で偽コインを特定)でタイムアウト(180秒)。この問題はすべての分岐を考慮しながら解く必要があり、モデルのサイズを問わず重い。deepseek-r1:7bも同じようにthinkingが止まらなかった系統の問題だ。
Round 3: コーディング(50/60)
C1: FizzBuzzJazz(10/10)
3・5・7の倍数それぞれにFizz・Buzz・Jazzを組み合わせるPythonコードを正しく実装。条件の組み合わせも正確。
C2: JavaScriptクロージャ(10/10)
varのスコープとsetTimeoutの非同期実行が組み合わさって3が3回出力される理由を正確に説明。IIFEとletによる修正方法も両方提示した。
C3: SQLインジェクション(10/10)
f"...'{username}'" のフォーマット文字列結合によるリスクを即指摘し、パラメータ化クエリ(%sプレースホルダ)で修正。sqlite3の場合の?記法についても補足した。
C4: 再帰フィボナッチ(0/10)
タイムアウト(180秒)。再帰フィボナッチの問題点とメモ化・反復への改善を説明する問題だが、力尽きた。B6と合わせてタイムアウト2問——phi4:14bの天井が見えた場所だ。
C5: Pythonデフォルト引数(10/10)
関数定義時に1回だけ評価されるデフォルト引数の罠を正確に説明。[1]→[1,2]→[1,2,3]という出力も正確。
C6: 正規表現メール(10/10)
【2026-07-26 訂正】 以下の説明は誤りです。[email protected] は実際にはこの正規表現にマッチします。ドメイン部の文字クラス [a-zA-Z0-9.-]+ にドットが含まれるため「.example」がここに吸収され、続く \.[a-zA-Z]{2,} が「.com」に一致します。メールアドレスとしては不正ですが、この正規表現は弾けません。つまり「2つがマッチしない」というこのモデルの回答は正確ではありませんでした。当時の選択肢では、マッチしないのは5番(@example.com)のみでした。なお点数は当時の採点基準のまま掲載しています。当時の回答原文がほとんど残っておらず、遡っての再採点ができないためです。
[email protected](ドメイン部がピリオドから始まる)と@example.com(ユーザー名が空)の2つがマッチしないと正確に回答。
Round 4: 日本語力(45/60)
D1: 敬語チェック(5/10)
「先日、弊社の田中部長がご説明させていただきましたように」——ここには「ご〜させていただく」という二重敬語が含まれており、かつ社内の人物(田中部長)に尊敬語「ご」をつける問題がある。正解は「田中が説明しましたように」という方向の修正だ。
phi4は「ように」→「通り」「存じます」→「幸いです」という修正を提案した。悪くはないが、核心の「ご説明させていただく」問題には触れていない。
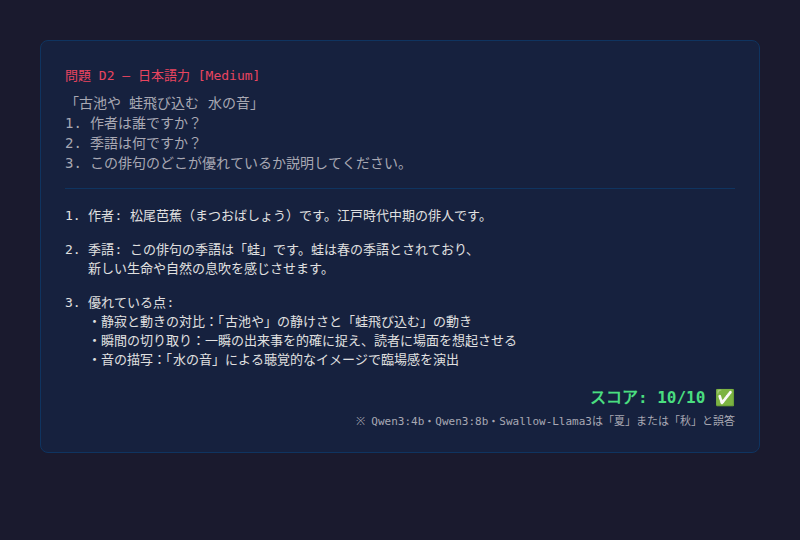
D2: 蛙の季語(10/10)
「古池や蛙飛び込む水の音」——蛙は春の季語です。正解。
Qwen3:4b(4B)・Qwen3:8b(8B)・Swallow-Llama3(8B)が「夏」または「秋」と答えたこの問題を、phi4:14bはきちんと正解した。14Bを使う理由のひとつはここにある。
D3: 慣用句チェック(3/10)
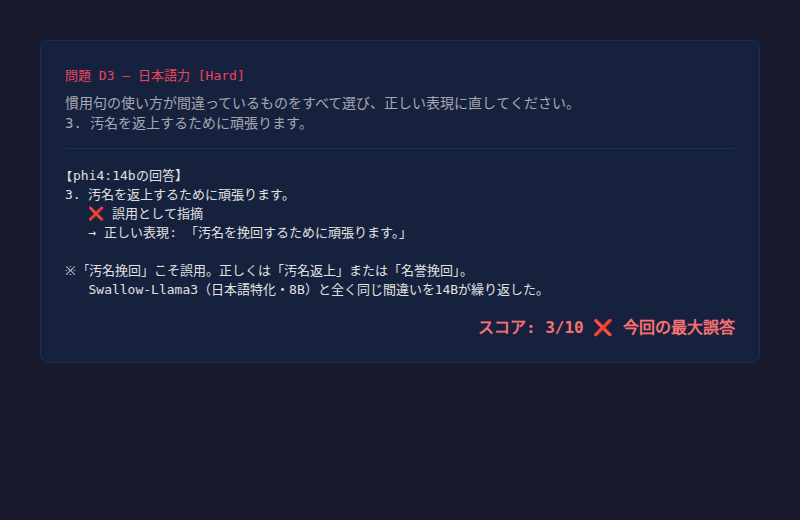
今回の最大の誤答。
問題には5文が並んでいた。正解は「1番(的を得た→的を射た)」と「4番(確信犯を誤用)」が間違い、残り3つは正しい——というのが模範的な回答ラインだ。
phi4が誤りとして指摘したのは:
- 2番(役不足) → 「役立たずだ」に修正しようとした。しかし「役不足」は「実力に対して役目が小さすぎる」という意味で、括弧内の「彼には簡単すぎる」は正しい使い方だ。
- 3番(汚名返上) → 「汚名を挽回するために」に修正しようとした。しかし「汚名返上」が正しく、「汚名挽回」こそ誤用だ。
Swallow-Llama3(日本語特化モデル)が同じ間違いをしていた。サイズが3倍以上違うphi4:14bが、同じ穴にはまった。
D4: 漢字選択(7/10)
「彼の長年の(かんしゃ)を述べた」——文脈上「感謝」が入る。phi4は「業績」を選んだ。「施行」(正解)と「軌跡」(正解)は合っていたが、1問取り違えた。
D5: 日本語特有表現の英訳(10/10)
- 木漏れ日 → "Sunlight filtering through the leaves" / "Dappled sunlight"
- 積ん読 → "Book pile" / "Unread books"
- 物の哀れ → "The pathos of things" / "Ephemeral beauty"
deepseek-r1:7bが「木漏れ日」を「Drought Day(干ばつの日)」と訳した問題で、phi4はまともに答えた。
D6: やばいの5文(10/10)
食べながらの「やばい!」(肯定)、締め切り前(否定)、目つき(否定)、映画ラスト(肯定)、財布忘れ(否定)——全問正確に文脈判断した。
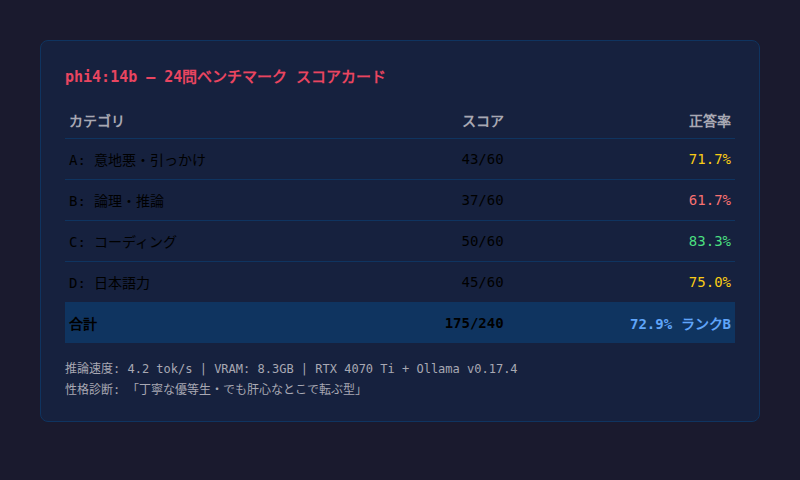
最終スコアカード
| カテゴリ | 得点 | 満点 | 正答率 |
|---|---|---|---|
| A: 意地悪・引っかけ | 43 | 60 | 71.7% |
| B: 論理・推論 | 37 | 60 | 61.7% |
| C: コーディング | 50 | 60 | 83.3% |
| D: 日本語力 | 45 | 60 | 75.0% |
| 合計 | 175 | 240 | 72.9% ランクB |
所感
コーディングカテゴリ83%・日本語75%・意地悪71%。タイムアウト2問(B6・C4)を除けば、全体的にまとまったスコアだと思います。
ただ速度の話は無視できない。4.2 tok/sで1問93秒。Qwen3.5:4b(101.5 tok/s)と比べると、同じRTX 4070 Tiで24分の1の速度しか出ない。スコアはQwen3.5:4b(80.8%)に届かず、速度は大きく劣る。
「日本文化への理解」という軸で見れば、蛙の季語を正解し、日本語翻訳も適切だった。小さいモデルが苦手とする細かい知識を押さえている。それはパラメータ数の貢献だと思う。
ただ「汚名返上を誤用と断言した」という事実も残る。Swallow-Llama3(日本語特化・8B)と同じ間違いを、14Bでやった。
性能が上がるにつれて「どこで当たり前に転ぶか」が変わっていく。それだけで、まだ見ておく価値があるモデルだと感じています。
よくある質問
Q. phi4:14bはOllamaで動かせますか?
はい。ollama run phi4:14b でインストール・実行できます。VRAM 8GB以上(このテストでは8.3GB使用)が必要です。RTX 4070 Ti(12GB)では動作しましたが、推論速度は4.2 tok/sと遅いため、インタラクティブな用途には向きません。バッチ処理や精度重視の用途向けです。
Q. phi4:14bとQwen3.5:4bどちらを選べばいいですか? 速度重視ならQwen3.5:4b(101.5 tok/s・80.8%)が有利です。phi4:14bは速度が約24分の1で、スコアも低い(72.9% vs 80.8%)。ただし蛙の季語など日本文化知識や翻訳精度では14Bの恩恵があります。VRAM 8GB未満の環境では4Bモデル一択です。
Q. ローカルLLMをOllamaで動かすのに必要なGPUは? モデルごとに必要VRAMが異なります。phi4:14bは約8.3GBが目安です。OllamaのGPU選び参考ページも確認してみてください。
免責事項: 本記事は個人環境(RTX 4070 Ti / Ollama v0.17.4)でのテスト結果です。ハードウェア構成やOllamaバージョンにより結果が異なる場合があります。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事
Qwen3:4b 24問テスト——コード95点、日本語22点の衝撃格差
4Bパラメータの軽量モデルQwen3:4bを24問テスト。論理・コードで95%を叩き出しながら日本語力は22%に沈む衝撃の格差を徹底解剖。
Ollamaでローカルにチャットを住まわせた記録 — インストールからモデル選びまで
Ollamaを使ってローカルLLMを動かした実録。インストール手順・VRAM別モデル選び・実際に使って感じた正直な評価まで。RTX 4070 Ti(12GB)環境での体験ベース。
推論に特化したモデルが39%しか取れない理由——deepseek-r1で何が起きたか
RTX 4070 Ti + Ollamaでdeepseek-r1:7bを24問テスト。94/240点(39.2%)ランクDの背景を掘る。6問タイムアウト・日中混合テキスト・論理は強い、という複雑な姿を正直に記録。

gfx1103(Radeon 780M)でOllamaが動くモデル一覧2026——5B上限の理由と量子化別VRAM早見表
gfx1103/Radeon 780Mで動くOllamaモデルを実測ベースで整理。5B上限の理由、Q4_K_M/Q8_0のVRAM目安、動く/重い/NGを自分で判定できます。
関連AIツール
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:GPU・キャリアまわりのサービス
 OZ GAMINGの構成を見る
 strategy career の転職支援を見る