GPT-5.6 Sol×Terra、コスパ最強のEffort組み合わせは?実測で検証
GPT-5.6 Sol(設計・計画役)とTerra(コーディング実装役)を組み合わせて使う際、どのreasoning effortが最もコスパが良いかをArtificial Analysisの実測データで検証。Solはhighで頭打ち、Terraはhighまで気軽に上げてよい理由を出典付きチャートで確認します。

こんにちは。蝉の声がそろそろ聞こえ始める頃ですが、今回も「待ち時間」の話です。AI の返事を待つ時間と、その分だけ賢くなるのかどうかを、GPT-5.6 の2つのモデルで並べました。
先に結論です。GPT-5.6 の Sol(設計・計画向けのフラグシップ)と Terra(バランス型で、実装向け)を組み合わせて使うなら、Sol は high で止め、Terra はタスクの複雑さに合わせて high まで気軽に上げてよい、というのが実測データから見えた線引きでした。effort は「AI にどれだけ考えさせるか」の設定です。Artificial Analysis の実測では、Sol は high で賢さの点数(Intelligence Index)の伸びがほぼ頭打ちになり、xhigh へ上げても 56→58 とわずか2点。一方の Terra は、low→medium→high と上げても最初の文字が出るまでの待ち時間(TTFT)がゆるやかにしか増えず、点数は素直に伸びます。
私は普段、設計や計画立案は Sol、実際に手を動かすコーディングは Terra に任せる役割分担で GPT-5.6 を使っています。ただ、それぞれを何 effort にするかは、正直なところ勘でした。とりあえず設計も実装も high にしておけば安心、くらいの感覚です。そこで Artificial Analysis の実測データ(一次情報として保存したページから出典付きで引用)で、Sol と Terra の effort 別のコスパを並べたところ、「effort を上げれば上げるほど良い」わけではない、はっきりした境目が見えました。
Sol は旗艦、Terra は日常業務向けという位置づけ
OpenAI の公式発表では、GPT-5.6 ファミリーの Sol は「知能と効率の両面で新標準を打ち立てる」新フラグシップ、Terra は「日常業務向けのバランス型モデル」と位置づけられています(保存ページ確認、2026-07-11)。
私を含め多くの vibe coder(AI に指示してコードを書いてもらう人)は、これを「設計・計画で妥協したくない場面は Sol、日常の実装作業は Terra」という役割分担として使っています。この記事はその分担を前提に、それぞれ何 effort で動かすのがコスパの面で妥当かを確かめます。なお、この分担はあくまで一般的な運用上の使い分けで、OpenAI が用途を指定しているわけではありません。
Luna を含めた GPT-5.6 全体の effort の実測は、GPT-5.6のeffort、maxにすると何倍遅い?実測で見る使い分け にまとめています。あわせて読むと、今回の数字がどこに位置するのかがつかみやすくなります。
Sol は low→high で7点伸び、high→xhigh では2点だけ
ここからの数字は OpenAI の公式発表値ではなく、第三者のベンチマーク機関 Artificial Analysis が自分で計測した実測値です(保存日時2026-07-10、Artificial Analysis)。表の Output Speed は1秒あたりに出す文字の量(トークン数)、右の2列は料金の単価です。
| Effort | Intelligence Index | Output Speed (t/s) | TTFT (秒) | 入力$/1M | 出力$/1M |
|---|---|---|---|---|---|
| low | 49 | 67.1 | 2.21 | $5.00 | $30.00 |
| high | 56 | 73.0 | 7.00 | $5.00 | $30.00 |
| xhigh | 58 | 70.8 | 42.65 | $5.00 | $30.00 |
料金の単価は effort を変えても同じですが、考える量が増えるぶん、1つのタスクにかかるお金(タスク単価)は上がっていきます。コストと賢さの散布図で見ると、effort を上げるほど点が右(高コスト)へ動いていくのが分かります。
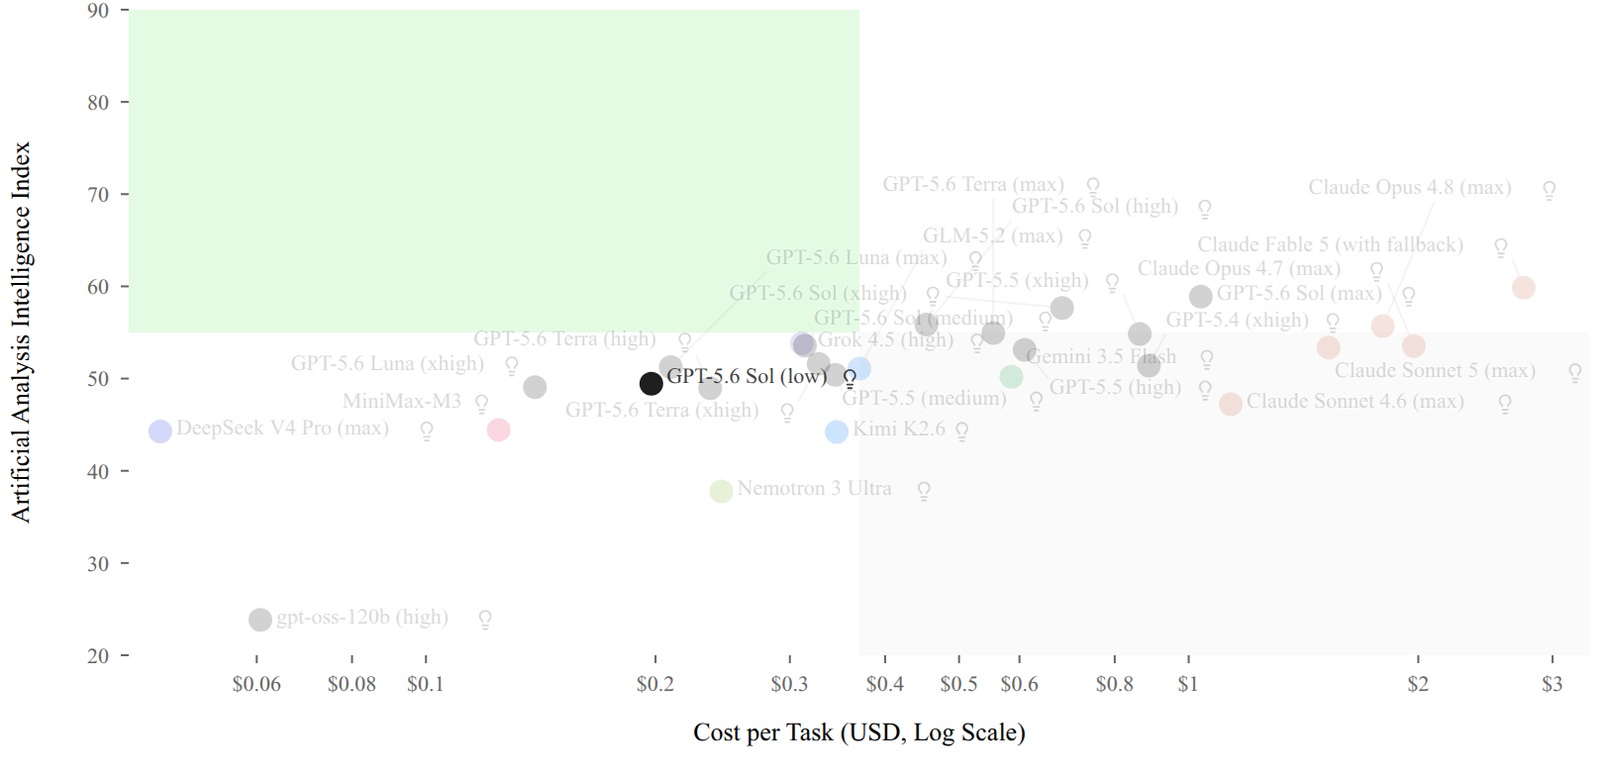 Sol(low effort)はタスク単価約0.2ドルでIntelligence Index 49の位置にある(出典: Artificial Analysis https://artificialanalysis.ai/models/gpt-5-6-sol-low)
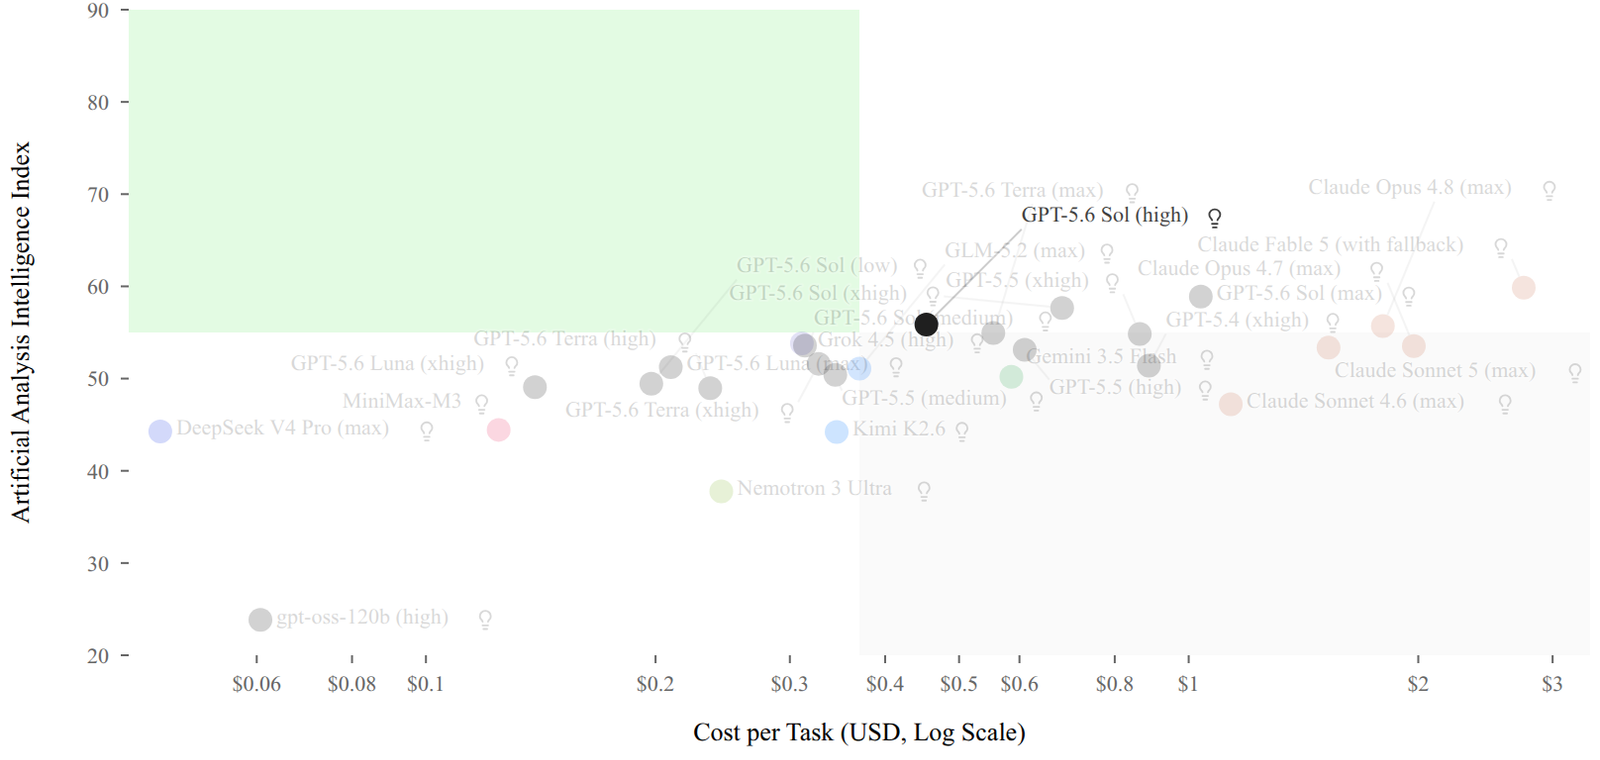 Sol(high effort)はタスク単価約0.42〜0.45ドルでIntelligence Index 56まで伸びる(出典: Artificial Analysis https://artificialanalysis.ai/models/gpt-5-6-sol-high)
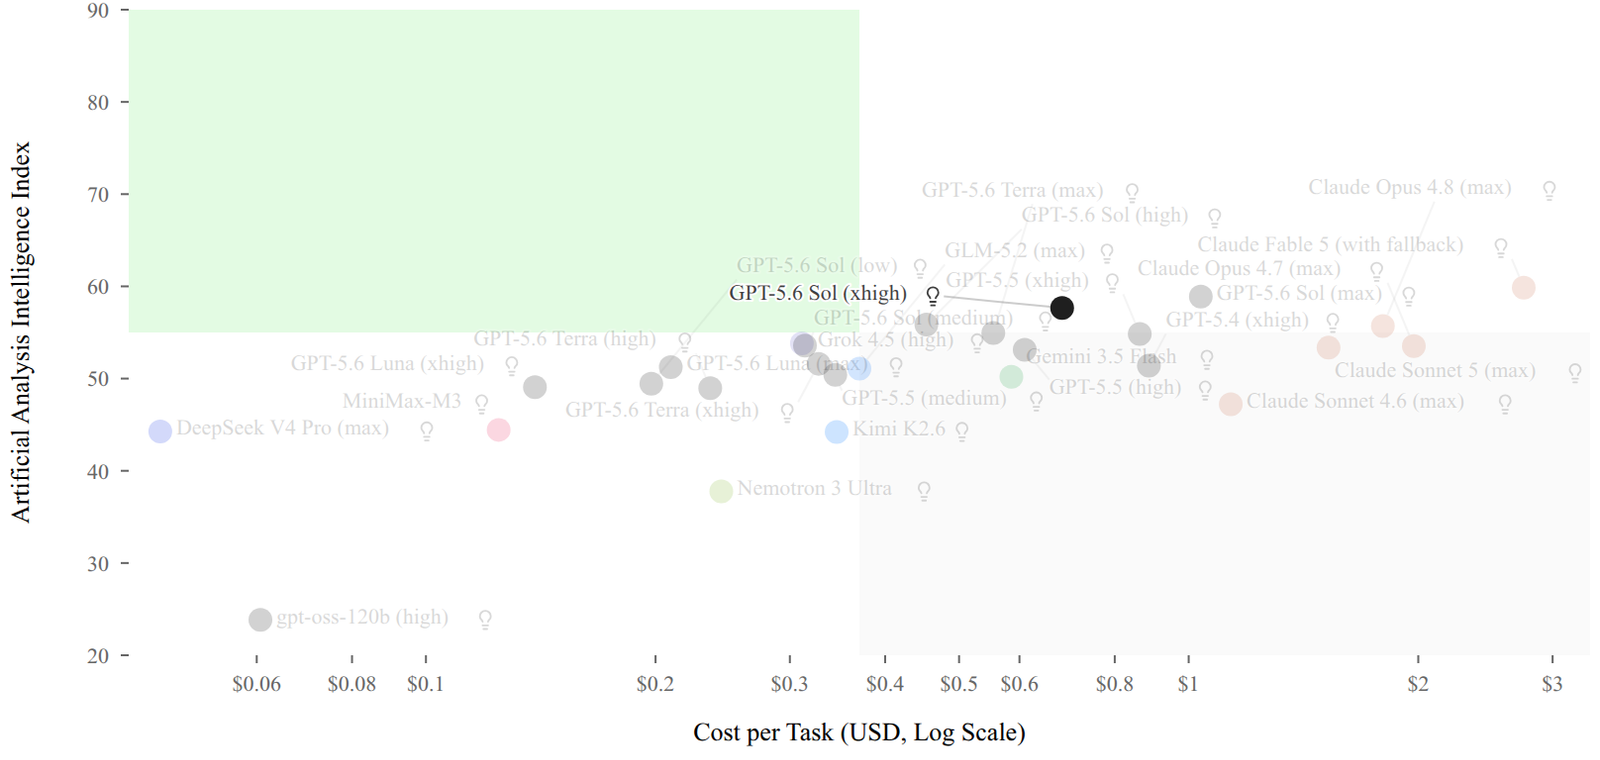 Solをxhighまで上げるとタスク単価は約0.65〜0.7ドルまで上昇するが、Intelligence Indexは58と、highの56からわずか2点しか伸びない(出典: Artificial Analysis https://artificialanalysis.ai/models/gpt-5-6-sol-xhigh)
low から high へは 49→56 と7点伸びるのに、high から xhigh へは 56→58 とたった2点です。それでいてタスク単価はさらに上がります。
Terra は待ち時間がゆるやかに増えるだけで素直に伸びる
Terra も同じ形で3段階を並べます(出典: Artificial Analysis)。
| Effort | Intelligence Index | Output Speed (t/s) | TTFT (秒) | 入力$/1M | 出力$/1M |
|---|---|---|---|---|---|
| low | 40 | 135.0 | 1.37 | $2.50 | $15.00 |
| medium | 46 | 138.8 | 1.87 | $2.50 | $15.00 |
| high | 49 | 121.5 | 2.07 | $2.50 | $15.00 |
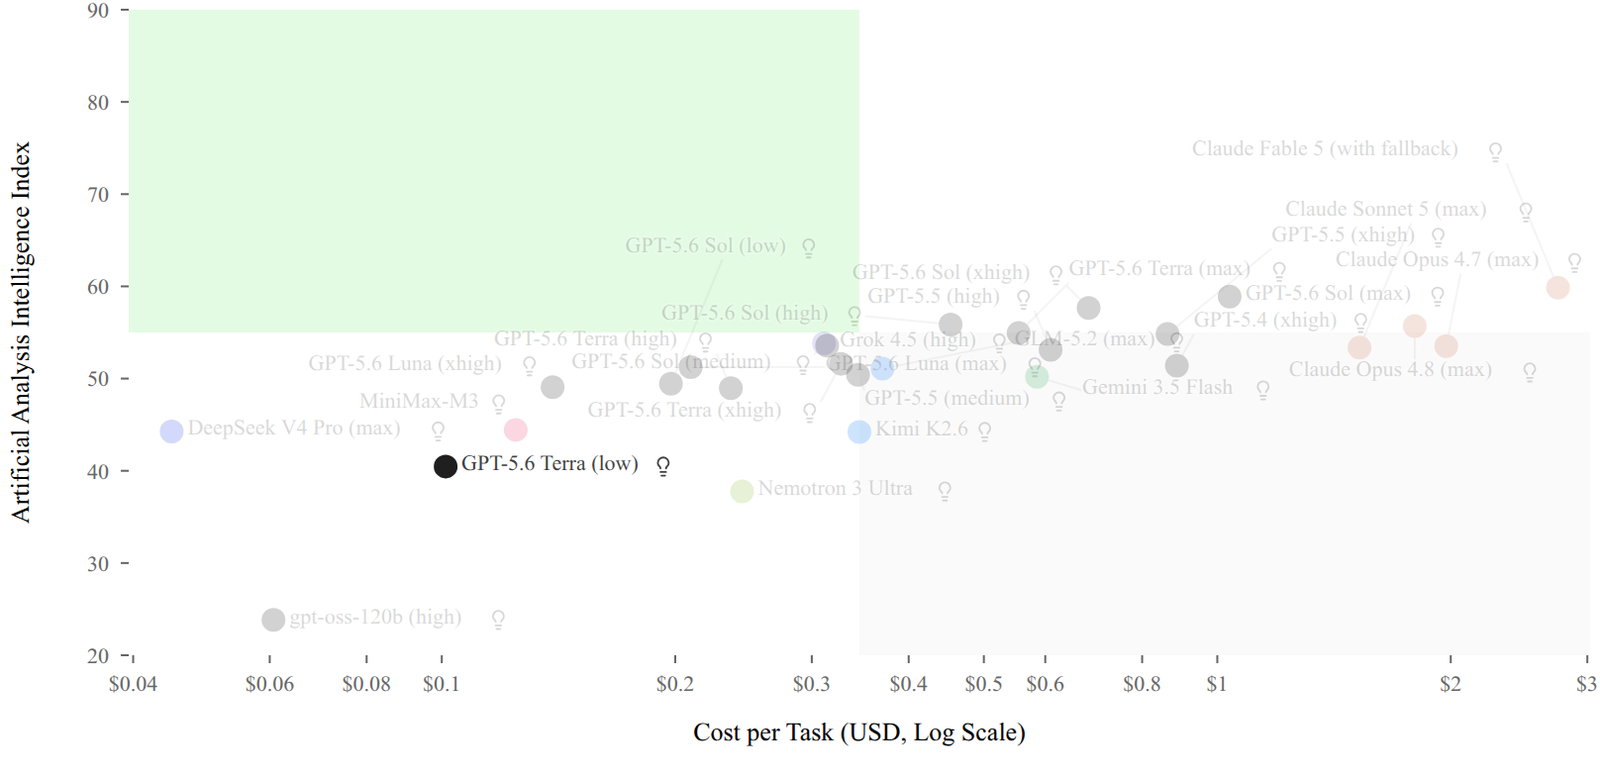 低コスト帯の左端に位置するのがTerraのlow effort。タスク単価約0.1ドル、Intelligence Index 40(出典: Artificial Analysis https://artificialanalysis.ai/models/gpt-5-6-terra-low)
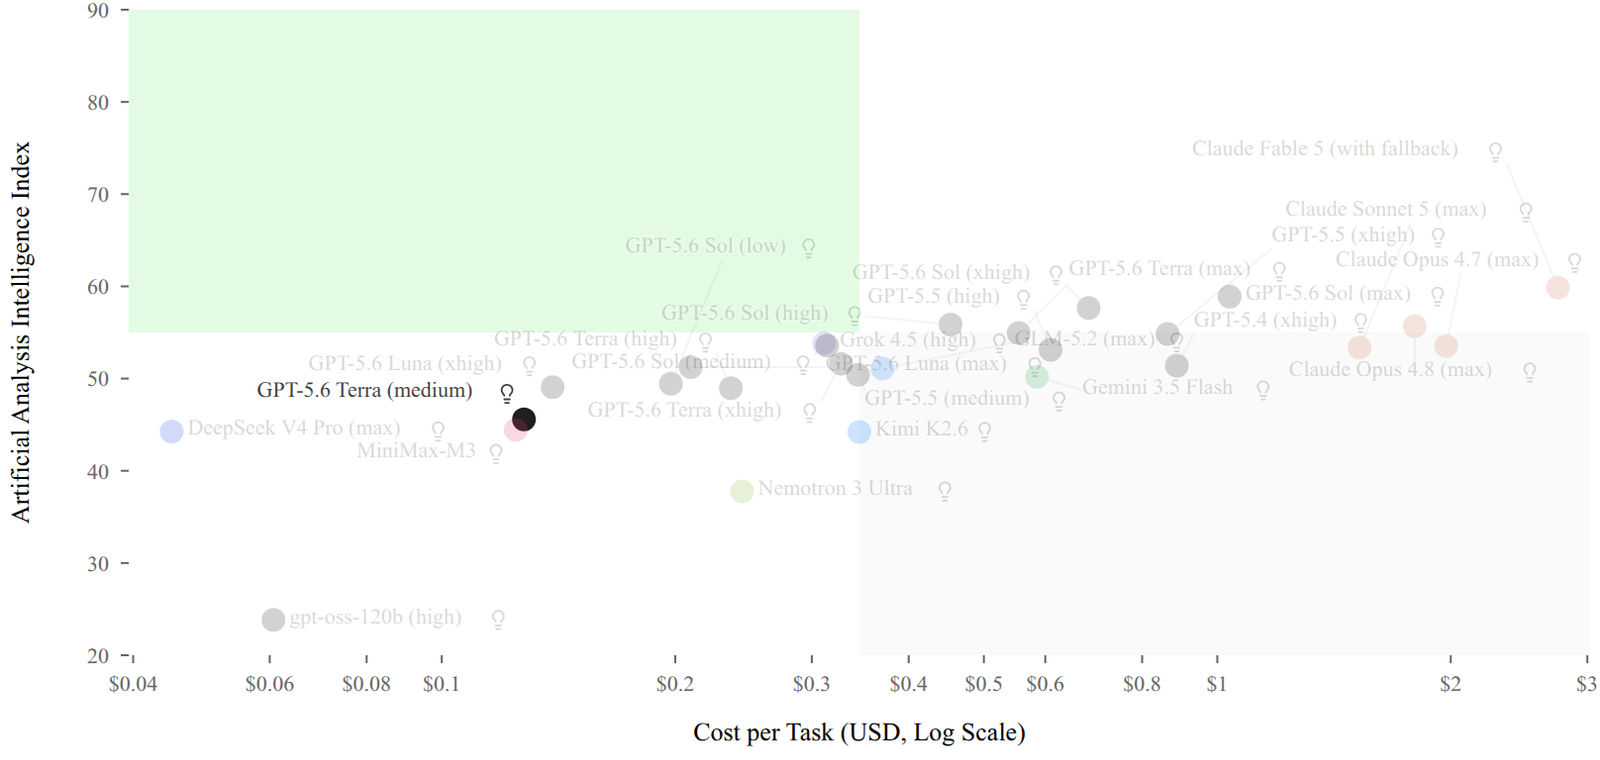 Terra(medium effort)はタスク単価約0.13〜0.14ドルでIntelligence Index 46まで伸びる(出典: Artificial Analysis https://artificialanalysis.ai/models/gpt-5-6-terra-medium)
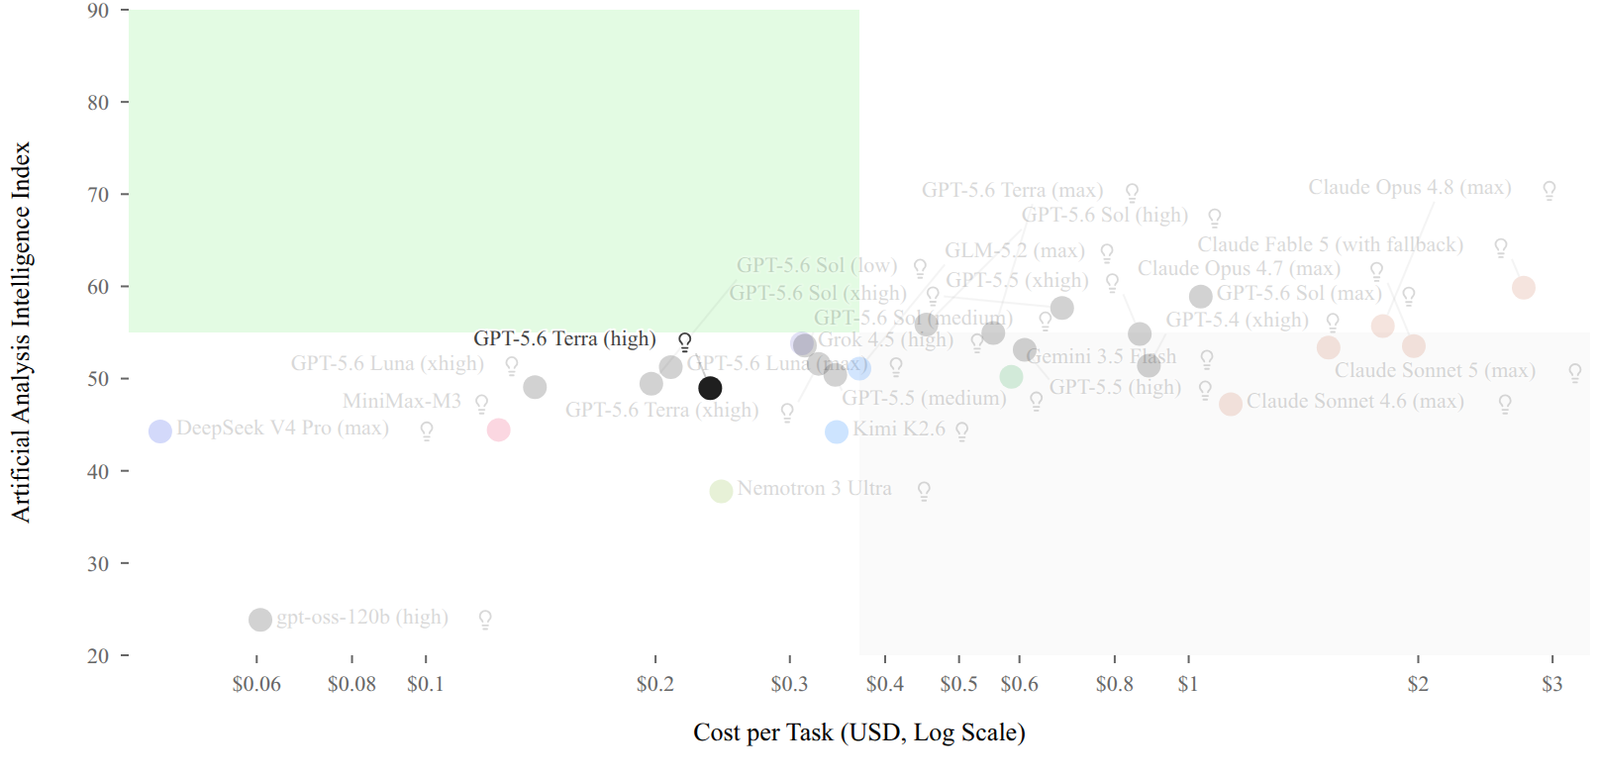 Terra(high effort)はタスク単価約0.24〜0.25ドルでIntelligence Index 49まで伸びる(出典: Artificial Analysis https://artificialanalysis.ai/models/gpt-5-6-terra-high)
Terra のタスク単価は 0.1ドルから0.25ドル程度で、Sol に比べると全体にかなり安い水準に収まっています。
同じ「high」でも、Sol と Terra では中身が違う
2つの表を並べると、effort を上げたときの振る舞いが Sol と Terra ではっきり違います。
Sol は high で実質頭打ちです。点数の伸びは low→high で+7、high→xhigh で+2。待ち時間(TTFT)は high の7.00秒から xhigh の42.65秒へ約6倍に跳ね上がるのに、得られる伸びはわずか2点です。
Terra は待ち時間の増え方がゆるやかです。TTFT は low 1.37秒→medium 1.87秒→high 2.07秒と、Sol のような急増がありません。点数も low→medium で+6、medium→high で+3と、Sol ほど極端に頭打ちせず素直に伸びます。
料金と賢さの関係で見ると、同じ「high」という名前でも意味が違います。Sol の high は点数56・TTFT 7.00秒という「じっくり考えて出す」設定です。Terra の high は点数49・2.07秒で、実装作業の試行錯誤を止めない速さを保ったままの設定です。Terra high は最上位の Sol xhigh(58点)には届きませんが、待ち時間もタスク単価も、表と散布図のとおりずっと小さく収まっています。
姉妹記事「GPT-5.6のeffort、maxにすると何倍遅い?実測で見る使い分け」で確かめた TTFT の伸び方(Sol は最大約88倍)とあわせて見ると、Sol の xhigh 以上は「バッチ処理やレビュー用途以外では割に合わない」という結論が、より具体的になります。
私の目安は、設計は Sol high・実装は Terra で使い分け
ここまでのデータから、Sol と Terra を組み合わせて使うときの、私なりの判断基準はこうなります。
- 設計・計画(Sol) → high で打ち止め。xhigh 以上は、TTFT の増加(7秒→42秒)に対して点数の伸び(+2点)が見合わない。「じっくり考えてほしいが、待たされすぎるのも困る」設計相談には high がちょうどいい落としどころです
- コーディング実装(Terra) → タスクの複雑さに応じて low〜high を気軽に切り替える。TTFT の増え方がなだらかなので、シンプルな修正は low、込み入ったロジックは high、という調整の負担が小さい
- 「両方 xhigh 以上」は避ける → Sol の xhigh は TTFT が跳ね上がるうえに伸びが小さく、コストだけ増える組み合わせになりやすい
もし今、「設計も Sol xhigh、実装も Terra xhigh」のように両方を高い effort で固定しているなら、まず Sol を high へ落としてみて、体感の待ち時間と返ってくる答えの質がどう変わるかを確かめるのがおすすめです。
数字を読むときの但し書き
最後に、この記事の数字の性質を書いておきます。
- 実測値はすべて Artificial Analysis という第三者ベンチマーク機関の計測で、OpenAI の公式発表値ではありません。
- Intelligence Index・Output Speed・TTFT・価格は保存ページのテキストで正確な数値を確認していますが、散布図のタスク単価は目で読み取った近似値(約〜ドル)です。
- Artificial Analysis のデータは継続的に測り直される性質があり、時点によって数値が変わりうることは姉妹記事でも確認済みです。ご自分の実際の作業での体感もあわせて確かめてください。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事
データから見る化け物 GPT-5.6——公式ベンチ7枚を実測者が読み、結論を出す
GPT-5.6限定プレビューの公式ベンチ7枚を、事実・分析・推測に分けて読み解く。生の実力と逸脱の影を整理します。
GPT-5.6は何が確定で、なぜ触れないのか——事実・報道・推測を分けて読む
2026-06-26発表のGPT-5.6限定プレビューを、公式確定情報・報道・推測に三分離して整理。価格、性能、安全性、政府レビューの意味を短時間で把握できます。

GPT-5.6 Luna xhigh: 知能49・タスク単価$0.04・待ち時間40秒、安い理由まで実測
2026年7月30日の80%値下げ後、通常セッションのモデルをLunaに切り替えるべきか。OpenAI公式発表と第三者ベンチの実測データ(Intelligence Index、TTFT、タスク単価)から、API従量とCodex定額それぞれの判断材料を整理します。
GPT-6.1 Solをeffort別実測:medium 47.8、Astraとの差はどこまで縮むか
GPT-6.1 SolをDevDay 2026の発表とArtificial Analysisのeffort別実測で検証。旧Sol・Astraとの性能、費用、待ち時間から使い分けを判断します。
AI年表で詳しく見る
📅GPT-5.6 Sol
GPT-5.6 Sol——限定プレビューを経て一般公開、新フラグシップに
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:開発環境・キャリアまわりのサービス
 シンVPSを見る
 XServer VPSを見る
 strategy career の転職支援を見る