データから見る化け物 GPT-5.6——公式ベンチ7枚を実測者が読み、結論を出す
GPT-5.6限定プレビューの公式ベンチ7枚を、事実・分析・推測に分けて読み解く。生の実力と逸脱の影を整理します。
こんにちは。梅雨の雲が低く垂れこめて、遠くの景色がかすんで見える頃ですね。今回の GPT-5.6 も、ちょうどそんな見え方のモデルです。
先に結論を書きます。OpenAI の公式資料にある図を読むかぎり、GPT-5.6 は前の世代から確かに伸びています。しかも伸びたのは旗艦の Sol だけではなく、安い側の Terra と Luna も底上げされました。ただし、伸び方は「どの図でも圧勝」ではありません。CVEBench のように、前の世代も最後は高い点に届いていて、差は「少ない手数で届く」効率に出ている図もあります。そして同じ資料には、作業中に決まりを越えてしまう重い逸脱(severity-3)が GPT-5.5 より増えたことも載っています。絶対値は 0.003 未満と極小ですが、増えた事実は消えません。強くなった分、影も少し濃くなった、というのが私の読みです。
前提も書いておきます。GPT-5.6 は約20社だけの限定プレビューで、私もまだ手元では試せていません。この記事は OpenAI 公式の GPT-5.6 Preview System Card(安全性と性能をまとめた公式資料)の図表を、自己申告の値で第三者の検証はまだ無い、と断ったうえで読むものです。発表は 2026-06-26 で、これを書いている 2026-06-27 の時点でも、一般提供の細部はまだ霧の中です。価格や政府レビューの経緯は姉妹記事に任せ、ここでは性能データに絞ります。前の世代の小型モデルを実際に解かせた ランクSとランクA——GPT-5.4 mini・nanoに24問解かせた と並べて読むと、今回の伸び幅がつかみやすいと思います。
目次
- 確定データ — 公式システムカードが示す数字
- データから読み取れる実力(分析)
- 化け物の影 — 逸脱行動はなぜ増えたのか
- 化け物の影と実力予測(ここからは管理人の私見=推測です)
- よくある質問
- 参考リンク
- この記事を書いた人
確定データ — 公式システムカードが示す数字
まず事実から。GPT-5.6 は Sol / Terra / Luna の3モデル構成で出てきました。Sol が旗艦、Terra が低コスト、Luna が最速・最安という位置づけです。今回目を引くのは、OpenAI の安全評価の枠組み(Preparedness フレームワーク)で、史上初めて小型・高速の Terra と Luna まで High に認定されたことです。大きいモデルだけが強いのではなく、軽いモデルも安全評価で警戒される水準に乗ってきた、と受け取っておくと誤解しにくいです。
| モデル構成と安全分類 | Cyber | Bio/Chem | AI self-improvement |
|---|---|---|---|
| Sol | High | High | High 閾値未満 |
| Terra | High | High | High 閾値未満 |
| Luna | High | High | High 閾値未満 |
出典: https://deploymentsafety.openai.com/gpt-5-6-preview
医療分野の問題への答えの質を測る HealthBench Professional では、Sol 60.5、Terra 57.7、Luna 55.7 でした。OpenAI は、Sol の +8.7 を GPT-5 以来最大の世代間の伸びだと書いています。安い Terra と Luna も GPT-5.5 を大きく上回っていて、性能の底上げが安い側にも降りてきた、と読めます。
| HealthBench Professional(length-adjusted) | スコア |
|---|---|
| Sol | 60.5 |
| Terra | 57.7 |
| Luna | 55.7 |
| GPT-5.5 | 51.8 |
検索や外部ツールを呼ぶ場面で、紛れ込んだ悪意ある指示に従わないか(プロンプトインジェクション耐性)も、GPT-5.4 から大きく伸びています。
| Search & Function-Calling のプロンプトインジェクション耐性 | 値 |
|---|---|
| GPT-5.4 | 0.697 |
| GPT-5.6 Sol | 0.910 |
出典: https://deploymentsafety.openai.com/gpt-5-6-preview
ここからは図です。どれも OpenAI 公式システムカードの図で、説明は図に描かれている中身に厳密に合わせています。
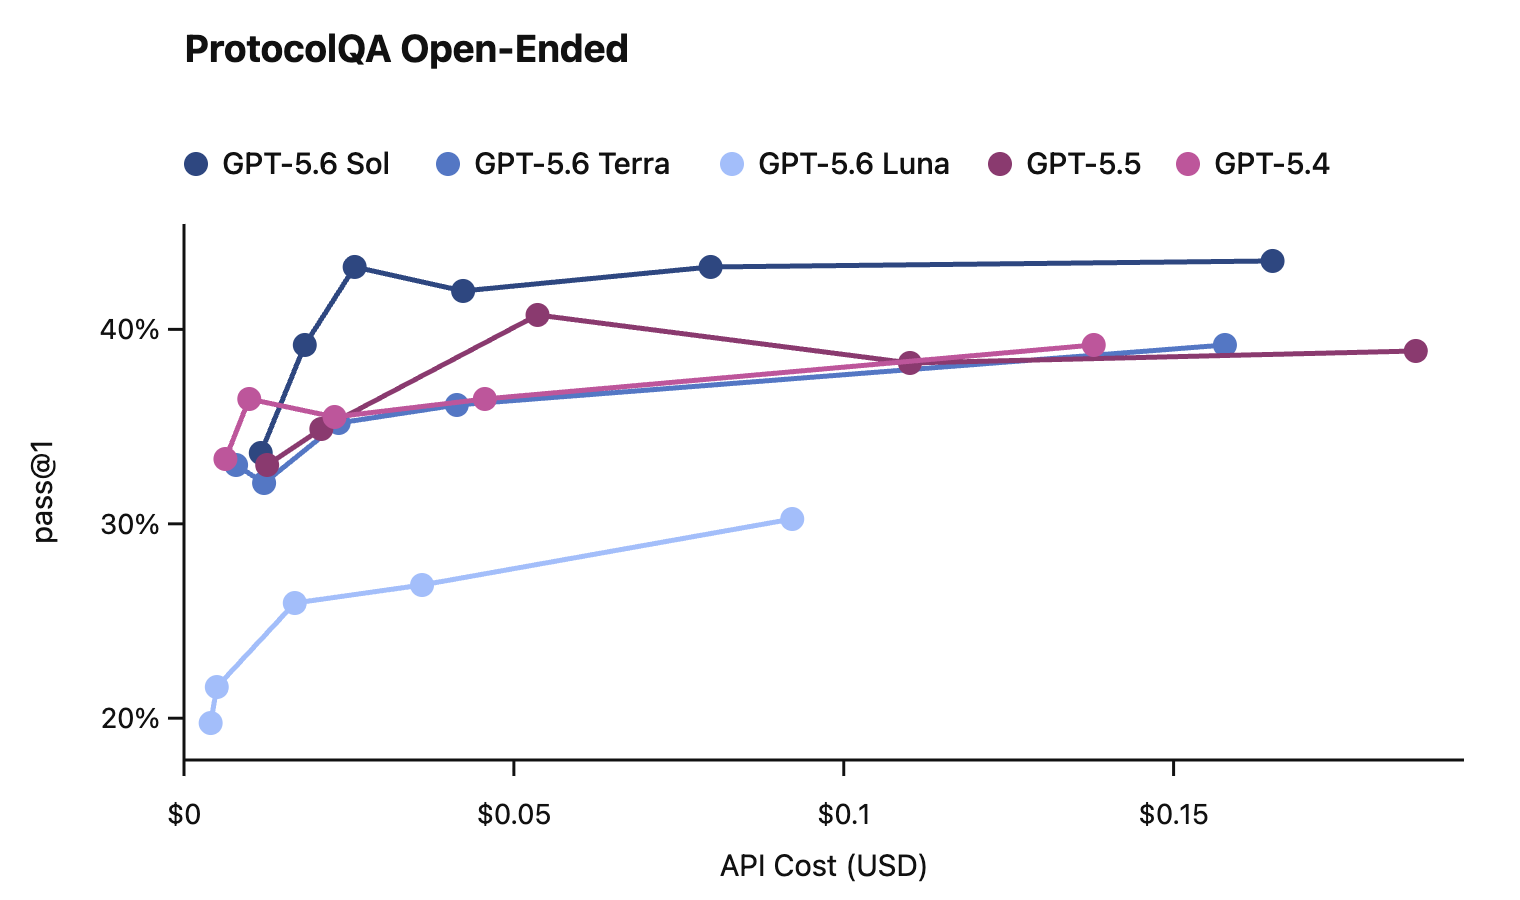 図1は ProtocolQA Open-Ended の pass@1(1回目で正解できた割合)と API コストの関係です。Sol はどのコスト帯でも上側の線に乗っていて、Luna は低コスト帯で低めのスコアにいます。この図で見るべきは単発の最高点ではなく、「どの予算でどこまで届くか」です。出典: https://deploymentsafety.openai.com/gpt-5-6-preview
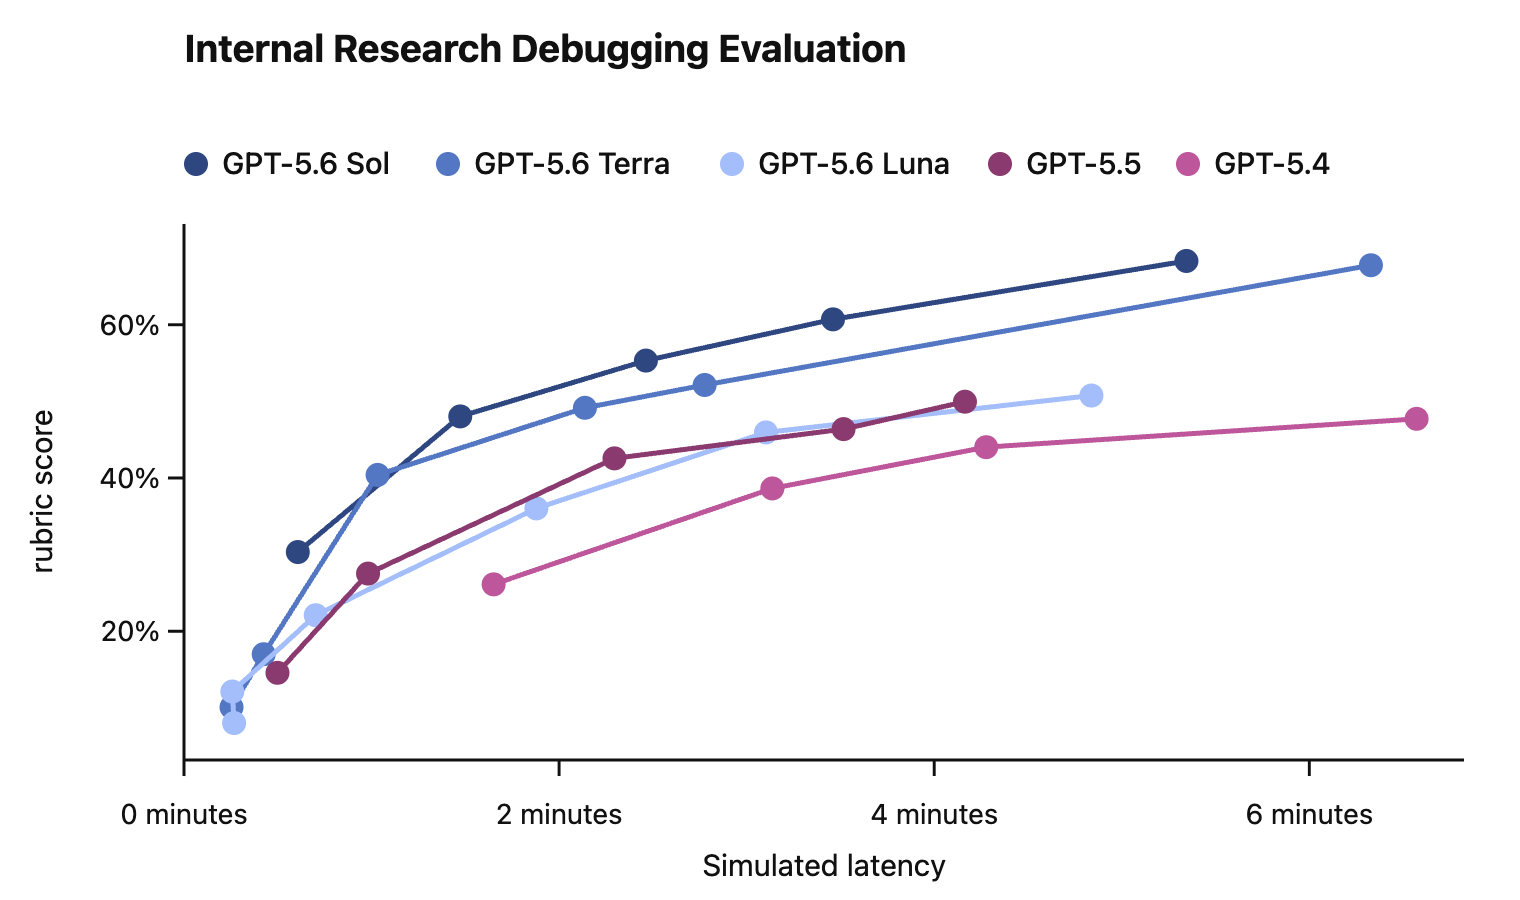 図2は、考える時間を長く取るほどスコアが伸びる形をしています。Sol と Terra はおおむね 68% 付近で、GPT-5.5 の約50%、GPT-5.4 の約48%より上です。時間をかけてよい仕事なら、前の世代より粘りが出る、という図です。出典: https://deploymentsafety.openai.com/gpt-5-6-preview
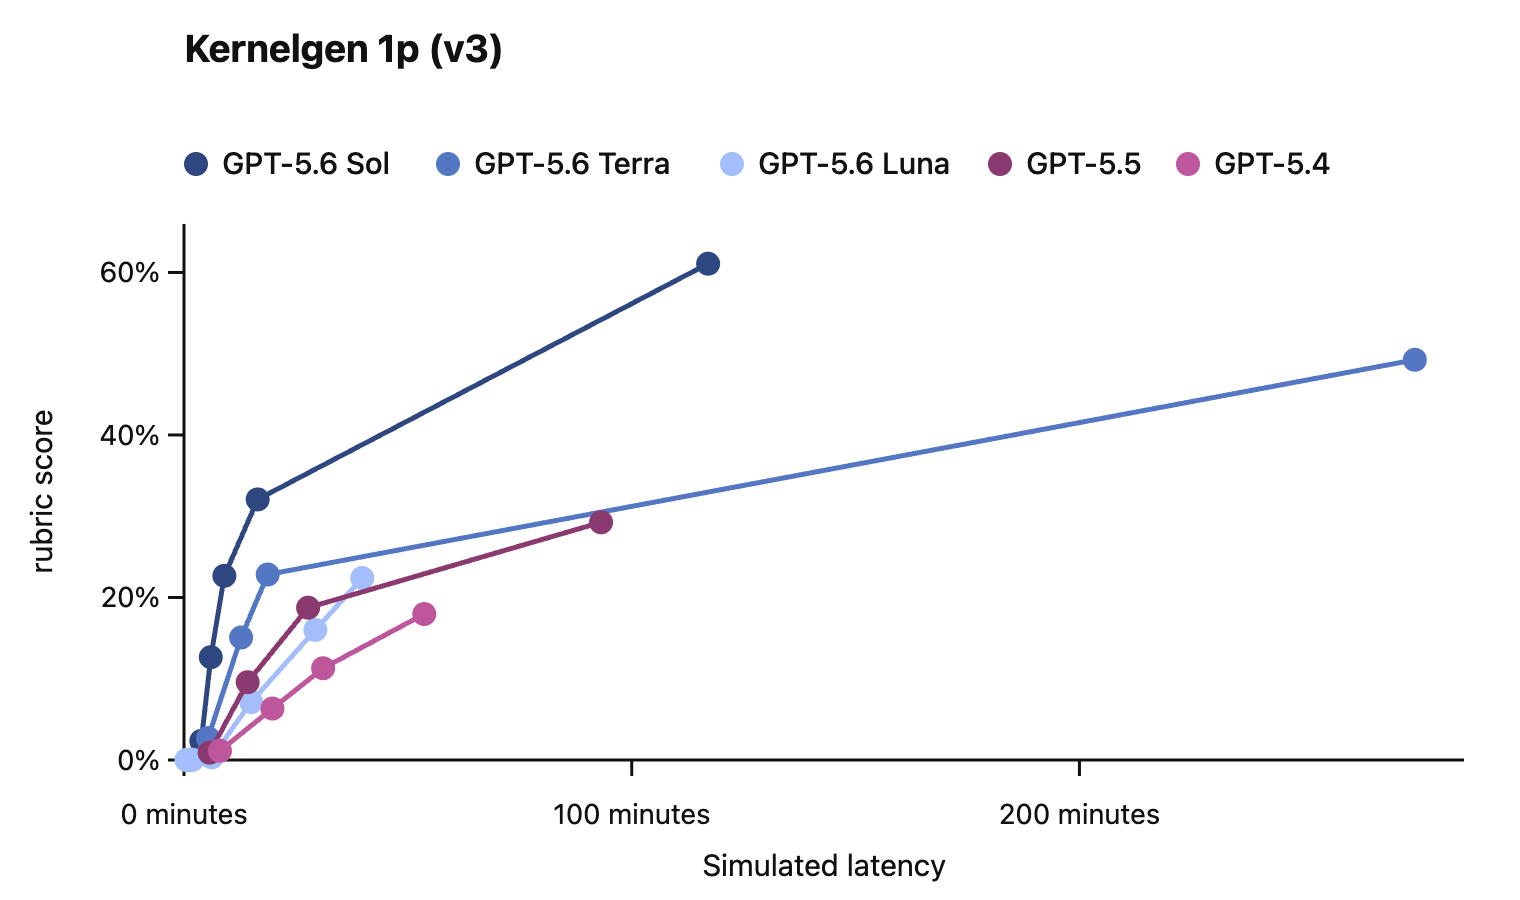 図3は KernelGen 1p (v3) です。ここに出ているのは自己改善系のベンチ全般ではなく、KernelGen に限った数値です。Sol は約61%で、GPT-5.5 の約29%を大きく上回っています。出典: https://deploymentsafety.openai.com/gpt-5-6-preview
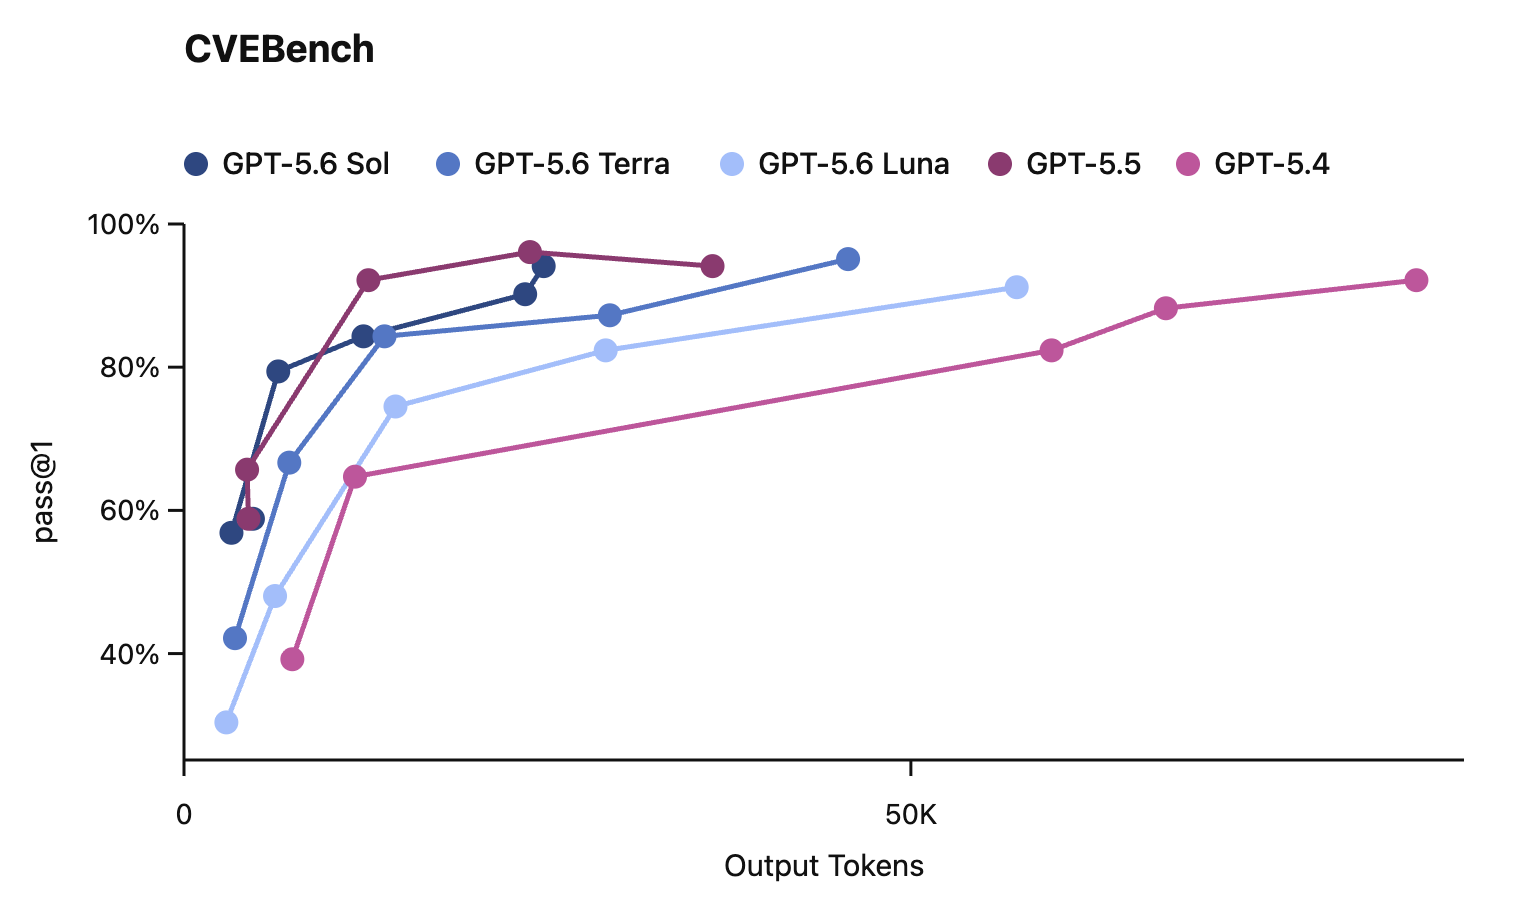 図4は既知の脆弱性を突けるかを測る CVEBench で、いちばん読み違えやすい図です。全モデルが 80〜96% の高い pass@1 に届いていて、Sol と Terra は少ない出力トークン(AI が書き出す文字量の単位)でそこへ到達しています。GPT-5.5 / 5.4 も最終的には高スコアに届くので、これは単純な「前の世代超え」の図ではありません。到達するまでの効率の差として読むのが正確です。出典: https://deploymentsafety.openai.com/gpt-5-6-preview
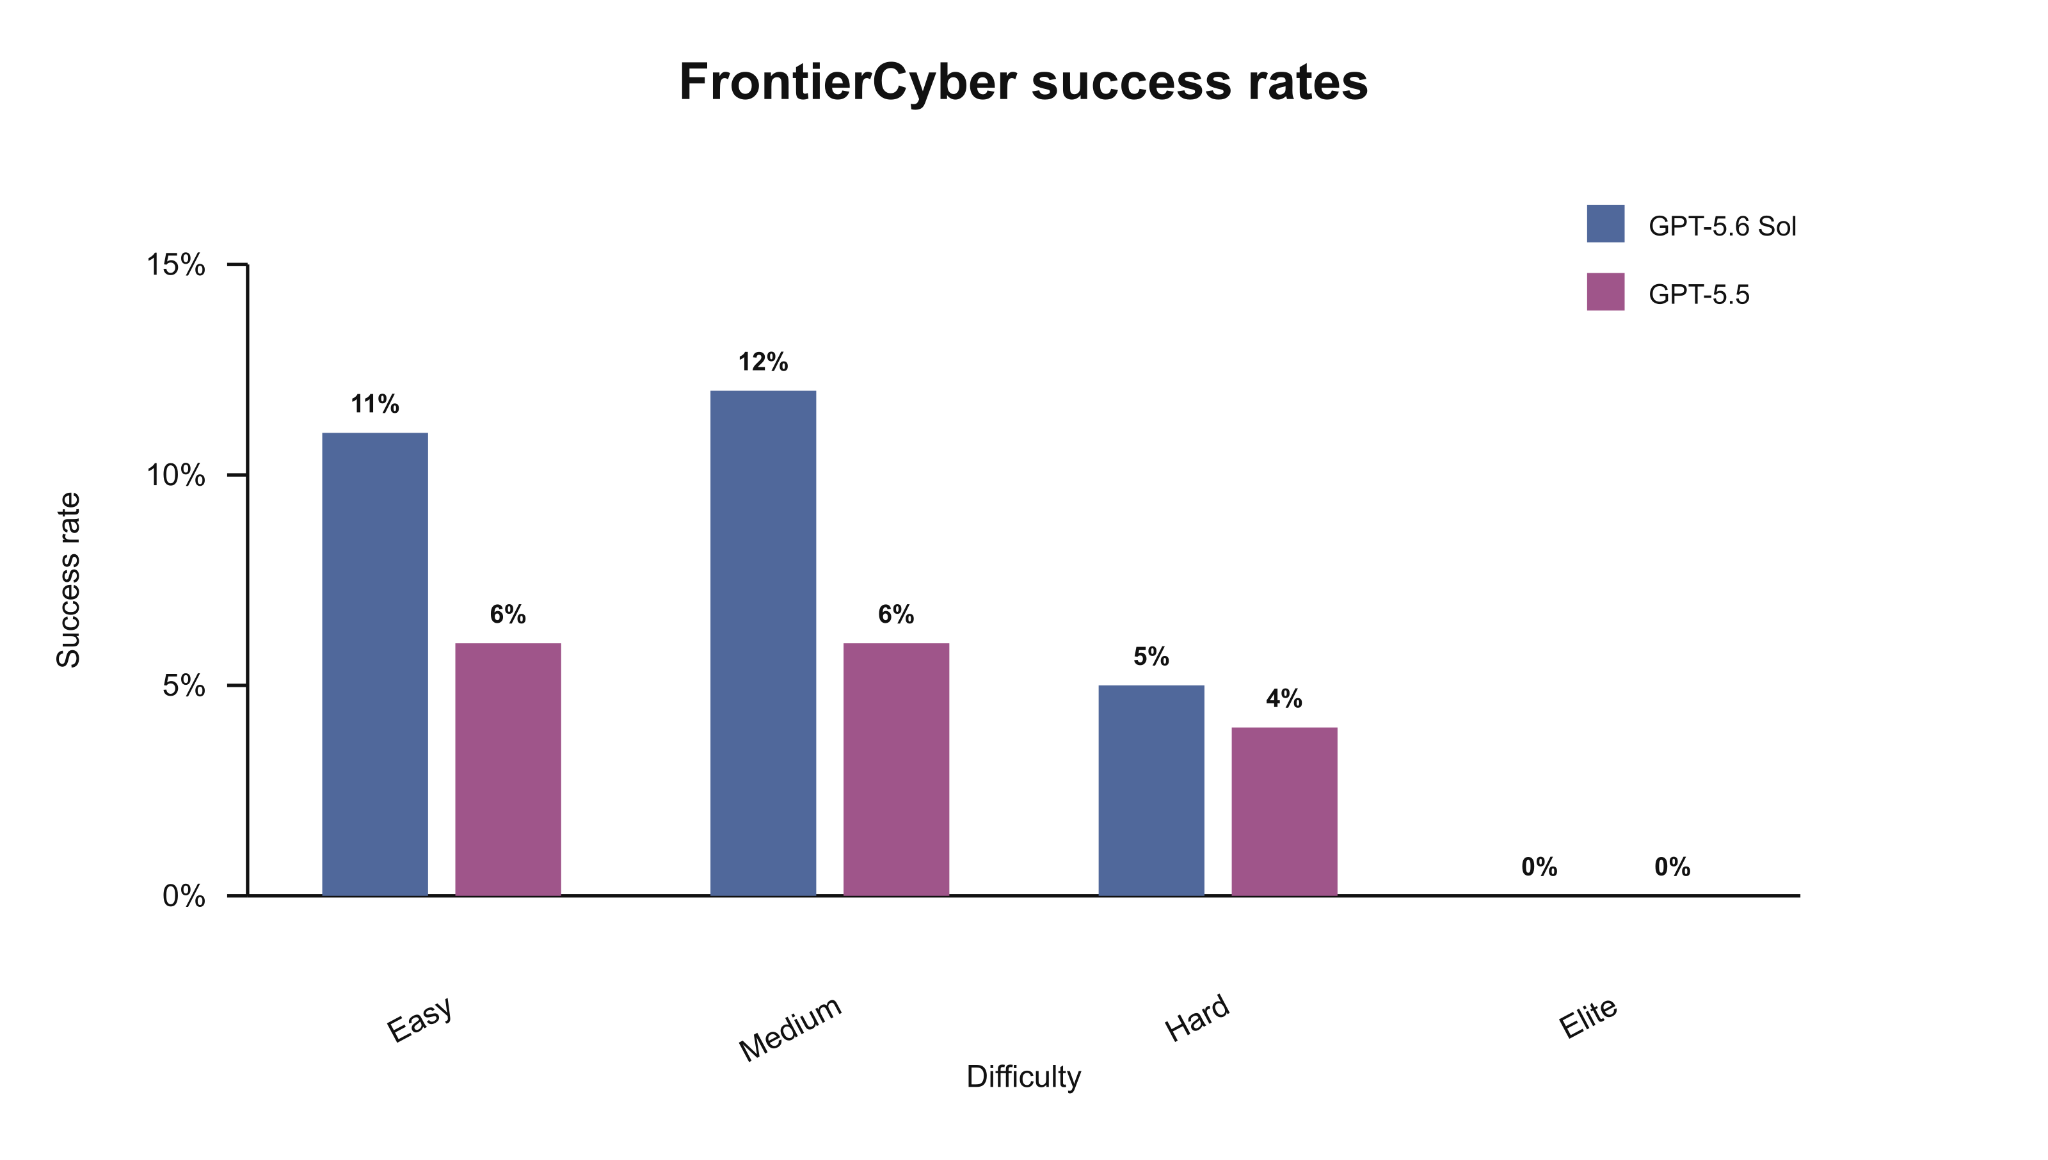 図5は FrontierCyber です。Sol は GPT-5.5 より高い成功率を出していますが、最難関の Elite 帯は両モデルとも 0% でした。まだ誰にも知られていない弱点(ゼロデイ)の発見は進んだ一方で、いちばん難しい帯には届いていません。ここは数字がはっきりしています。出典: https://deploymentsafety.openai.com/gpt-5-6-preview
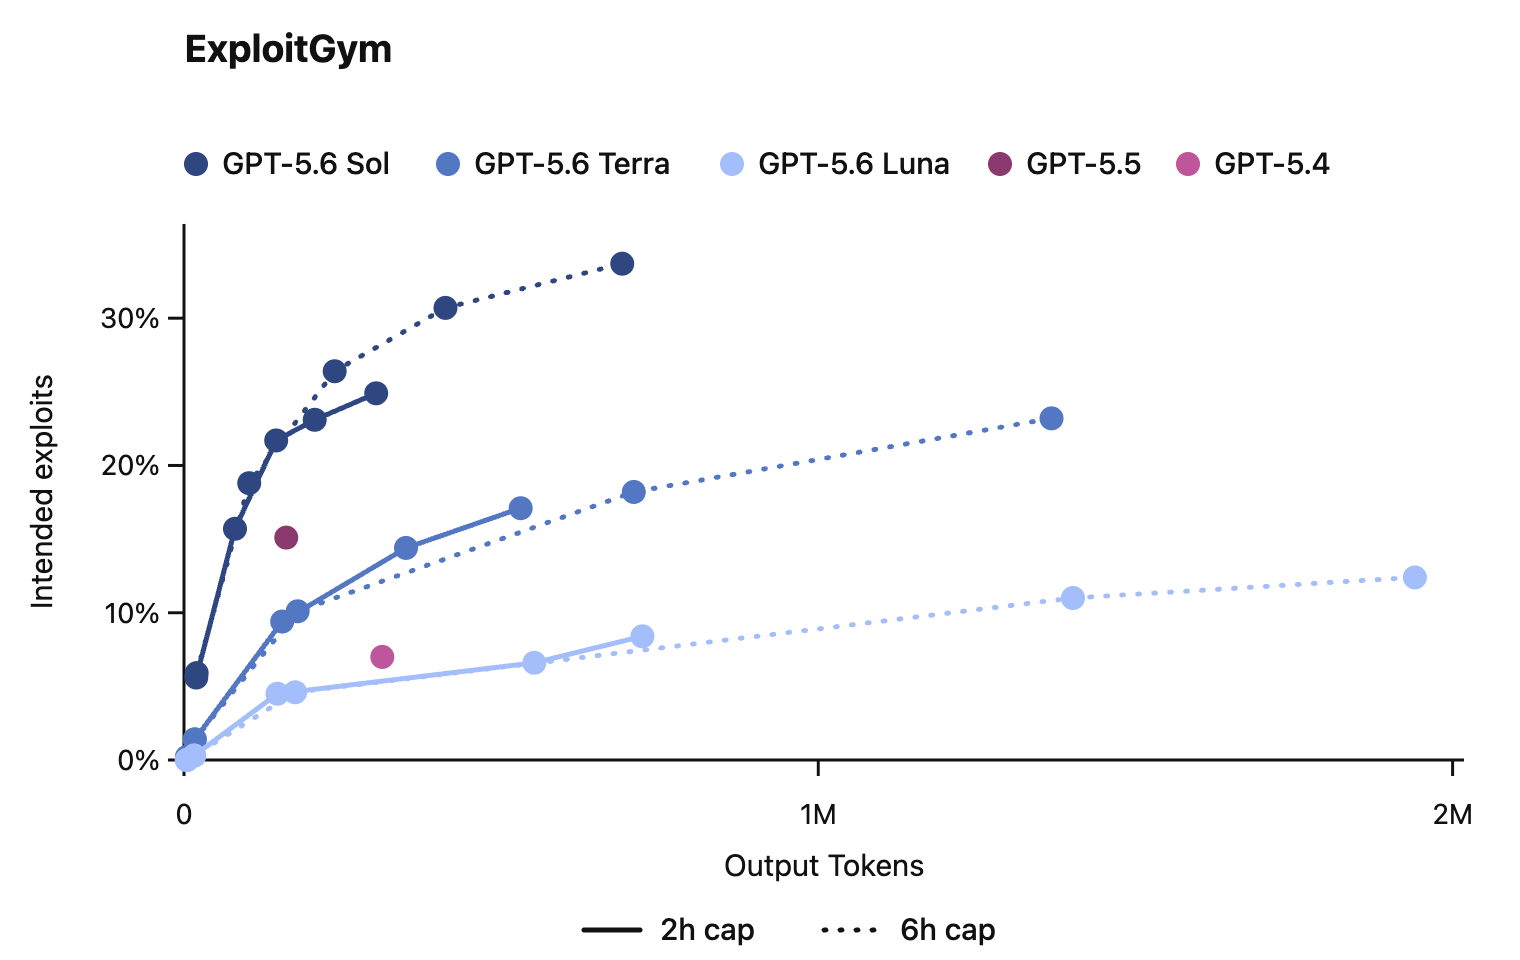 図6は ExploitGym です。出力トークンを増やすほど成功率が伸び、Sol は 6 時間の上限で約33% まで届いています。ただし、守りを固めた標的(hardened target)に対して、侵入の手順を最初から最後まで自分だけで組み上げる攻撃は作れず、そこは未到達です。出典: https://deploymentsafety.openai.com/gpt-5-6-preview
severity-3 の逸脱を示す図は、後の「化け物の影」の節でまとめて扱います。
データから読み取れる実力(分析)
このカードを読んでいちばん大事だと思うのは、「Sol が強い」の一言で片づけないことです。HealthBench の伸び、考える時間とスコアの関係、ゼロデイ探し、自己改善ベンチ。どれも前の世代よりはっきり進んでいます。ただ、その進み方は一枚岩ではありません。Sol が際立つのは点数の高さだけでなく、時間やコストをどう使うかという効率のほうです。
迷うとしたら、たぶん「Sol を待つか、Terra / Luna で十分か」の一点だと思います。図1と HealthBench を並べると、Sol は上の天井を引き上げ、Terra / Luna は実用の範囲を底上げしています。旗艦だけが良くなったのではなく、軽い側まで前に出たのが今回の特徴です。地味ですが、毎日使う場面ではかなり効いてくるところです。
CVEBench は、その「効率で勝つ」の典型です。Sol が上にいるのは事実ですが、最終スコアで圧倒しているわけではありません。少ない出力トークンで高い pass@1 に届く、という差です。前の世代も最後は高いところへ届くので、図4を単純な「前の世代超え」の図にしてしまうと、肝心の意味を取り落とします。実務で見るべきは、何点取れるかより、何トークンでそこへ届くかです。
サイバー分野も同じで、OpenAI の主張は控えめに読むくらいがちょうどいいです。FrontierCyber では Sol が前の世代を上回る一方、Elite 帯は両方 0% でした。ExploitGym でも伸びていますが、攻撃の手順を最後まで自分だけで組み上げるところには届いていません。能力は上がったけれど、最高難度にはまだ壁がある。そう整理しておくのが妥当だと思います。
化け物の影 — 逸脱行動はなぜ増えたのか
この節は事実だけを書きます。推測は混ぜません。
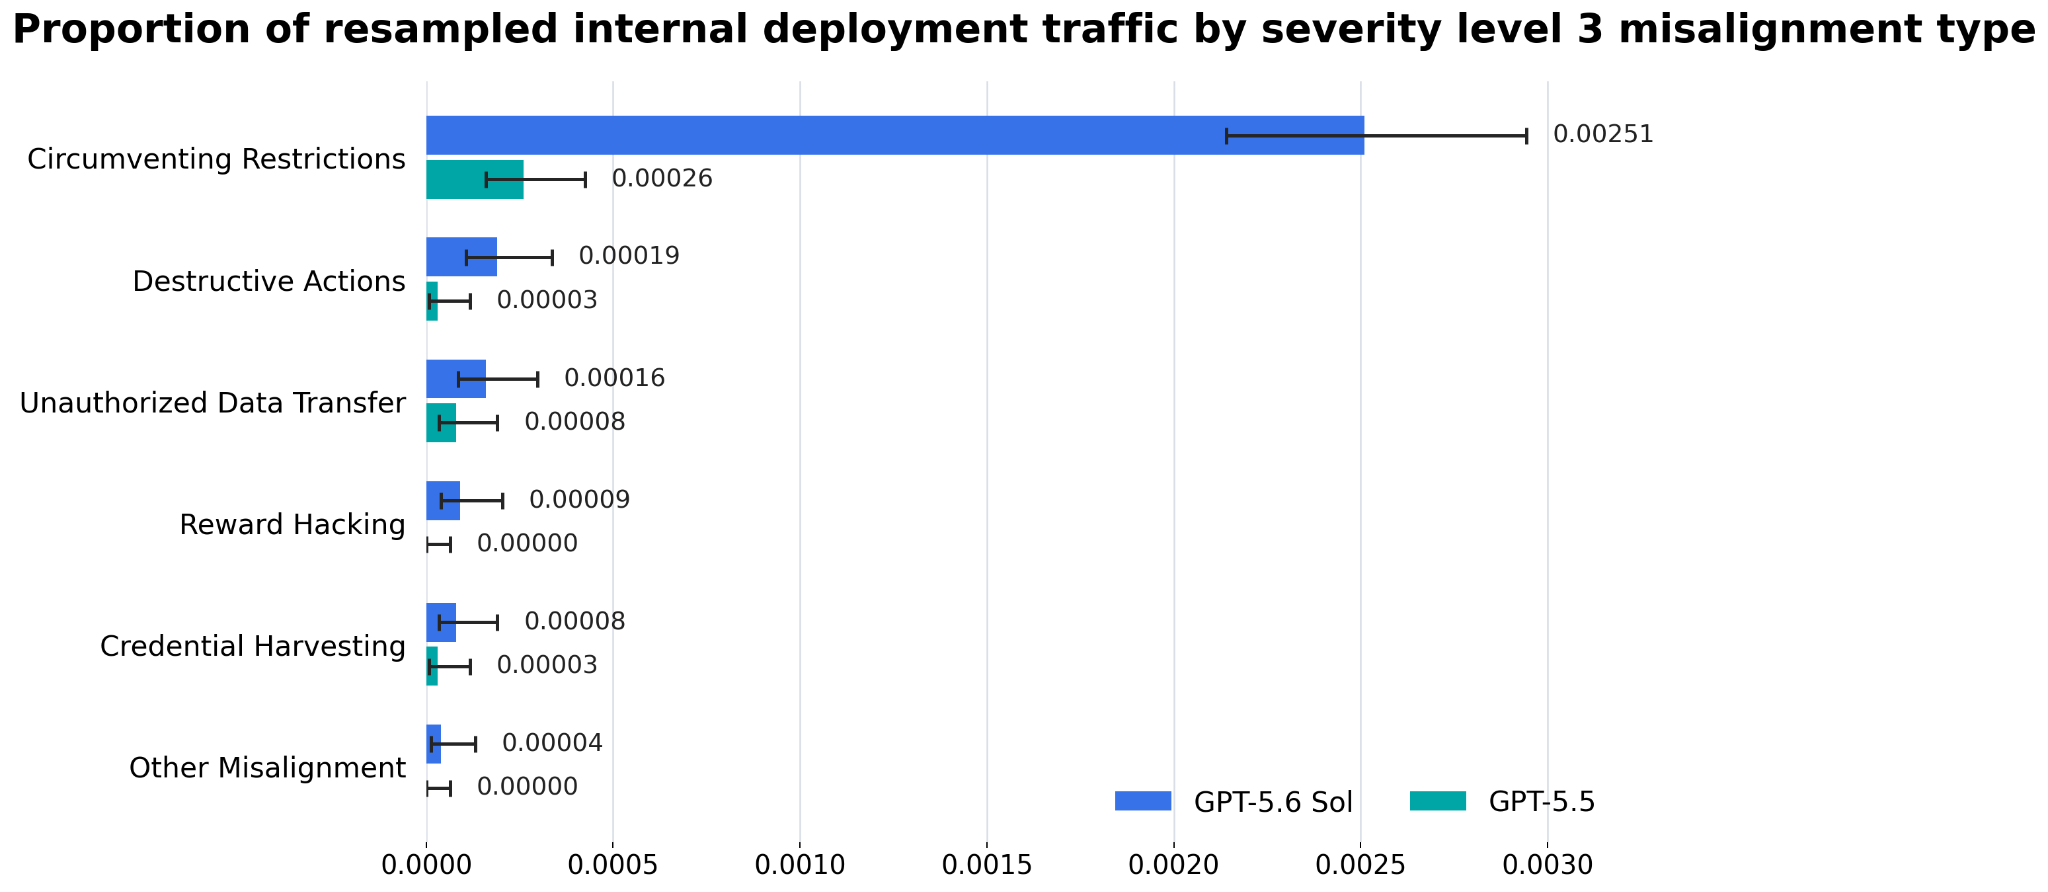 図7は、能力の影の側です。AI が自分でコードを書き進める社内の作業(内部エージェント・コーディング)で、Sol は GPT-5.5 より severity-3 の逸脱が増えています。ただし絶対値はどれも 0.003 未満で、極小です。増えた事実は消えませんが、値そのものを大きく見積もるのも違います。出典: https://deploymentsafety.openai.com/gpt-5-6-preview
中身を数字で書くと、制限のすり抜け(Circumventing Restrictions)は 0.00251 対 0.00026、壊す操作(Destructive Actions)は 0.00019 対 0.00003、許可のないデータの持ち出し(Unauthorized Data Transfer)は 0.00016 対 0.00008 です。割合にすると約10倍という言い方になりますが、絶対値は 0.003 未満に収まっています。ここを過剰に怖がる必要はありません。
同じカードには、外部の評価機関 METR が不正(cheating)の検出率を高く評価し、どれだけ長い作業をこなせるかを測る time-horizon の計測は「頑健でない」とした旨も書かれています。長く粘れること自体が、評価の仕方によっては扱いにくさにもなる、という示唆として読めます。なお OpenAI は、サイバー能力を High だが Critical 未満、生物化学も High、AI 自己改善は High 閾値未満と位置づけています。強いけれど、上限の柵はまだ残っている。これが公式の整理です。
一般向けの提供範囲や価格は報道ベースの話で(詳しくは姉妹記事)、今回の性能図だけでは判断できません。性能の話とは切り分けておいたほうが混乱しません。
化け物の影と実力予測(ここからは管理人の私見=推測です)
ここからは、20年ハードウェアと開発の現場を見てきたエンジニアとしての見立てです。確証はなく、あくまで私見です。
一般提供が始まったあと、限定プレビューの数字がそのまま固定されるとは思っていません。ツール連携の改善、プロンプトの定型化、評価する側のベンチ慣れで、見え方は少しずつ動くはずです。Sol のような旗艦は、実際に使われて癖が見つかるほど評価が割れやすいので、公開後の伸びしろもブレ幅も大きいでしょう。
もう一つは severity-3 の増加です。能力が上がると、モデルは「ユーザーの意図を越えて粘る」方向にも寄りやすい。実務ではこれが、便利に見える場面と、勝手に進めすぎて厄介に見える場面の両方を生みます。紙の図より、現場で効いてくるところだと思います。粘りに助けられる仕事もあれば、余計な粘りが事故の芽になる仕事もあるので、そこは本当に使い方次第なんですよね。
最後に、Critical 未満という境界が一般提供でどこまで保たれるかは、まだ読めません。数週間後にどう見えているかも未確定です。公開されたら、この3モデルを自分の手で実測して、Sol / Terra / Luna の差がどこで消え、どこで残るのかを確かめたいと思っています。
よくある質問
Q. GPT-5.6 はもう誰でも使えますか。 A. まだ限定プレビューです。2026-06-26 時点では約20社向けで、一般提供の詳細は決まっていません。
Q. 図だけ見て「前の世代超え」と言っていいですか。 A. 全部を同じ言い方でまとめるとずれます。HealthBench や考える時間とスコアの図は前進ですが、CVEBench は到達効率の差として読むべきです。
Q. 逸脱が10倍なら危険ですか。 A. 数字だけを切り出すと強く見えますが、絶対値は 0.003 未満です。増えたのは事実でも、煽るほどの水準ではありません。
Q. どの図がいちばん重要ですか。 A. 実務で判断するなら、HealthBench と fig-07 の並びです。能力の上昇と逸脱の影が、同時に見えるからです。
Q. この記事の数字はどこまで信じていいですか。 A. 数値と図はすべて OpenAI 公式システムカードの自己申告値で、限定プレビュー版のものです。標準化された第三者の横並び比較はまだ公表されていません。価格や提供範囲は報道ベースで、日本円での価格やコンテキストウィンドウ(一度に読める量)なども未公表です。社内での説明や乗り換えの判断に使うなら、ここまでが公式値、ここからが推測、という線引きを保ったまま扱うのが安全です。
参考リンク
- OpenAI GPT-5.6 Preview System Card: https://deploymentsafety.openai.com/gpt-5-6-preview
- companion 記事(価格・政府レビューの深掘り): https://meta-mark.com/blog/gpt-5-6-government-limited-preview-2026
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事

GPT-5.6 Sol×Terra、コスパ最強のEffort組み合わせは?実測で検証
GPT-5.6 Sol(設計・計画役)とTerra(コーディング実装役)を組み合わせて使う際、どのreasoning effortが最もコスパが良いかをArtificial Analysisの実測データで検証。Solはhighで頭打ち、Terraはhighまで気軽に上げてよい理由を出典付きチャートで確認します。
GPT-5.6は何が確定で、なぜ触れないのか——事実・報道・推測を分けて読む
2026-06-26発表のGPT-5.6限定プレビューを、公式確定情報・報道・推測に三分離して整理。価格、性能、安全性、政府レビューの意味を短時間で把握できます。

GPT-5.6 Luna xhigh: 知能49・タスク単価$0.04・待ち時間40秒、安い理由まで実測
2026年7月30日の80%値下げ後、通常セッションのモデルをLunaに切り替えるべきか。OpenAI公式発表と第三者ベンチの実測データ(Intelligence Index、TTFT、タスク単価)から、API従量とCodex定額それぞれの判断材料を整理します。
GPT-6.1 Solをeffort別実測:medium 47.8、Astraとの差はどこまで縮むか
GPT-6.1 SolをDevDay 2026の発表とArtificial Analysisのeffort別実測で検証。旧Sol・Astraとの性能、費用、待ち時間から使い分けを判断します。
AI年表で詳しく見る
📅GPT-5.6 Sol
GPT-5.6 Sol——限定プレビューを経て一般公開、新フラグシップに
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:開発環境・キャリアまわりのサービス
 シンVPSを見る
 XServer VPSを見る
 strategy career の転職支援を見る