Tavilyのinclude_answer、なぜ切るか——37件中7件の実測
TavilyやBrave Search等のWeb検索APIをLLMパイプラインに組み込む前に知っておきたい、ハルシネーション対策の設計。自プロジェクトの6層防御実装と、37件中7件が実際に弾かれた実測データを元に、6社の価格・用途比較まで整理します。
こんにちは。七夕が過ぎて、梅雨明けの知らせを待つ頃になりましたね。天気予報と同じで、調べものの結果も「どこまで信じていいか」が気になる、という話です。
先に結論を書きます。Web検索APIはハルシネーション(AIがもっともらしい嘘をつくこと)対策の材料にすぎません。対策そのものは、検索結果をどう扱うか、呼び出し側の設計で作り込むものです。 検索結果を渡しただけでは、LLMLLM(大規模言語モデル)大量の文章で学習し、人のように文章を読み書きできる大きな AI のモデル。詳しく →は平気でそこに書かれていない数字を作ります。うちのプロジェクトでも、37件の新製品候補のうち7件で、LLMが申告した仕様値が機械的に弾かれました。
この仕組みが合うのは、LLMエージェントやRAG(検索結果をAIに読ませて答えさせる仕組み)で、検索結果を「材料」に留めて最後の事実確認を自分でやりたい人です。検索APIの回答をそのまま使えば足りて、厳密な照合や人間の承認まで要らない人には過剰です。ここからは、私が実運用しているTavilyの設定と、それを支える多層の防御、実測で何件がどう弾かれたかを順に見ていき、後半でBrave Search・Exa・Serper・Linkup・Perplexity Sonarを含めた6社を価格と用途で比べます。検証日は2026-07-08です。価格・無料枠は変わりますので、導入するときは必ず各社の公式ページで最新値をご確認ください。比較表の価格は、同日に確認した公式ドキュメント・公式価格ページによります。
include_answerを切るのは、要約そのものが嘘の出どころになりうるから
Tavilyの検索APIには include_answer という設定があります。true にすると、検索結果をもとにTavily側がLLMで要約した回答を返してくれます。検索から回答づくりまで一度で済むので、RAGを組むときはつい有効にしたくなります。
私はここを false で固定しています。検索結果の要約自体がLLMの生成物で、それ自体が新しいハルシネーションの出どころになりうると考えているからです。検索結果という一次の事実の集まりから、まずTavily側のLLMが要約を作り、その要約を今度はこちらのLLMが最終の回答に変えます。工程が1つ増えるたびに、どこかで事実が少しずつ歪む余地が生まれます。
なので、生の検索結果(タイトル・URL・本文)だけを受け取り、そこから先の事実確認は自分のパイプライン(処理の流れ)で機械的にやる設計にしています。回答づくりの主導権を外に渡さない、と言い換えてもいいかもしれません。実際のリクエストはこんな形です。
curl -s https://api.tavily.com/search \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $TAVILY_API_KEY" \
  -d '{
    "query": "製品名 発売日 スペック",
    "max_results": 5,
    "search_depth": "advanced",
    "include_answer": false,
    "include_domains": ["nvidia.com", "amd.com"]
  }'
include_domains にメーカー公式のドメインを渡しておくと、Tavily側で検索範囲そのものを絞ってくれます。地味ですが、後ろの照合の精度を底上げしてくれる設定です。
対照的なのがPerplexity Sonarです。こちらは「検索結果」ではなく「検索済みの回答」を返す設計そのものが売りで、レスポンスに引用元のURLと日付付きの抜粋を添えることでハルシネーション対策を担保しています。同じ「LLMが要約する」工程でも、引用の出どころを必ず添える設計にすれば、それはそれで1つの防御になります。どちらが正解というより、要約という工程をどこに置き、誰が検証するかという設計判断の違いです。
検索結果を見せても、LLMはそこに無い数字を書く
⚠️ ここが今回いちばん言いたいところです。Web検索APIを繋いだだけでは、ハルシネーションはむしろ別の形で残ります。「知らないことを答えてしまう」嘘から、「検索結果を見ているはずなのに、そこに無い数字を報告する」嘘に変わるだけです。この2つは別の能力で、モデル選びの段階でも正答率と非ハルシネーション率は独立した軸として現れます。
うちのプロジェクトでは、新製品候補の型番・容量・クロック周波数・NAND方式のようなスペック値を、Tavilyの検索経由でLLMに抜き出させています。プロンプト(AIへの指示文)では「各スペックごとに {url, quote} を必ず返すこと」と明示し、検索結果の本文に存在しない値は採用しない前提で運用しています。ここを曖昧にすると、後で触れるL3の照合が効かなくなります。
LLMの出力を素直に信じてDBに書き込んでいた時期は、それらしい数字が混ざっているのを後から見つけて青ざめる、ということが何度かありました。検索結果を見せているから安心、ではありません。見せていても、LLMは自信満々にそれっぽい値を埋めてきます。ここに気づかないと、Web検索APIを入れたこと自体が「もっともらしい誤情報の生成器」を作っただけになりかねません。
Web検索APIを入れた人が最初に引っかかるのも、たぶんここです。「検索結果を見せているのだから、もう嘘は書かないはずだ」という期待そのものが外れているのです。
検索から人間の承認まで、6層で少しずつ絞り込む
この問題に対して、うちのプロジェクトでは検索から人間の承認までを6層に分けて守っています。今日リリースしたばかりの仕組みなので、まだ実測のサンプルは多くありませんが、設計の考え方として共有します。
| 層 | やっていること |
|---|---|
| L1 取得 | メーカー公式ドメインをTavilyの include_domains に渡して優先させる。ヒット0件で一般検索に落ちたら、スペック値を一切埋めない「存在発見のみモード」に縮退する |
| L2 抽出 | LLMにスペック値・発売日ごとに {url, quote}(根拠URLと引用文)の提示を必須で要求する |
| L3 照合 | quoteが検索結果の本文に実際に存在するか、正規化した上で機械的に部分一致させる。一致しなければその値はnullに降格する |
| L4 レンジ検証 | 物理的にありえない数値やカテゴリ外の値をnullに降格する(例: SSDの容量が16GB〜32TBの範囲外なら弾く) |
| L5 厳格モード | 数値スペックを2回独立して抽出させ、一致した値だけを採用する |
| L6 人間承認 | 実際にDBへ書き込むのは、人間が承認した候補だけ。レビュー画面には照合済みかどうかのステータスも表示する |
肝は、L3・L4で弾いた値を削除せずnull(空欄)に降格し、理由をメモとして残すところです。LLMの「自信」は一切信用しません。ただ、正規化した部分一致という保守的な判定なので、本当は正しい値が誤って落ちる(偽陰性)こともあります。だからこそ消さずに残し、最後は人間が拾い直せる形にしています。機械が全部判定して終わり、にはしていません。
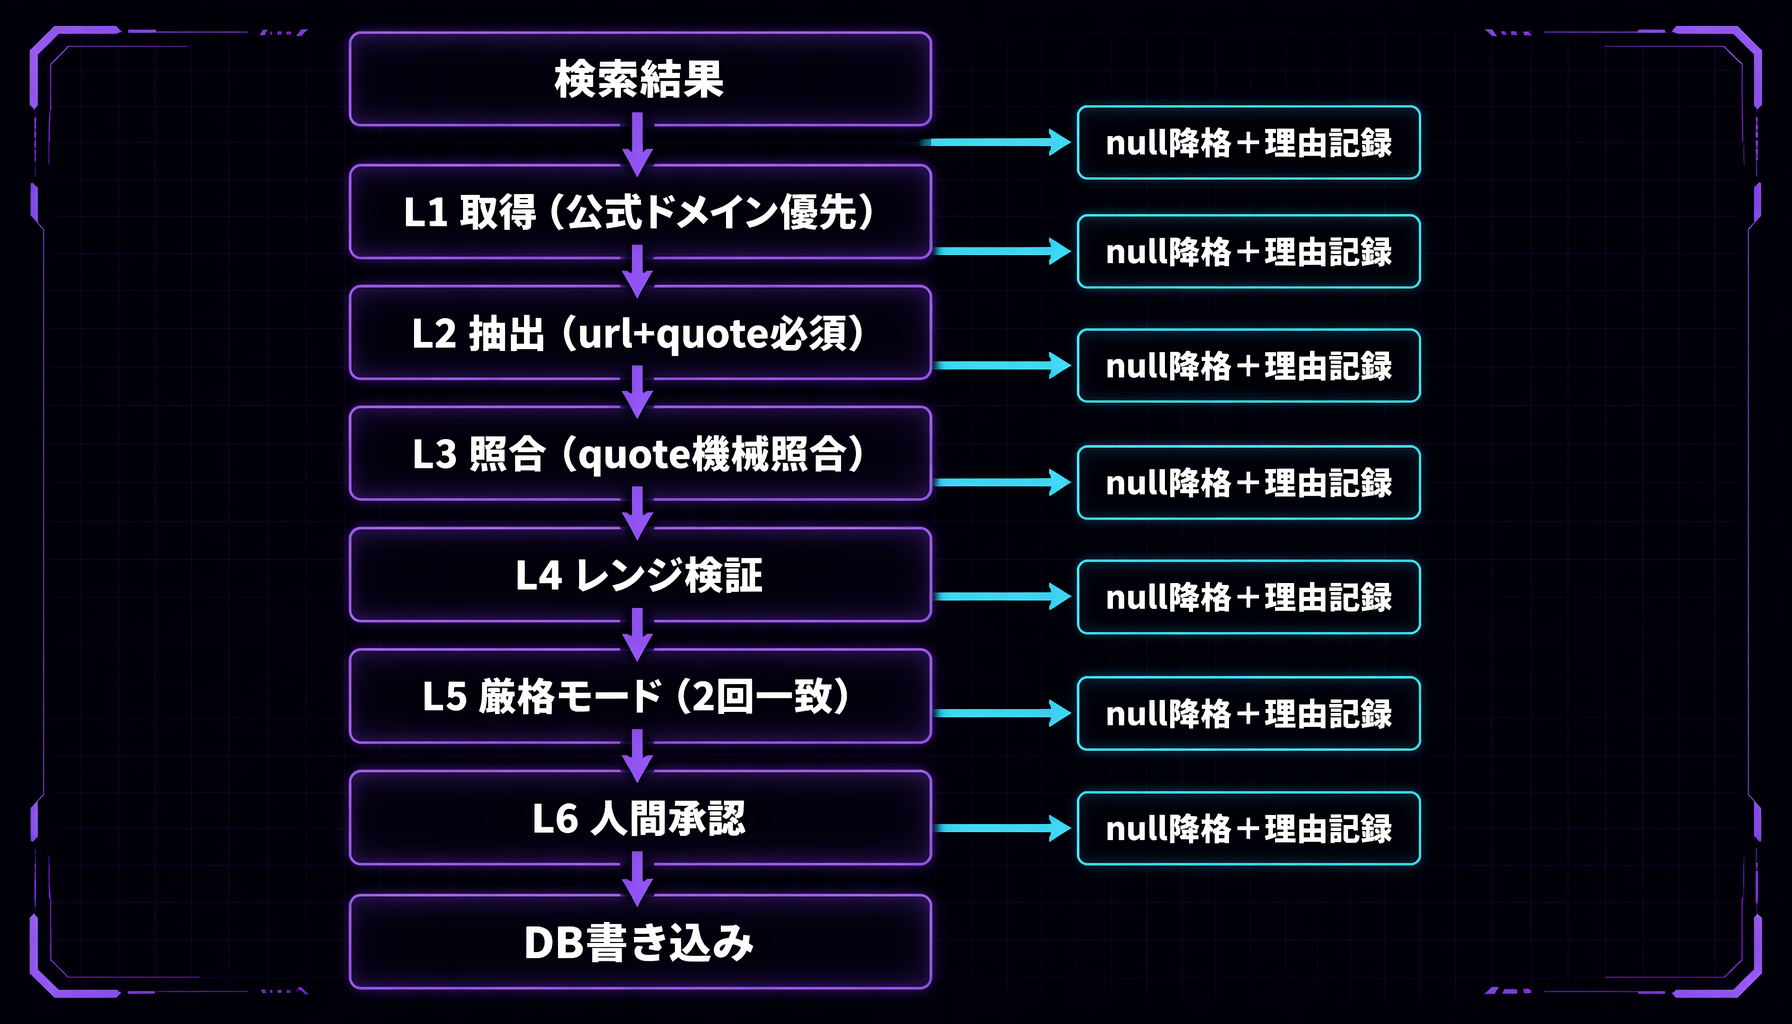 検索結果からDB書き込みまで、6層で少しずつ絞り込む
37件中7件で弾かれた値、たとえば「それっぽい2TB」
このL3の機械照合は2026-07-08にリリースしたばかりの機能です。稼働後にscanを2回実行しました。対象は新製品候補37件、カテゴリは主にSSD・GPU・CPUクラスのスペック確認、プロンプトの条件は「検索結果本文にない値は採用しない」「各値に {url, quote} を添える」です。 そのうち7件(約19%)で、少なくとも1つの申告値が機械照合で弾かれました(降格したスペック欄の延べ数は11件)。
実際に弾かれた例をひとつ挙げます。「AGI AI858 2 TB」という候補製品で、LLMは容量を2TBと申告してきました。ところが、根拠として示されたTavilyの検索結果の本文にはその数値が見つからず、機械照合で capacity_gb がnullに降格されました。同じ候補のブランド名・シリーズ名も同じ理由で落ちています。別のSSD製品でも、NAND方式やブランド名がquoteの照合を通らず降格したケースがありました。
ログを見返したとき、正直「2TB」という数字自体はそれっぽくて、パッと見では気づけなかったと思います。型番も実在しそうな並びでしたし、人間の目視レビューなら素通りしていた可能性が高いです。こういう値は、もっともらしい型番と数字の組み合わせで、人間が1件ずつ裏を取らなければ気づけない形で紛れ込みます。それを機械的な照合というだけの地味な仕組みが捕まえているのを見ると、やはり人間の勘だけに頼るのは危ういと感じます。
L4のレンジ検証は0件でも、まだ外さない
L4のレンジ検証による降格は、この2回では0件でした。L3の時点でおおむね捕まえられている可能性はありますが、まだ2回分のサンプルです。L4が要らないと結論づけるのは早いと思っています。安価な最後の備えとして残しておく判断自体は妥当なところです。
6社の比較:価格と用途で選ぶ(Tavily以外は仕様表)
ここからは6社の価格・仕様の比較です。実際に運用しているのはTavilyだけなので、Tavily以外は公式ドキュメントに基づく比較として読んでください。「使ってみたらこうだった」という体験談ではなく、あくまで仕様表としての整理です。価格は2026-07-08時点での確認ベースです。
| サービス | 無料枠 | 価格の目安 | 特徴 | 参照元 |
|---|---|---|---|---|
| Tavily | 月1,000クレジット | Basic=1クレジット/リクエスト、Advanced=2クレジット/リクエスト、従量$0.008/クレジット | 検索・抽出・クロールまで揃うAIエージェント向けAPI。include_answerでLLM要約回答も選べる | Tavily Pricing, Tavily Docs |
| Brave Search | 月$5無料クレジット | Search $5/1,000requests(50req/s) | 独自Webインデックス。Answersプラン($4/1,000+トークン代)も別途あり | Brave Search API |
| Exa | 月20,000requests | Search $7/1,000、Contents $1/1,000pages、Deep Search $12〜15/1,000 | 検索結果をそのままLLMに渡す用途向け。10件超取得は+$1/1,000requests | Exa Pricing, Exa Search API Docs |
| Serper | 2,500queries | $1.00/1,000requestsから購入量に応じ最安$0.30/1,000まで | Google検索のSERPをそのまま取得(画像・ニュース・ショッピング等も対応) | Serper |
| Linkup | 4,000queries | Search $0.005〜0.006/request、Fetch $0.001〜0.005/request | SOC 2 Type II・ZDR(Zero Data Retention)を全プラン無償提供 | Linkup Pricing, Linkup Docs |
| Perplexity Sonar | — | $5〜12/1,000requests(search_context_sizeで変動)+ $1/1Mトークン | 検索結果ではなく引用付きの回答そのものを返す設計 | Perplexity Sonar Docs |
用途で分けると、私の感覚はこうです。
- LLMエージェントに検索の文脈を渡したい → Tavilyが素直に動く
- Google検索の結果ページ(SERP)そのものが欲しい、SEO調査や順位の追跡をしたい → Serper
- 安く大量にWeb検索したいだけ → Brave
- コードやドキュメントの調査で、LLM向けの質の高い検索結果が欲しい → Exa
- SOC2やZDR(データを保存しない約束)といった企業のセキュリティ要件がある → Linkup
- 検索から回答づくりまで丸ごと任せたい → Perplexity Sonar
ただし、これは「Tavily以外を使えば楽になる」という話ではありません。どのAPIを選んでも、返ってきた検索結果をそのままLLMに渡せば、前半で書いたハルシネーションのリスクは変わらず残ります。守りをどう作るかは、選んだAPIとは別の段の宿題です。
選ぶ前に「誰が、どう検証するか」を決める
Web検索APIを選ぶ基準は、価格や無料枠だけでなく「検索結果をどう検証するか」まで含めて考えるべきだと思っています。Tavilyのinclude_answerを切っているのも、Perplexity Sonarが引用付きの回答を返す設計にしているのも、根っこにあるのは同じ問いです。LLMが生成した値を、誰が・どうやって検証するのか。AIの出力をAI自身に見張らせる層の作り方は、Claude Code の公式セキュリティプラグインを実機検証した記事でも扱っています。
もし今、Web検索APIを繋いだだけで満足しているなら、一度、LLMの出力に「根拠URLと引用文」を必須で出させてみることをおすすめします。それだけで、検索結果に実在しない値がどれくらい混ざっているかが機械的に見えてくるはずです。うちの場合は37件中7件でした。ここでいう7件は「候補7件に少なくとも1つの降格があった」という意味で、降格した欄の延べ数は11件です。数字は環境やプロンプト次第で変わりますが、ゼロにはならないというのが実感です。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
META-MARK
GPU・CPU・PCパーツをMetaScoreで比較できます。
1,000件超のパーツデータベース。性能・効率・コスパの3軸スコアで、カタログスペックに振り回されない選択を。