Fable 5 は正解集のバグを見つけて、りんご問題で転んだ——24問実測レポート
Claude Fable 5 を24問で実測。224点でHaiku 4.5(221点)を僅差で上回るが、中身は別物でした。正解集のバグ発見とA4誤答まで公開します。
こんにちは。雨続きで外の予定が流れた日は、新しいモデルをじっくり試すのにうってつけですね。
Claude Fable 5 は、私の24問テストで 224/240(Rank S)でした。Haiku 4.5 の 221/240 をわずか3点上回る単独トップですが、この差は採点のブレで埋まる範囲です。ただ、中身はかなり違いました。Haiku が崩れた最難問 B6 を完答し、2ヶ月近く誰も気づかなかった正解集(採点に使う模範解答の一覧)のバグまで見つけた一方で、A4 のりんご問題では Haiku とまったく同じ誤答をしています。
迷うとしたら、たぶん「Opus 4.8 から乗り換える価値があるのか」と「公式ベンチの数字だけで決めていいのか」の2つだと思います。料金は Opus の2倍で、6/22 までの無料期間に触るかどうかも悩ましいところです。私の答えは、総点だけでは質の差は見えない、そして最上位モデルでも直感に引っ張られる誤答は消えない、の2点です。今回いちばん大きい発見は後者でした。
Fable 5 は Opus 4.8 の上に置かれた新しい最上位で、料金はちょうど2倍
2026-06-09 に Claude Fable 5 と Claude Mythos 5 が同時に発表されました。Fable 5 は Opus 4.8 の上に置かれる、新しい最上位の段です。公式の説明では、Fable と Mythos の違いはモデルそのものではなくセーフガード(危ない依頼を止める安全装置)のほうにあります。セーフガードに当たったリクエストは Opus 4.8 に切り替えて答え、95%超のセッションではこの切り替えは起きないとされています。
2026-06-10 時点の提供条件は次のとおりです。
- API 料金: 入力 $10 / 出力 $50 per MTok(Opus 4.8 のちょうど2倍)
- Batch は半額、キャッシュ読みは90%引き
- 1M コンテキストが標準、最大出力 128K
- 6/9〜6/22 は Pro / Max / Team / Enterprise に追加費用なしで含まれる
- 6/23 以降は usage credits が必要
発表時点で見ると、かなり攻めた値付けです。だからこそ、実務で本当に差が出るのかを自分の問題で確かめたかったわけです。
総点は 224 対 221。並んで見えるが、崩れ方はまるで違う
テストは、24問をカテゴリ別に採点する自前のベンチマークです。結果を並べるとこうなります。
| モデル | A | B | C | D | 合計 |
|---|---|---|---|---|---|
| Fable 5 | 47 | 60 | 60 | 57 | 224 |
| Haiku 4.5 | 52 | 55 | 57 | 57 | 221 |
| gemma4:12b | - | - | - | - | 173 |
| Bonsai-8B | - | - | - | - | 98 |
合計だけ見ると、ほぼ並んでいます。でもカテゴリ別に見ると、Fable 5 は B と C を満点にし、Haiku 4.5 は B で崩れました。逆に Fable 5 は A で取りこぼしていて、その中には A4 のりんご問題での、Haiku と同じ誤答が含まれます。
強いモデル同士の比較では、総点はこの質の差を隠してしまうんですよね。224点という見出しは立派ですが、それだけでは現場で使うかどうかの判断材料として足りません。
B6 を完答し、決定木の筋まで通した
いちばん印象に残ったのは B6 です。12枚の偽コインを天秤3回で見つける問題で、Haiku 4.5 は場合分けの木(決定木)が途中で自己矛盾して失点しました。Fable 5 はそこをきれいに通しています。
Fable 5 は、1回目に「1,2,3,4 vs 5,6,7,8」、2回目に混ぜ替えて「1,2,5 vs 3,4,6」という流れを組み、3^3 = 27 > 24 という情報量の根拠まで説明しました。当てにいったというより、問題の制約を見て解き方の骨格から組み立てた答えです。論理の筋の通し方については、最上位の段にふさわしい強さだと言っていいと思います。
C6 では正解集のほうが間違っていて、Fable 5 が正しかった
実務的にいちばん価値があったのは、ここでした。
C6 はメールアドレスの正規表現(文字の並びのパターンを書く記法)の問題です。旧正解集では「4,5,6 がマッチしない」としていましたが、Fable 5 は「[email protected] はマッチする」と指摘しました。理由は明快で、正規表現
^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$
の [a-zA-Z0-9.-]+ に . が含まれているため、[email protected] がこの部分に一致してしまいます。
Python の re で実際に動かして確かめたところ、Fable 5 が正しく、マッチしないのは 5,6 だけでした。このバグは 2026-04-11 に Haiku 4.5 を採点した時点からあり、2ヶ月近く誰も気づいていませんでした。正解集は訂正済みで、Haiku の過去スコアも Issue #50 で再判定し、C6 を 10→7点に直しています(合計 224→221)。
これは「モデルが賢かった」で終わる話ではありません。LLMLLM(大規模言語モデル)大量の文章で学習し、人のように文章を読み書きできる大きな AI のモデル。詳しく → を採点の補助に使うと、正解集そのものが壊れていても素通りしてしまう。その危うさを、実例で見せてくれた形です。
A4 のりんご問題では、Haiku と同じ自信満々の誤答
一方で、最重要の発見もここにありました。A4 の「りんごを取った」問題で、Fable 5 は Haiku 4.5 とまったく同じ誤答を出しています。問題文の「取った」を素直に受け取りすぎてしまい、文脈上は「花子が持っている」とは言い切れないのにそう答えました。正解は「4. わからない」です。
自信満々に間違える問題は、最上位モデルでも残る、ということです。Haiku+Advisor の記事の続きとして読むと分かりやすくて、Advisor(別の強いモデルに助言させる仕組み)を足してもすり抜けたタイプの誤答は、モデルを上げても消えきりませんでした。
高いモデルに替えれば曖昧な文の読み違いも直る、と期待したくなる気持ちは分かります。でも、高いモデルは曖昧文の直感バイアスを自動で消してくれるわけではありません。ここは足元を見ておきたいところです。
224 と 229 の差は、採点のブレの範囲
正直、ここは少し迷いました。同じ誤答に対して、採点がぶれるからです。
A4 の同じ誤答に、Haiku のときの採点は5点、今回の Fable 5 は0点でした。LLM に採点させると、±5点程度の判定ブレが出るということです。なので、Fable 5 の 224/240 と、A4 を Haiku のときの基準で採点し直した 229/240 の差は、厳密には誤差の範囲と見るべきです。
24問ベンチは便利ですが、1〜2問の採点ブレで印象が変わることがあります。順位より「どの問題で、どんな崩れ方をしたか」を見たほうが、実務には役立ちます。
測り方:回答者は Fable 5、採点官は Sonnet
自前のベンチマークは、やり方を隠すとほとんど意味がありません。どう測ったか分からない点数は、判断材料として弱いからです。今回の条件は次のとおりです。
- テスト日: 2026-06-10
- Claude Code の Agent ツールを使用
model:"fable"のサブエージェントを24問並列起動- 各問は独立コンテキスト
- ツール使用は禁止
- オーケストレーター自身も Fable 5 を使用した自己ベンチマーク構成
- 採点官は前例と同じ Sonnet の Agent ツール
- C6 のみ Python
reで実機再検証 - ルールベース採点は使っていない
- 結果正本:
data/benchmark-results/fable-5-20260610.json
サブエージェントは、親の AI から仕事を任される子の AI のことです。今回は1問ごとに別々の会話として立ち上げています。
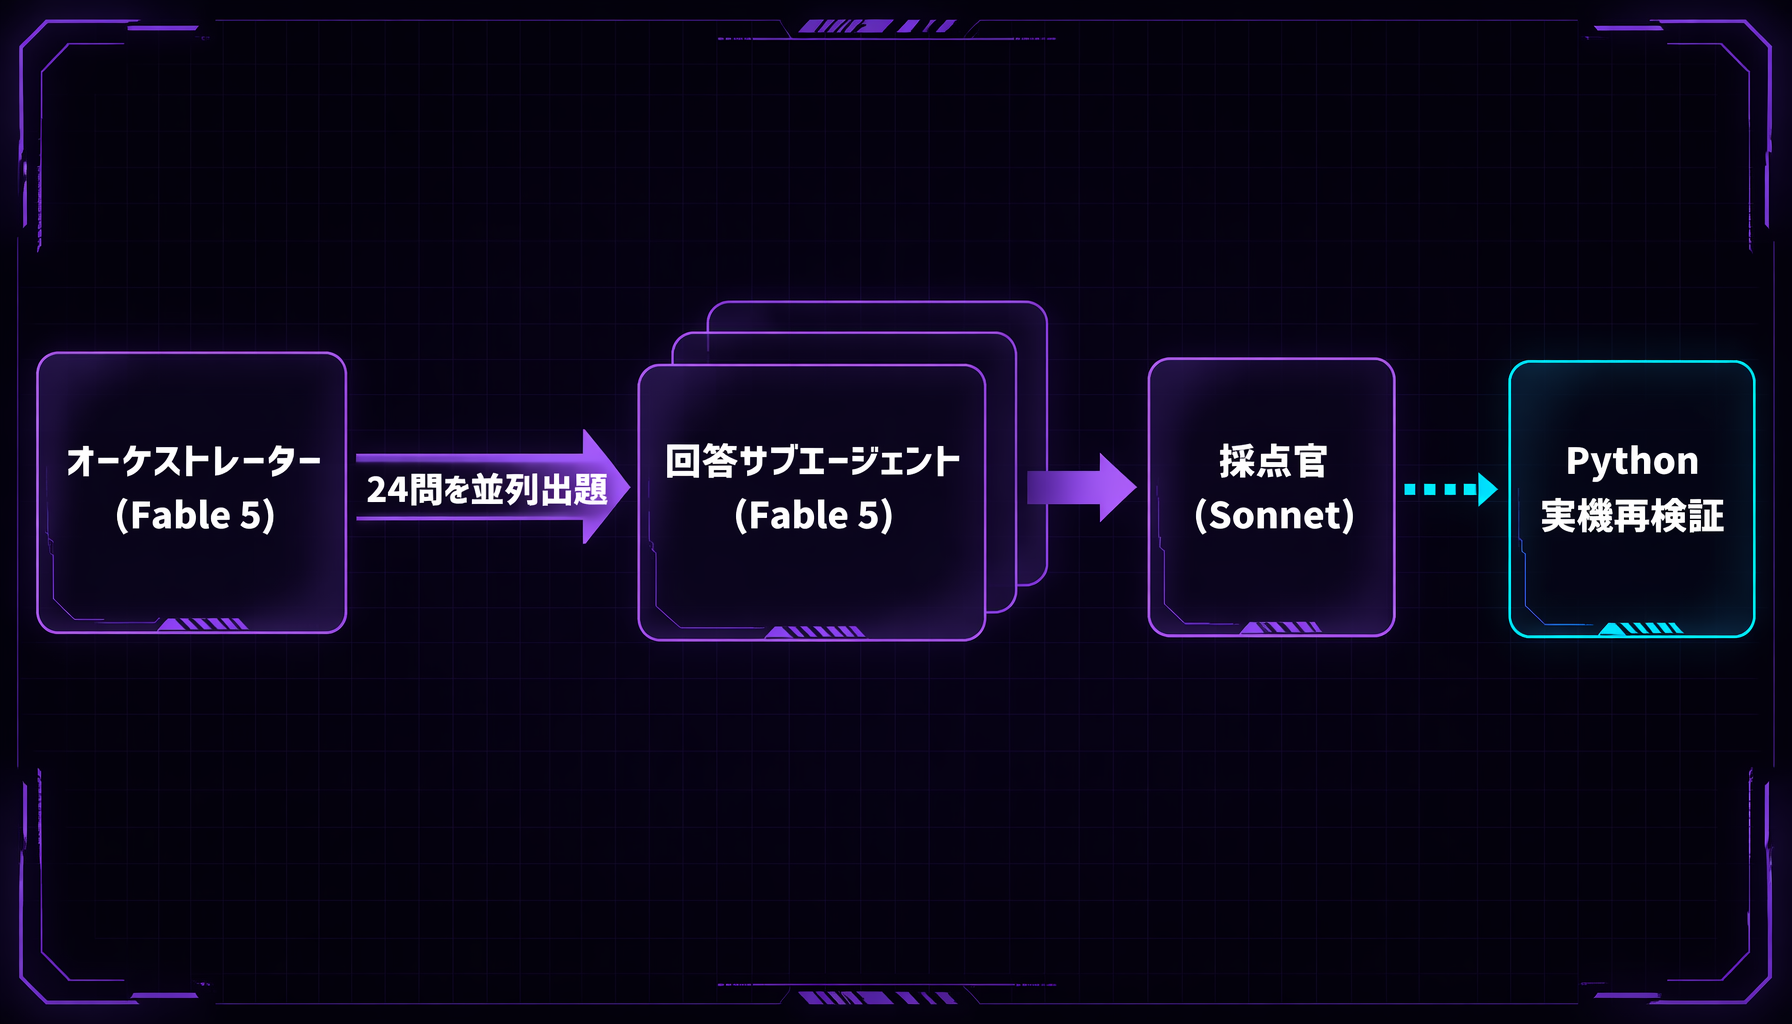
検証構成: 出題・回答・採点・再検証を別々の役割に分離した(回答者と採点官は別モデル)
僅差なのに別物。使うかどうかは用途で決まる
総点では 224 対 221 の僅差でも、使い心地はかなり違うはずです。Fable 5 は論理の深い問題をきれいに通し、既存の正解集の誤りまで見つけますが、曖昧な文の直感的な誤答は残します。Haiku 4.5 は一部の問題で総崩れしつつ、別の領域では同じ点数まで持っていきます。これは総点ベンチマークの限界そのものです。
Opus 4.8 から替えるかどうかは、用途次第です。少なくとも今回の24問では、最上位らしい強さがあり、特に論理問題とバグ発見は強かった。ただ、A4 のような曖昧文の誤答は残るので、「何でも正しくなる」モデルではありません。
6/22 までの無料期間に試すかと聞かれたら、Claude Code ユーザーなら試す価値はあると思います。コードレビュー、根拠付きの推論、既存の成果物の矛盾チェックをよくやる人ほど、差が見えやすいはずです。逆に、単発の雑談や軽い要約が中心なら、料金差に見合うかは微妙なところです。
試すなら、まず自分の実務に近い少数の問題で確かめてみてください。コード、仕様、レビュー、曖昧な文の解釈。そこで何が伸びて、何が残るかを見るのがいちばん確実です。
スコアを見るときの但し書き
- スコアはテスト設計と採点基準に依存します。他のベンチマークと単純比較はできません。
- LLM採点には±5点程度の判定ブレがあります。1〜2問差での優劣判断は避けてください。
- 料金・提供条件は2026-06-10時点のものです。6/23以降は条件が変わるため、最新の公式情報を確認してください。
- 自分の用途で試すまで、スコアだけで導入を決めないほうが安全です。
- 公式ベンチや発表資料も参考になりますが、自分の用途に近い実測とセットで見るのが安全です。この記事では、未確認の二次情報は採用していません。
合わせて読むと流れがつながる記事
Claude 製品同士を無理に持ち上げるつもりはありません。ただ、どこで差が出て、どこでは差が出ないかを見るには、こういう並びが役に立ちます。
- 24問の設計そのものを知りたいなら: /blog/local-llm-benchmark-24-questions-explained
- Haiku+Advisor の流れを追いたいなら: /blog/claude-haiku-advisor-opus-benchmark-2026
- 低コスト側の比較を見たいなら: /blog/bonsai-8b-1bit-llm-benchmark-24q-2026
参考リンク
- 公式発表: https://www.anthropic.com/news/claude-fable-5-mythos-5
- 24問解説: /blog/local-llm-benchmark-24-questions-explained
- Haiku+Advisor 記事: /blog/claude-haiku-advisor-opus-benchmark-2026
- Bonsai-8B 記事: /blog/bonsai-8b-1bit-llm-benchmark-24q-2026
- 提供条件・API仕様: https://platform.claude.com/docs/en/about-claude/models/introducing-claude-fable-5-and-claude-mythos-5
- サブスク提供期間の報道: https://techcrunch.com/2026/06/09/anthropic-released-claude-fable-5-its-most-powerful-model-publicly-days-after-warning-ai-is-getting-too-dangerous/
この記事は、実務で AI ツールを活用している開発者・技術者向けに書いています。
この記事を書いた人
HW系エンジニアとして20年以上、10,000件を超える顧客訪問と2,000件を超える単独ソリューション実績。AIツールを使った個人開発やIoT農園など、Raspberry Piを使ったオートメーション化なども実践中です!エンジニア専門結婚相談所も運営中、ClaudeCodeで解決できない心の課題も解決いたします!
関連記事

Anthropicリーク2連発:Claude MythosとClaude Code流出で見えたKAIROS、BUDDY、Undercover Modeの正体
Anthropicの2週間で2回のリークを整理。Claude Mythosの位置づけ、Claude Code流出の中身、KAIROS/BUDDY/Undercover Modeの意味を分けて読む。
Claude Opus 4.8 は何が変わった?ベンチより「正直さ」と並列エージェントが本命だった
Claude Opus 4.8 で本当に変わったのは、ベンチの数ポイントではなく『正直さ』と並列サブエージェントでした。公式ベンチ、4つの新機能、OpenRouter の実トラフィックを重ねて、価格据え置きの今回のアップデートを乗り換え目線で整理します。

effort を途中で変えるとキャッシュはどうなる? Fable 5.1 と Opus 5 で実測した
Fable 5.1 の値下げはキャッシュ読みだけ。Claude Code が TTL を決める仕組み、キャッシュを壊す操作と壊さない操作、effort 切替時の再書き込みを Fable 5.1 と Opus 5 の usage で実測しました。
Sonnet 5.5 xhighは買いか、Claude Opus 5.5 mediumが得か
Claude Sonnet 5.5のeffort別実測と公式指針を整理。Sonnet 5からの破壊的変更、Opus 5.5との費用差、mediumの使いどころを解説します。
META-MARK × AI
ローカルAIを動かすGPU、ちゃんと選べていますか?
VRAM・性能・コスパをMetaScoreで数値化。AIアプリ別の推奨ハードウェア要件も確認できます。
PR広告:開発環境・キャリアまわりのサービス
 シンVPSを見る
 XServer VPSを見る
 strategy career の転職支援を見る